
SKILLRET:当 Agent 拥有过万技能,检索成了通往 SOTA 的最后一公里
SkillRet: A Large-Scale Benchmark for Skill Retrieval in LLM Agents
总结
问题
方法
结果
要点
摘要
本文推出了 SKILLRET,这是一个针对 LLM Agent 技能检索的大规模基准测试集。该基准包含 17,810 个真实技能、63,259 条训练数据及 4,997 条评估查询,通过任务特定的微调,将最强基线的 NDCG@10 提升了 13.1 至 16.9 个百分点。
## TL;DR
随着 LLM Agent 逐渐演变为拥有庞大“技能库”的复杂系统,如何在毫秒内从数万个脚本、提示词和工作流中选出最正确的一个?ThakiCloud 研究团队发布的 **SKILLRET** 给出了答案:现有的通用检索模型在这一任务上几乎全线崩溃,而通过大规模特定领域的微调,检索精度(NDCG@10)最高可提升 16.9%。
## 痛点深挖:通用检索为何在 Agent 技能面前“失语”?
在学术界,我们习惯于用 MTEB 榜单来衡量 Embedding 模型的优劣。然而,SKILLRET 的研究发现,MTEB 的排名与 Agent 技能检索性能之间只存在微弱的相关性(Spearman ρ = 0.71)。甚至出现了 MTEB 霸榜模型在技能检索中表现不如参数量小得多的模型的情况。
**本质原因在于两个维度的不匹配:**
1. **文档长且复杂**:技能文档(SKILL.md)往往包含大量操作逻辑和约束,中位数长度达 1583 tokens,远超传统 Tool 检索。
2. **查询噪声密集**:用户给 Agent 发送的指令通常包含大量背景(Context)、格式要求和无关限制,真正的“技能信号”可能只隐藏在其中一两句关键指令里。
## 方法论详解:构建 Agent 技能的“图书馆”
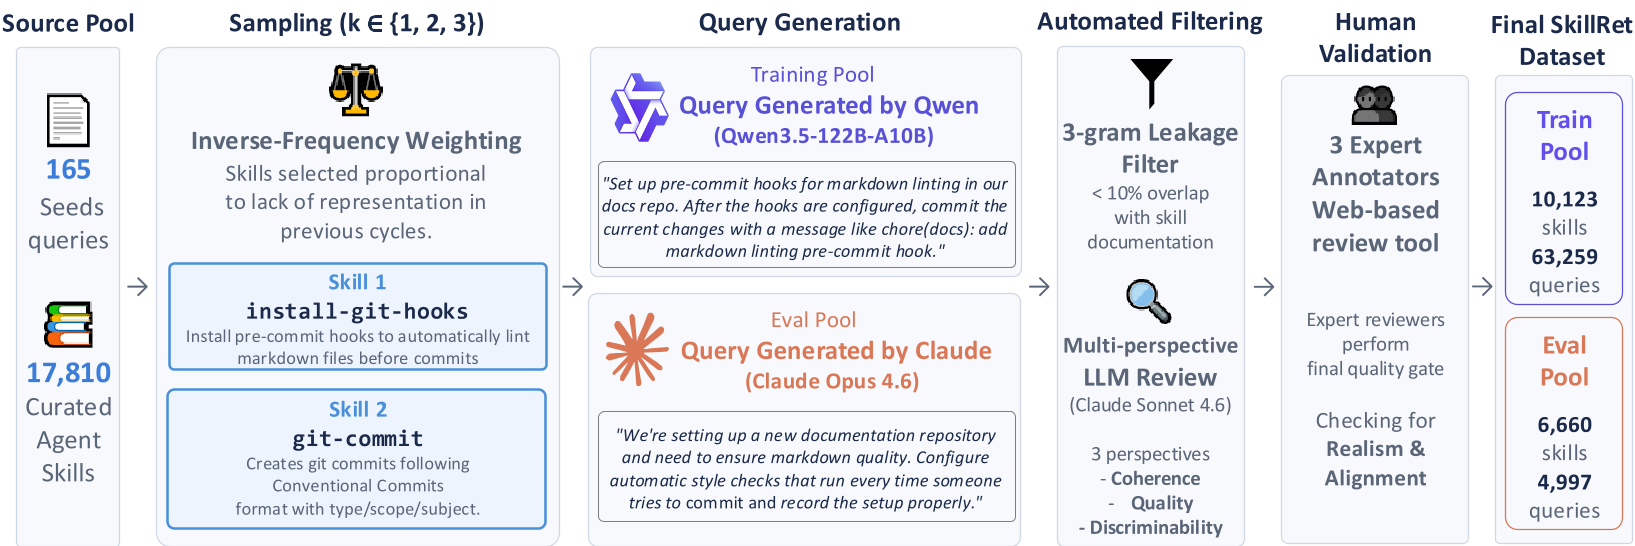
为了解决数据匮乏问题,作者构建了一个包含 **17,810 个公共技能** 的大规模语料库,并制定了严密的五阶段过滤流程。
### 层次化分类体系 (Taxonomy)
作者通过 LLM 辅助标注和聚类,构建了一个跨越 6 个大类(如软件工程、AI Agents、数据分析等)和 18 个子类的双向分类法。这不仅是为了组织数据,更是为了后续更精细地诊断不同领域检索的难易程度。
### 检索聚焦(Skill-Relevant Focus)
作者微调了 Qwen3-Embedding 系列模型。通过句子擦除分析(Sentence Erasure Analysis),研究发现微调后的模型展现出一种惊人的能力:它能自动忽略查询中的背景描述,而将权重(Importance)高度集中在决定技能调用的关键动作上。
## 实验与结果:微调才是硬道理
实验对比了包括 BM25, bge-large 以及最新的 NV-Embed-v1 等 18 种检索模型。
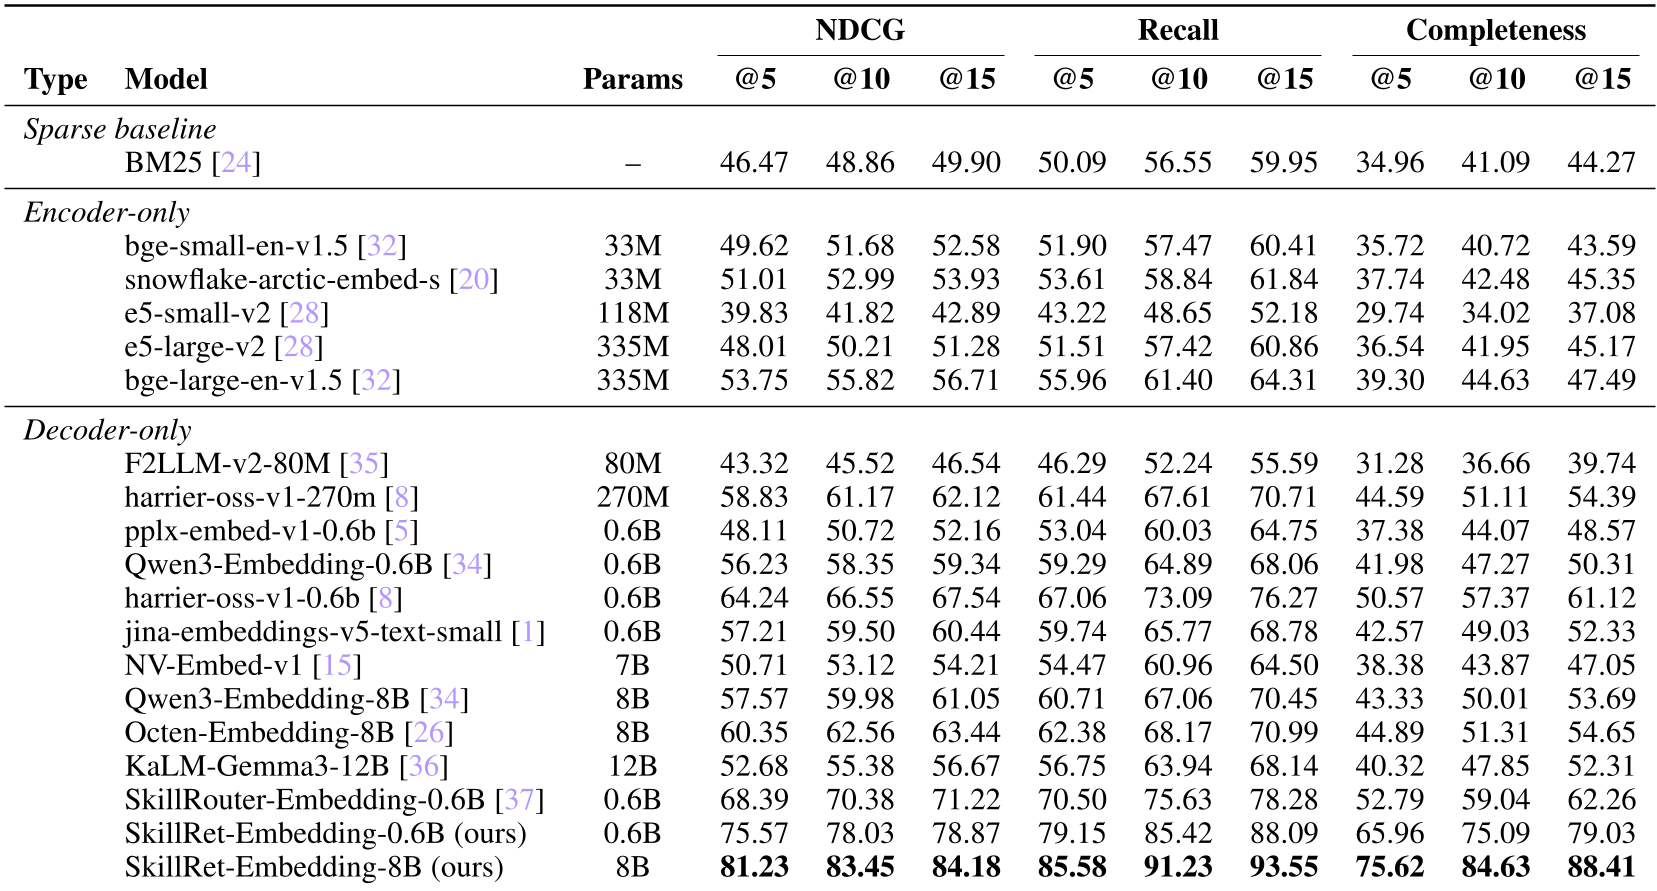
* **离谱的提升**:SkillRet-Embedding-8B 拿到了 83.45 的 NDCG@10,而最强的非微调模型仅能达到 66.55。
* **Reranking 的陷阱**:研究发现,如果第一阶段检索器已经足够强大,通用的 Reranker(如 jina-v2)有时反而会因为“领域不匹配”降低性能。
## 深度洞察:不同领域的难度差距
数据表明,不同类别的技能检索难度有着天壤之别。**信息检索(Info. Retr.)**和 **AI Agents** 相关的技能最难检索,即便强如微调后的模型,其 NDCG 也比最简单的 **Data & ML** 类别低了近 20 个点。这说明在高度抽象和高度相似的 Agent 描述之间进行区分,仍然是一个未竟的挑战。
## 总结与局限
SKILLRET 的出现标志着 Agent 研究正在从“对话能力”转向“系统级调度能力”。
* **优势**:它是目前最大的技能检索专有基准,提供了高质量的训练/测试集。
* **局限**:数据主要由 LLM 合成(虽然经过了专家审计),能否完全反映真实用户的混沌输入仍有待商榷。
对开发者而言,SKILLRET 提供了一个明确的信号:如果你在做垂直领域的 Agent,不要盲目迷信通用的 Embedding SOTA,基于业务技能库进行微调,才是实现高效调度的“白银子弹”。