
Skills-Coach:让 AI 智能体学会“自我进化”,突破技能边界
Skills-Coach: A Self-Evolving Skill Optimizer via Training-Free GRPO
本文提出了 Skills-Coach,一个旨在增强大语言模型(LLM)智能体 “技能” 自演化的自动化框架。该框架利用 Training-Free GRPO 技术,无需参数微调即可实现技能指令与代码的闭环优化,使智能体能自主探索并突破现有能力的边界。
TL;DR
在 AI Agent 领域,技能(Skills)是智能体连接现实世界的桥梁。然而,现有的技能大多是针对特定任务“硬编码”的,缺乏灵活性。近日发表的论文《Skills-Coach: A Self-Evolving Skill Optimizer via Training-Free GRPO》提出了一套全新的自动化框架,让 Agent 能够像教练一样,通过自主生成挑战性任务、自我反思和代码重构,实现技能的无监督自演化。实验证明,该方法能将技能通过率提升 50% 以上。
背景定位:碎片化的技能生态
目前 LLM 智能体生态(如 Clawhub, AutoGen)中存在数以万计的技能。虽然数量庞大,但这些技能往往是“局部最优”的——由个人开发者针对极窄的场景编写。当用户尝试处理多步骤、跨领域的复杂任务时,这些技能往往会因为缺乏鲁棒性或边界覆盖不足而失效。
核心动机:技能如何“自主”成长?
作者提出了三个关键直觉:
- 边界探测:如果想优化技能,必须先找到它的极限(边缘案例)。
- 轻量化反演:不需要动辄微调底层模型,通过优化 Skill 的指令说明(Skill.md)和底层逻辑代码即可实现显著提升。
- 闭环反馈:建立一套从“任务生成 -> 灰度测试 -> 失败分析 -> 自动修复”的完整闭环。
技术架构:Skills-Coach 的四重奏
Skills-Coach 的工作流程极具系统性,它摒弃了盲目试错,转而采用一种更科学的演化机制。
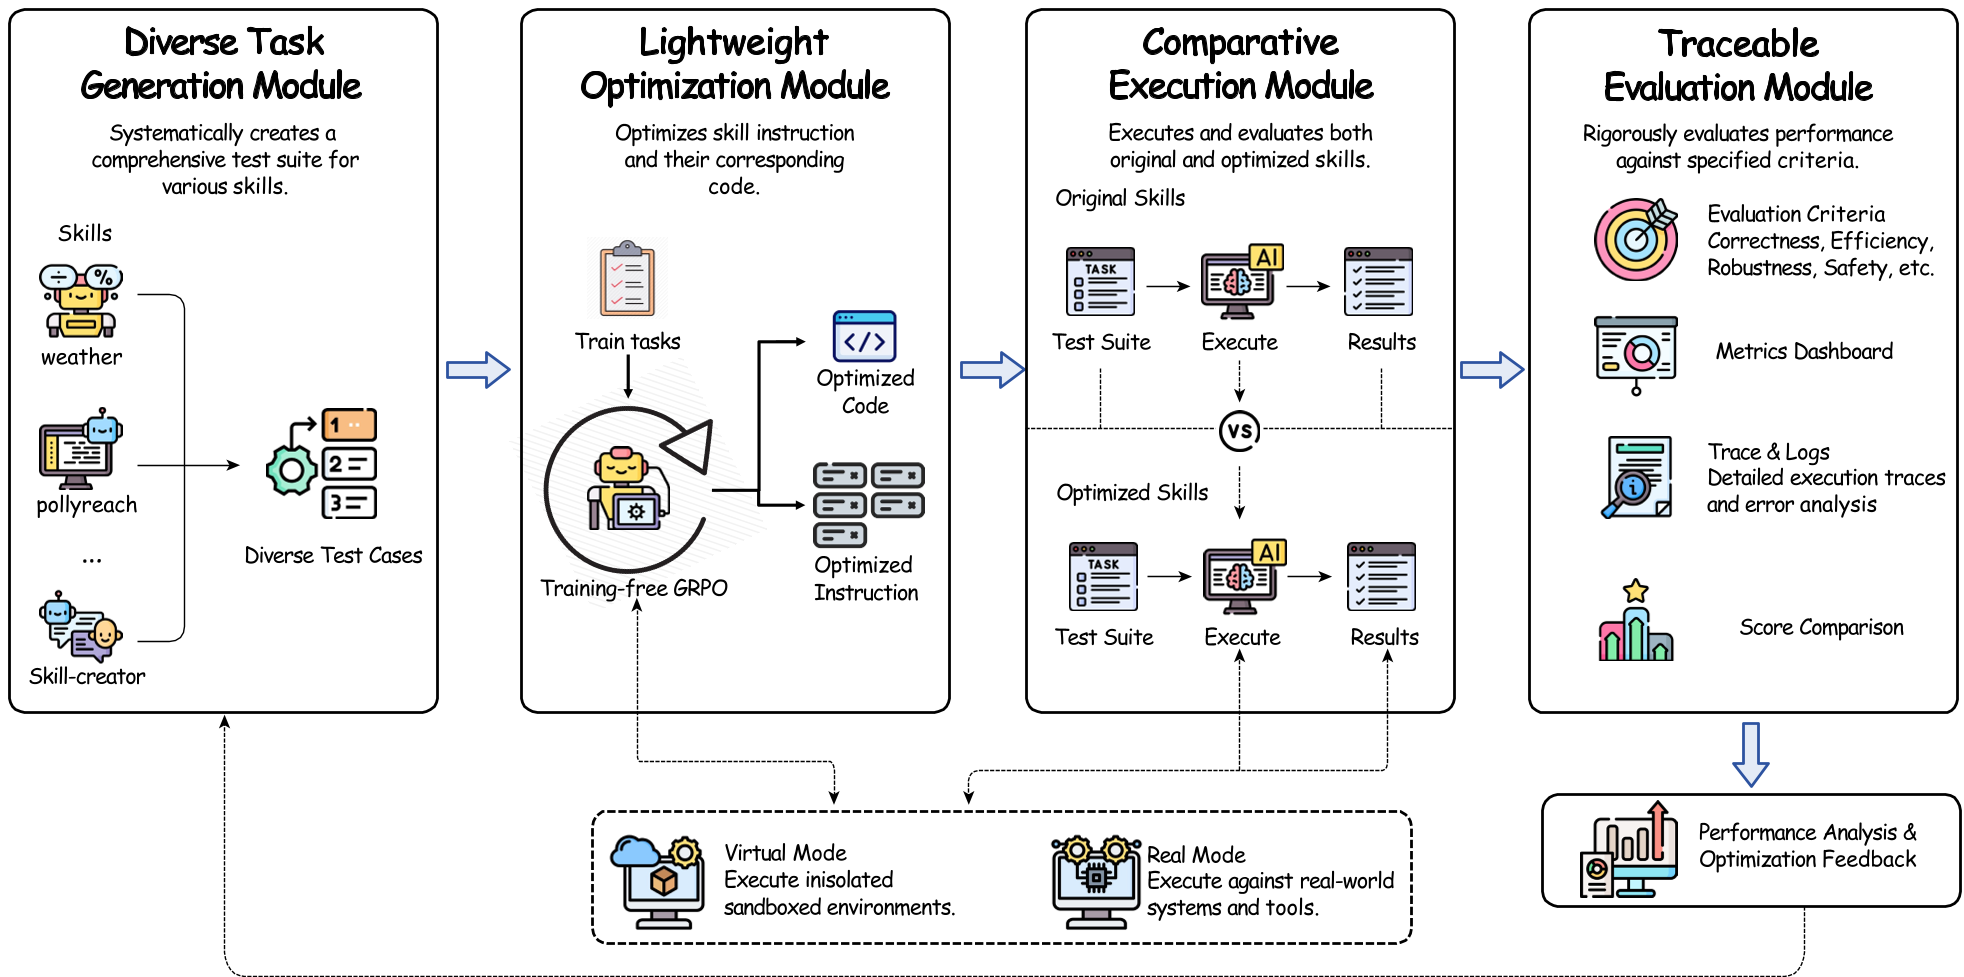
1. 多样化任务生成 (Diverse Task Generation)
该模块解析技能规格,通过层次化策略生成三类任务:
- 标准任务:常规操作。
- 高级任务:多步工作流。
- 边缘/边界任务:探测参数极值、无效输入、资源约束等。
2. 轻量化优化模块 (Lightweight Optimization)
这是该框架的灵魂。它采用了 Training-Free GRPO (组相对策略优化)。
- 指令优化:针对
Skill.md生成多个变体,通过对比学习选出逻辑最清晰的版本。 - 代码优化:引入自动修复机制(Auto-fixer),针对执行日志中的错误(如路径错误、依赖缺失、逻辑漏洞)进行自动补丁编写。
3. 对比执行与可追溯评估
系统在虚拟(模拟验证)或真实环境(实际部署执行)中运行原始和优化后的技能。这种对比实验确保了所有提升都是“实打实”的,避免了 LLM 的幻觉导致虚假性能提升。
实验战绩:全维度压制
为了验证效果,作者发布了包含 48 个真实技能的 Skill-X 基准集。结果显示,优化后的技能在各项指标上实现了翻倍增长:
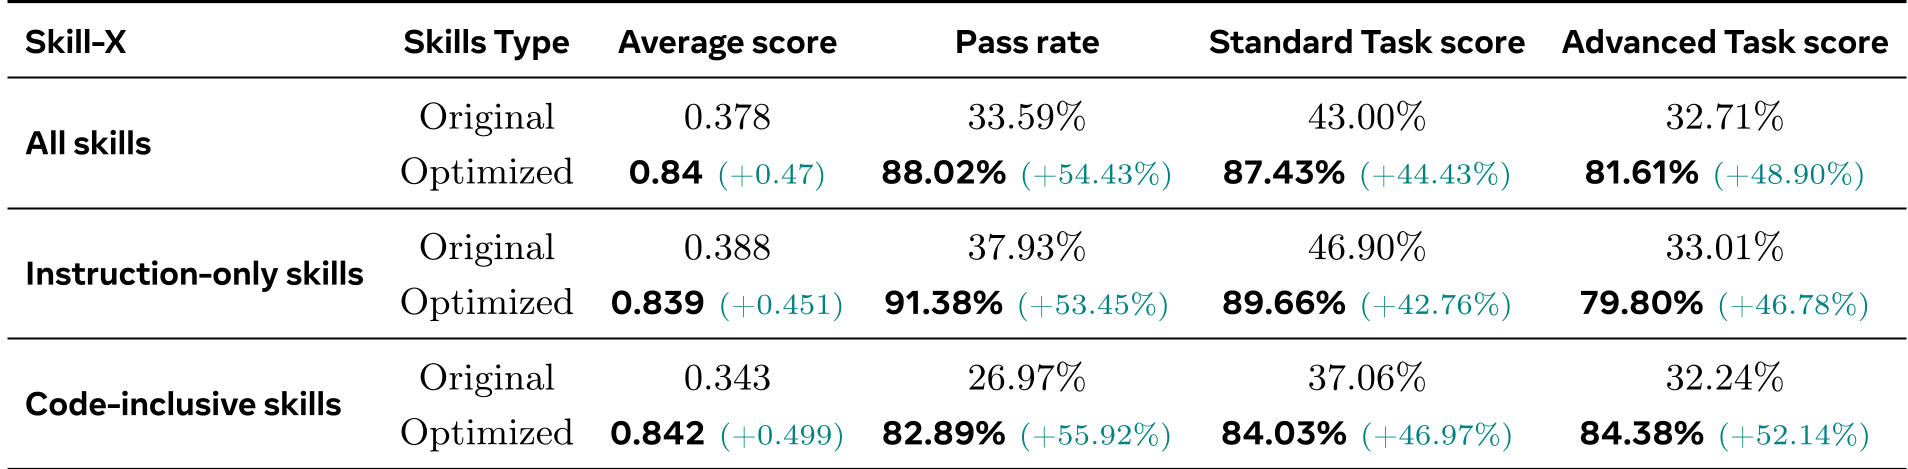
- 代码型技能表现卓越:在需要复杂逻辑推理的代码密集型技能中,通过率提升尤为明显。
- 高级任务攻克:相比简单任务,Skills-Coach 在原本极具挑战的“高级任务”上表现出了更强的爆发力。
深度洞察:为什么这种演化能成功?
Skills-Coach 成功的关键在于它模拟了人类编写代码的典型模式:写代码 - 跑测试 - 看报错 - 修 BUG。 相比于传统的 SFT(有监督微调),Training-Free GRPO 的成本极低:训练时间从数小时缩短至几分钟,且对高质量数据的依赖量从上千条下降到几十条。这为 LLM Agent 在端侧或垂直工业场景的实时进化提供了技术路径。
局限性与展望
尽管表现惊人,但 Skills-Coach 对于本身已经接近完美的技能(如实验中提到的 admapix)提升空间有限。未来,如何平衡优化资源的投入产出比,以及如何处理多个技能在协同进化过程中的冲突,将是智能体领域另一个迷人的课题。
总结: Skills-Coach 不仅仅是一个优化器,它展示了未来 AI 智能体的一种生存方式——在不断的自我挑战与反思中,实现从“能用”到“好用”的跨越。