
[CVPR 2025候选] SlotVTG:打破 MLLM 的“视觉捷径”,实现泛化性视频时间定位
SlotVTG: Object-Centric Adapter for Generalizable Video Temporal Grounding
本文提出了 SlotVTG,一种针对多模态大语言模型(MLLMs)的轻量级对象中心化适配器,旨在解决视频时间定位(VTG)任务中的域外(OOD)泛化问题。该方法通过 Slot Attention 将视觉映射分解为实体级 Slots,并在保持高效推理的同时实现了 SOTA 性能。
TL;DR
尽管多模态大语言模型(MLLMs)在视频时间定位(VTG)任务上表现强劲,但它们极其容易陷入“捷径学习”(Shortcut Learning)的陷阱——即记住特定的数据分布而非理解视觉内容。本文提出的 SlotVTG 通过一个轻量级的 Slot Adapter,将视觉表示分解为以对象为中心(Object-Centric)的 Slots,强制模型关注真实的视觉实体,从而在域外(OOD)泛化性能上取得了显著突破。
1. 痛点:被“偏见”误导的 MLLM
在 VTG 任务中,模型需要根据文本指令在长视频中准确定位起止时间。研究者发现,当把在 Charades-STA 训练的模型拿到 QVHighlights 数据集上测试时,模型表现大幅下滑。
作者通过一个有趣的随机扰动实验(Noise Perturbation)揭示了真相:
- 在域内(ID):模型确实在看视觉内容。
- 在域外(OOD):扰动目标区域和扰动随机区域导致的跌幅几乎一致。 结论:模型在处理陌生场景时,根本不在乎视觉内容,而是根据训练集里的统计偏好(比如“动作通常发生在视频中间”)在瞎猜。
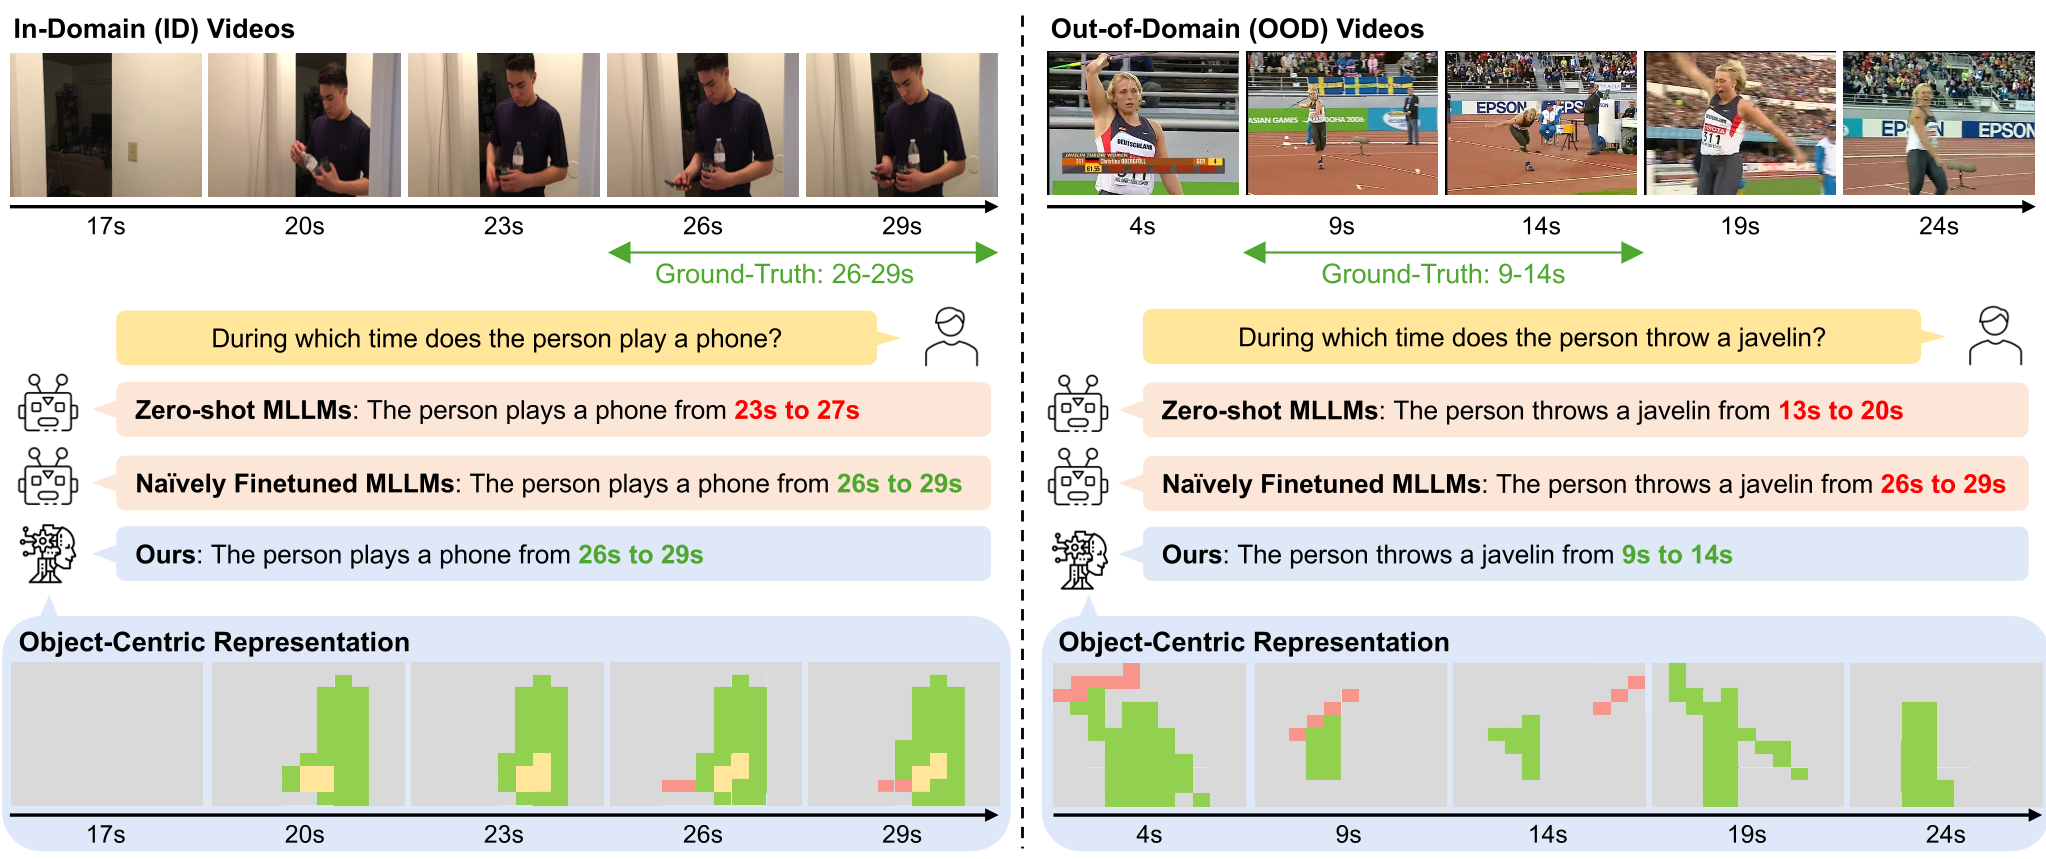
2. 核心方法:SlotVTG 架构解析
为了让模型学会“看图说话”而非“背诵规律”,作者引入了对象中心化学习。其核心思想是将杂乱的视觉 Token 聚类成具有物理意义的“Slots”。
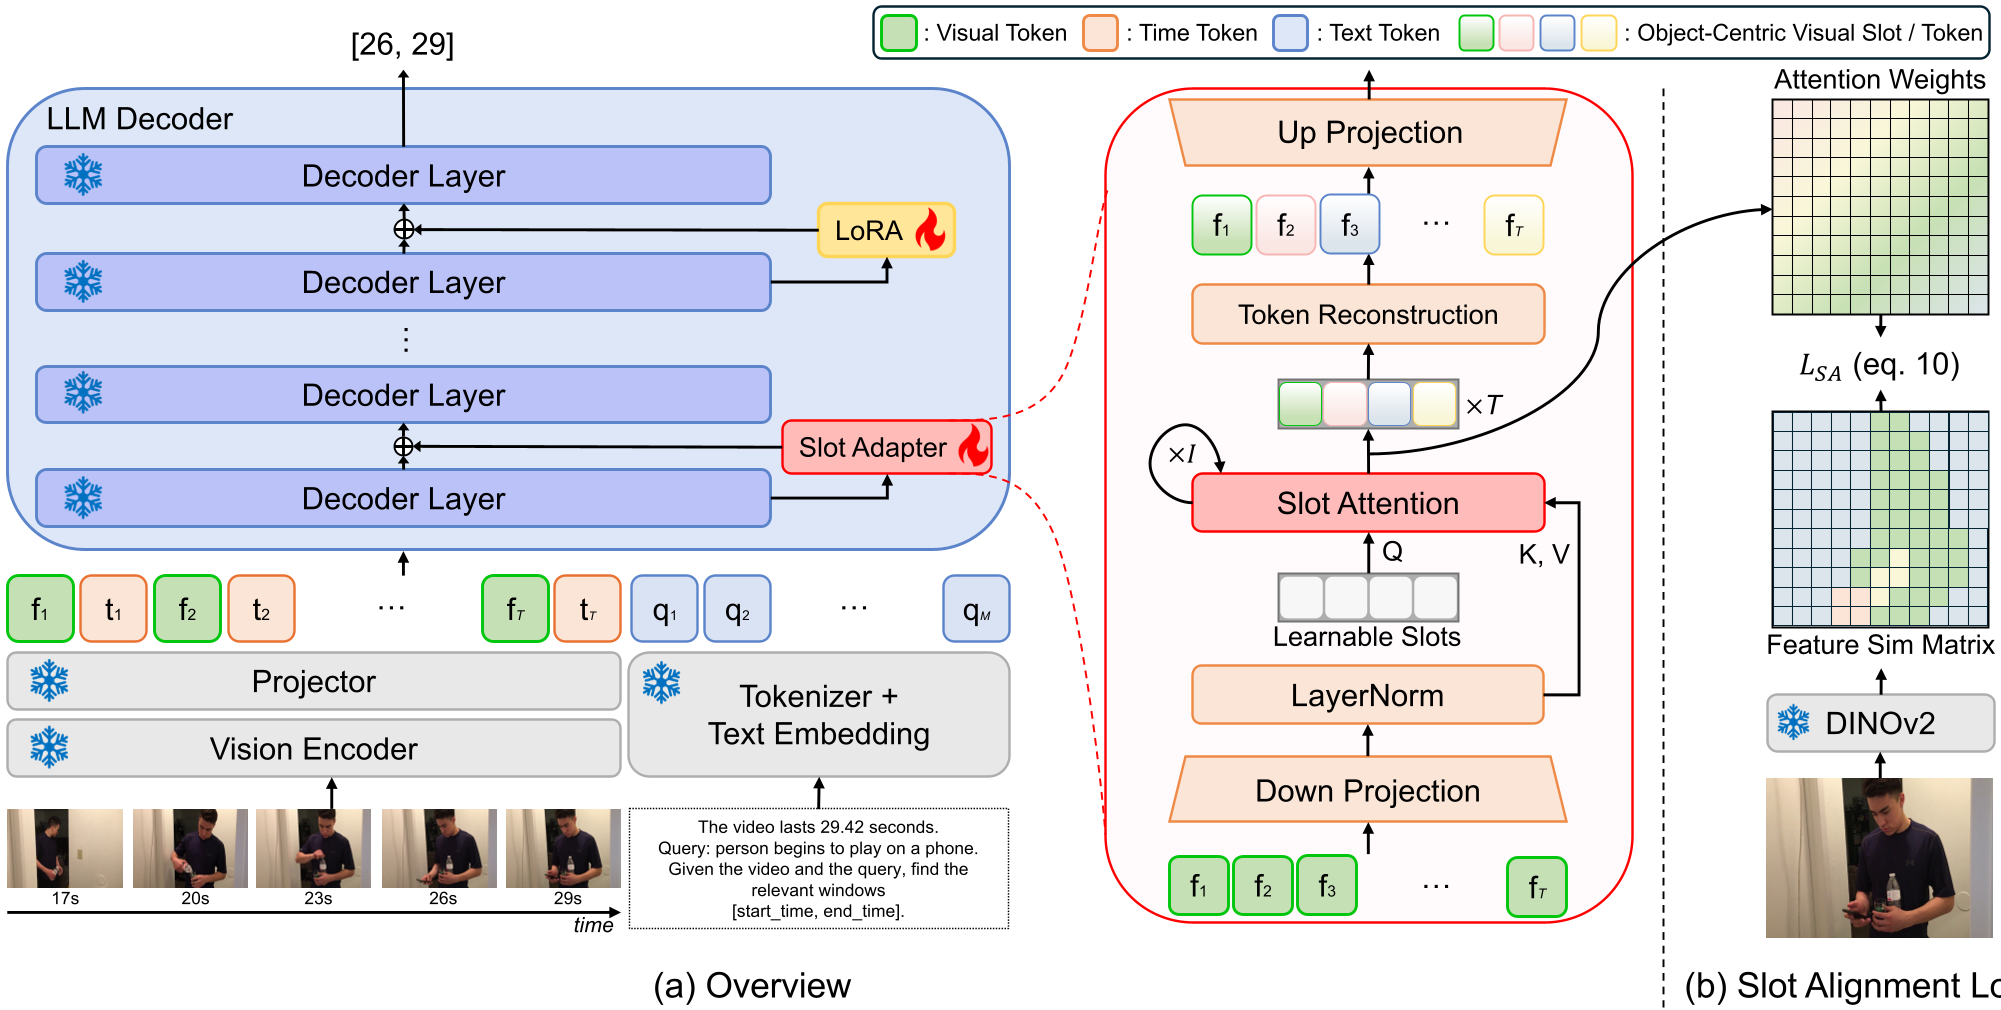
2.1 Slot Adapter
SlotVTG 不修改 MLLM 的主干,而是在解码器的前几层插入适配器:
- Down Projection:将高维 Token 降维到瓶颈空间。
- Competitive Attention:多个可学习的 Slot 查询向量通过 Slot Attention 互相竞争,争夺解释输入 Token 的权利。这种“竞争”迫使每个 Slot 锁定视频中的特定实体(如人、车、背景)。
- Token Reconstruction:利用 Cross-Attention 将这些实体化的信息回填到原始 Token 序列中。
2.2 Slot Alignment (SA) Loss
为了防止 Slots 变成随机的数学组合,作者利用 DINOv2 作为“导师”。DINOv2 这种自监督模型天生具备捕捉物体轮廓的能力。通过计算 Slot 注意力图与 DINOv2 特征相似度矩阵之间的一致性,模型被引导着去关注语义一致的区域。
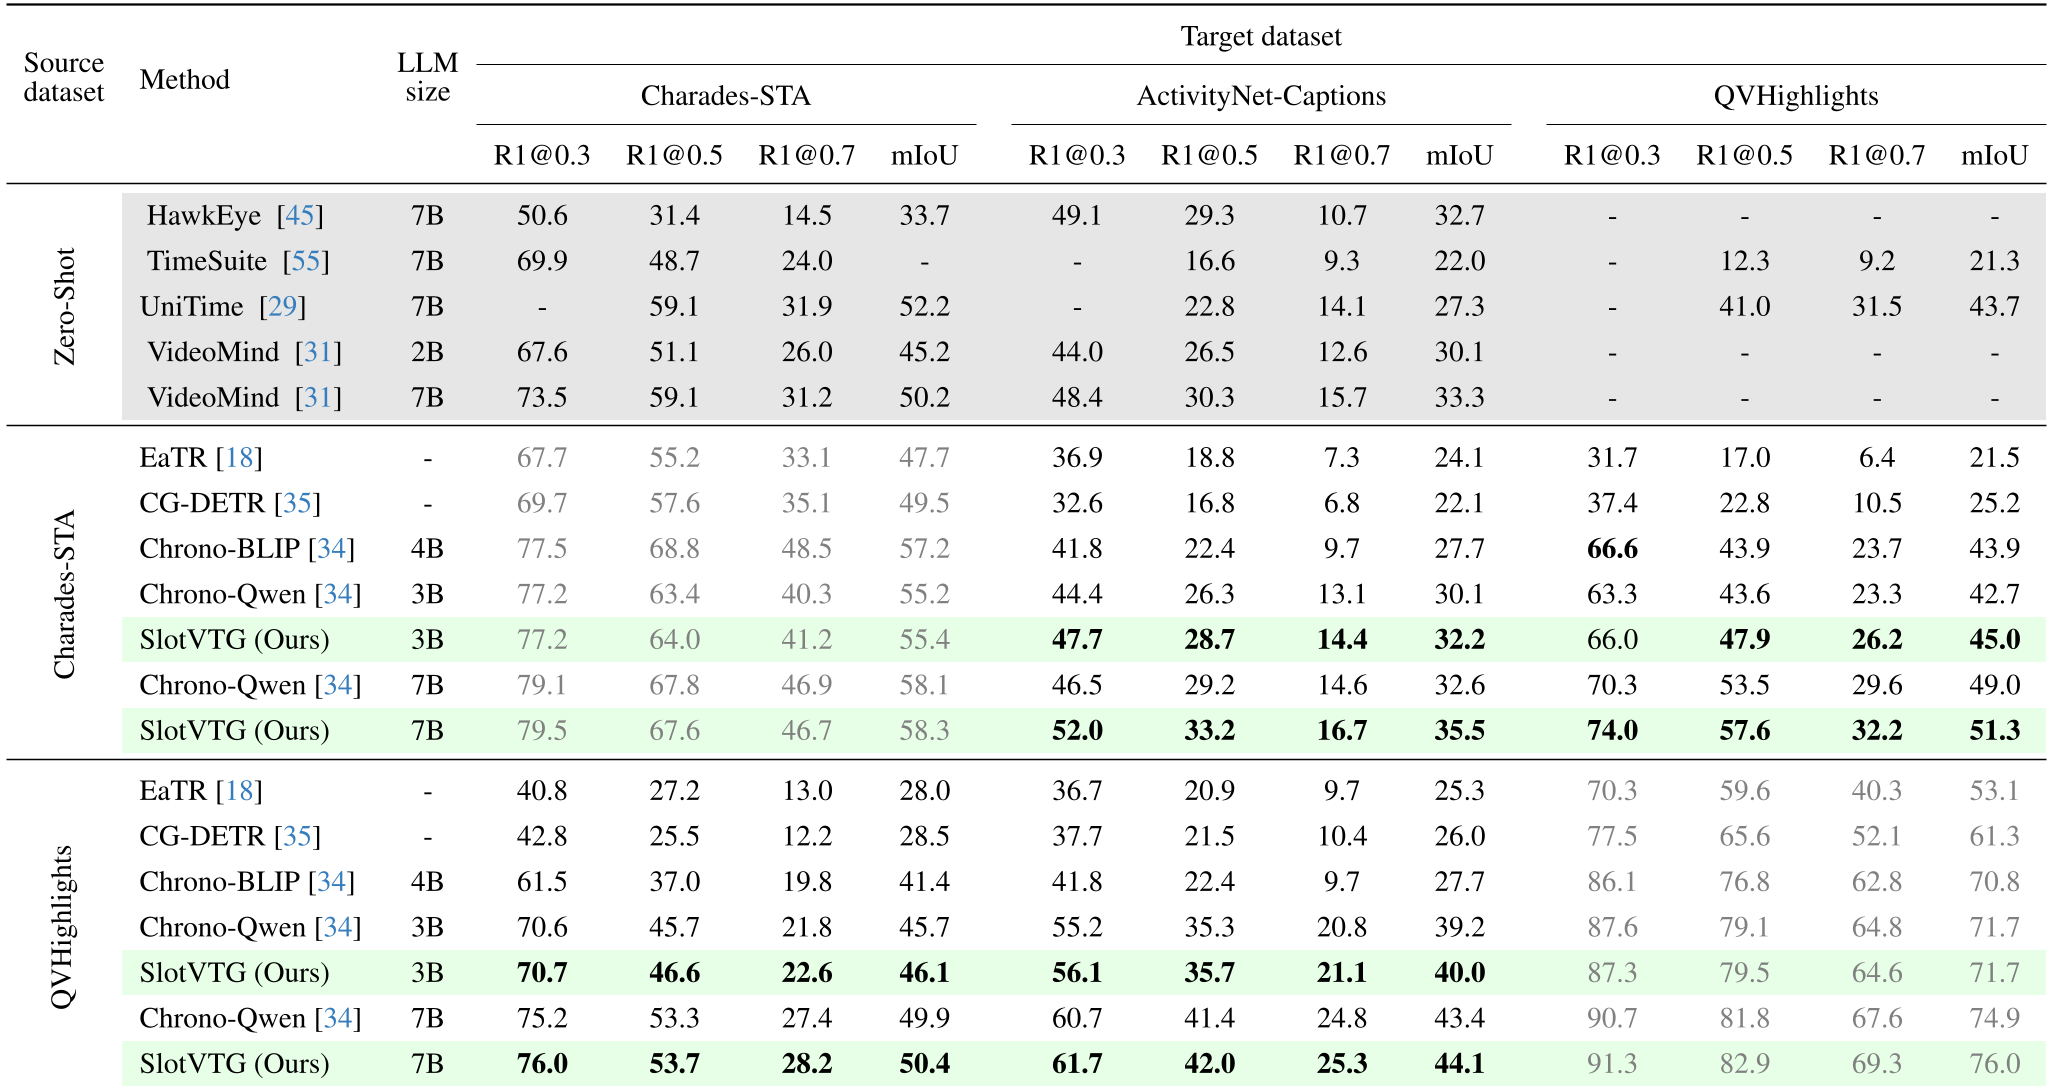
3. 实验结果:小参数带来的大飞跃
SlotVTG 展示了极高的参数效率:在 3B 和 7B 模型上,只需训练 0.3% 左右的参数,就能在跨域任务上超越全量微调的基线模型。
- 泛化性提升:在 Charades QVHighlights 任务中,R1@0.5 提升了 +4.3%。
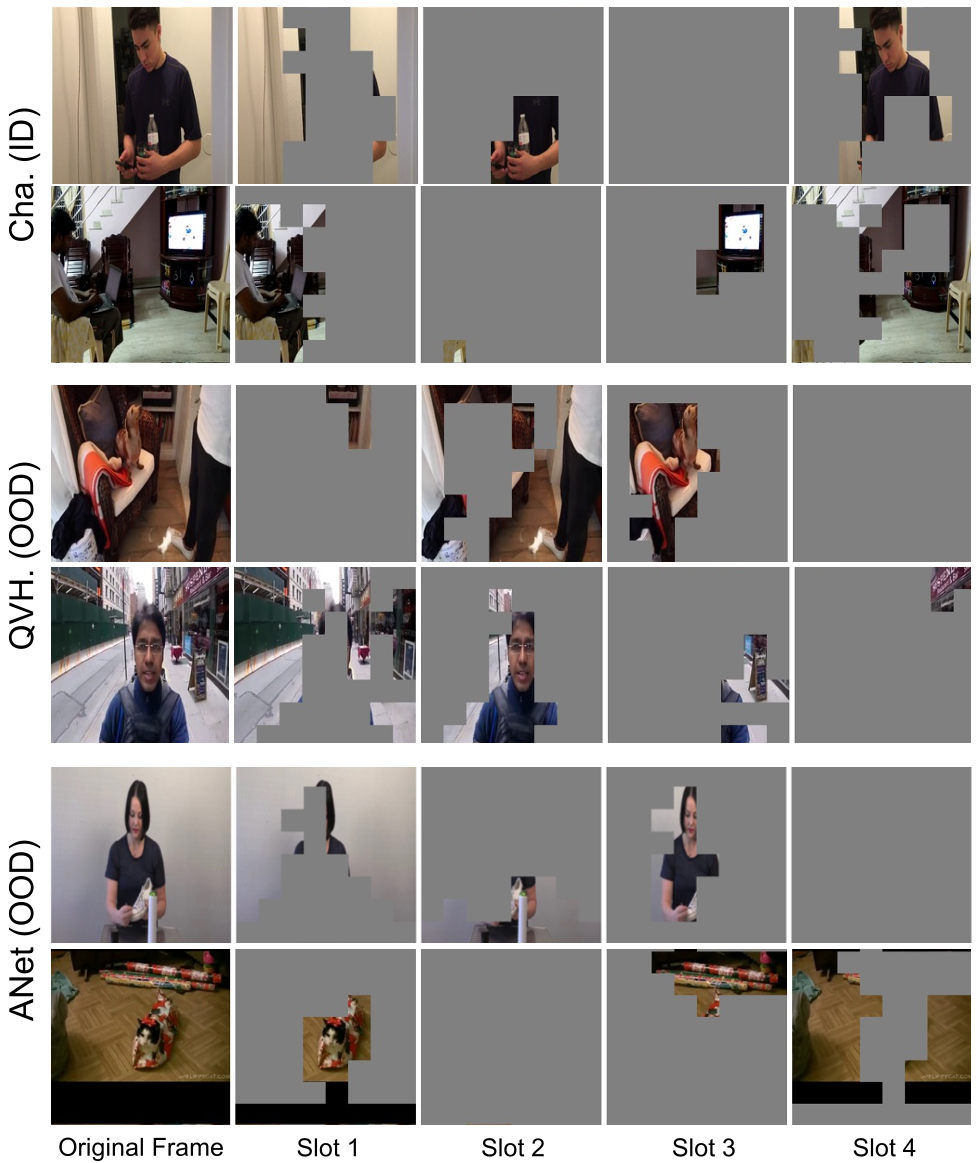
- 特征解耦:从可视化结果可以看到,模型确实学会了在不同 domain 下稳定地提取“人”、“手持物体”等关键实体。
4. 深度洞察
为什么 SlotVTG 有效?
- 特征对齐:通过 MMD 距离分析,Slot 化的表示将源域和目标域的特征距离拉近了约 50%。这说明对象层面的语义(Object-level semantics)比像素层面的模式更具普适性。
- 早期介入:实验表明,将适配器放在解码器早期(1-7层)效果最好。这是因为早期层负责跨帧的视觉特征交互,而后期层更多负责语言生成。
5. 总结与展望
SlotVTG 为 MLLM 的鲁棒微调提供了一个新范式:通过归纳偏置(Inductive Bias)引导大模型避开容易过拟合的统计捷径。
虽然目前仅在 VTG 任务上验证,但这种“视觉 Token 实体化”的思想非常适合扩展到长视频理解、多模态追踪等更复杂的推理场景中。未来的研究可以探索如何动态调整 Slot 的数量,以应对不同复杂度的视频场景。
Takeaway: 在视觉大模型的时代,有时候“做减法”(信息瓶颈与分解)比单纯“做加法”(堆数据)更能带来真实的智能。