
SOD:让 0.6B 小模型在 AIME 数学竞赛中“逆天改命”的分步蒸馏术
SOD: Step-wise On-policy Distillation for Small Language Model Agents
本文提出了 SOD (Step-wise On-policy Distillation),一种专为小语言模型 (SLM) 设计的分步在线蒸馏框架。通过引入“步级散度分数”动态调整蒸馏强度,SOD 在数学 (AIME 2025)、科学和代码等多项挑战性任务中显著提升了轻量级智能体的工具集成推理 (TIR) 能力,最高提升达 20.86%。
TL;DR
在 AI 智能体(Agent)领域,将庞大 LLM 的能力“压缩”进端侧小模型(SLM)一直是行业圣杯。然而,传统的蒸馏方法在面对**工具集成推理(TIR)**任务时往往会因为一个微小的工具调用错误而导致整个推理链条“雪崩”。本文提出的 SOD (Step-wise On-policy Distillation) 通过一种精妙的“步级加权”机制,巧妙解决了这一痛点,让 0.6B 的袖珍模型也能在 AIME 2025 等高难度数学竞赛中展现出惊人的推理力。
1. 痛点:Agent 蒸馏中的“差之毫厘,谬以千里”
在传统的文本推理中,学生模型的偏移通常是平滑的。但在 Agent 场景下,推理涉及与外部工具(如 Python 解释器)的交互。这带来了一个致命问题:不连续的状态转移。
- 错误级联 (Cascading Errors):如果一个小模型在第一步生成了一个错误的 Python 函数调用,它得到的将是一个错误或异常(Observation)。
- 教师失准 (Teacher Unreliability):此时,即使是强大的教师模型,在面对这样一段“崩坏”的上下文时,其预测的 Token 也不再具有指导意义。
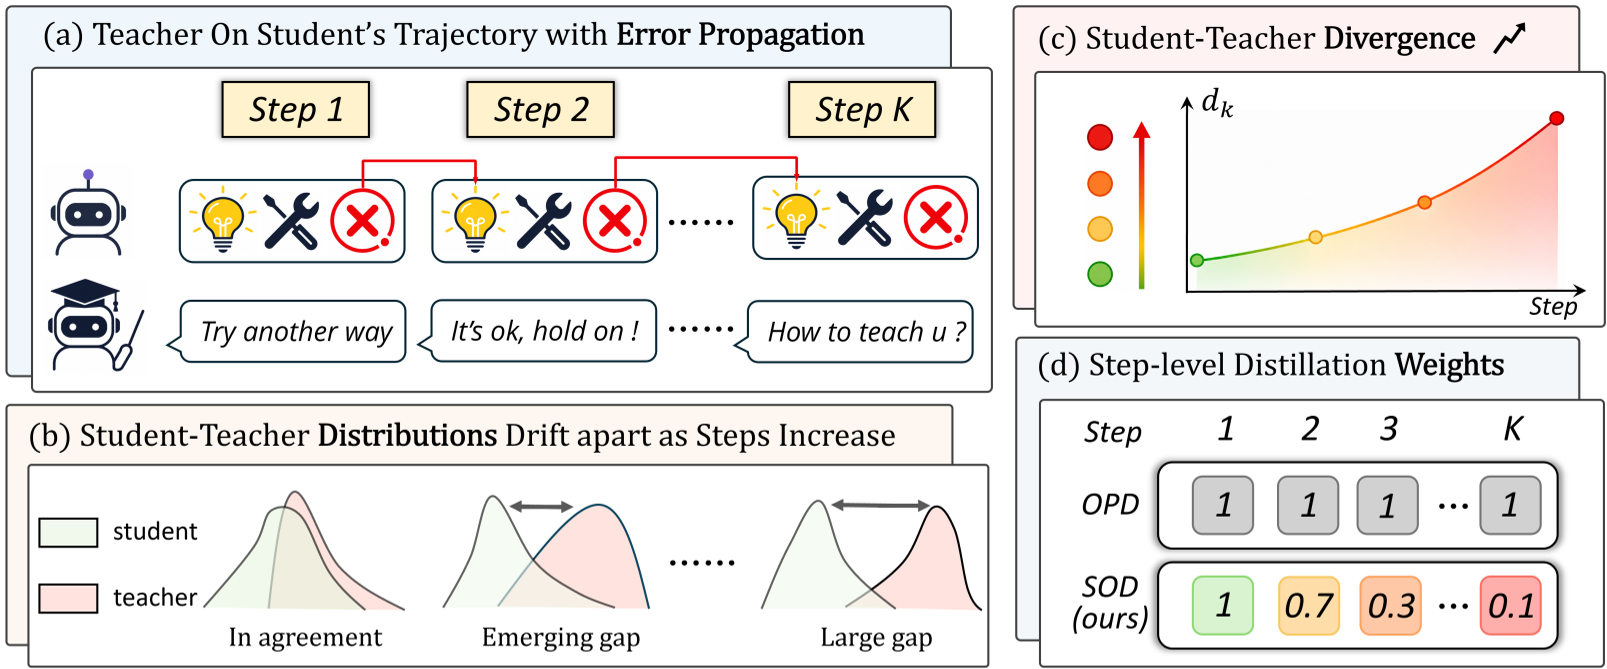
如下图 (a) 所示,在 TIR 任务中,学生与教师的散度(Divergence)会随着错误累积呈超线性增长。

2. 核心机制:SOD 的分步自适应重加权
为了解决这一问题,作者提出了 SOD (Step-wise On-policy Distillation)。其核心逻辑不再是“死磕”教师的每一个 Token,而是通过计算步级散度分数 () 来判断当前的监督是否靠谱。
2.1 散度量化
在每一个推理步骤 ,SOD 计算学生与教师的 log 概率差异:
2.2 动态权重公式
基于散度比率计算权重 :
- 如果 激增,说明学生已“跑偏”, 减小,屏蔽该步的蒸馏信号。
- 如果学生成功从错误中复原(Recovery Pattern), 减小, 相应增大,恢复监督。
3. 三种蒸馏范式
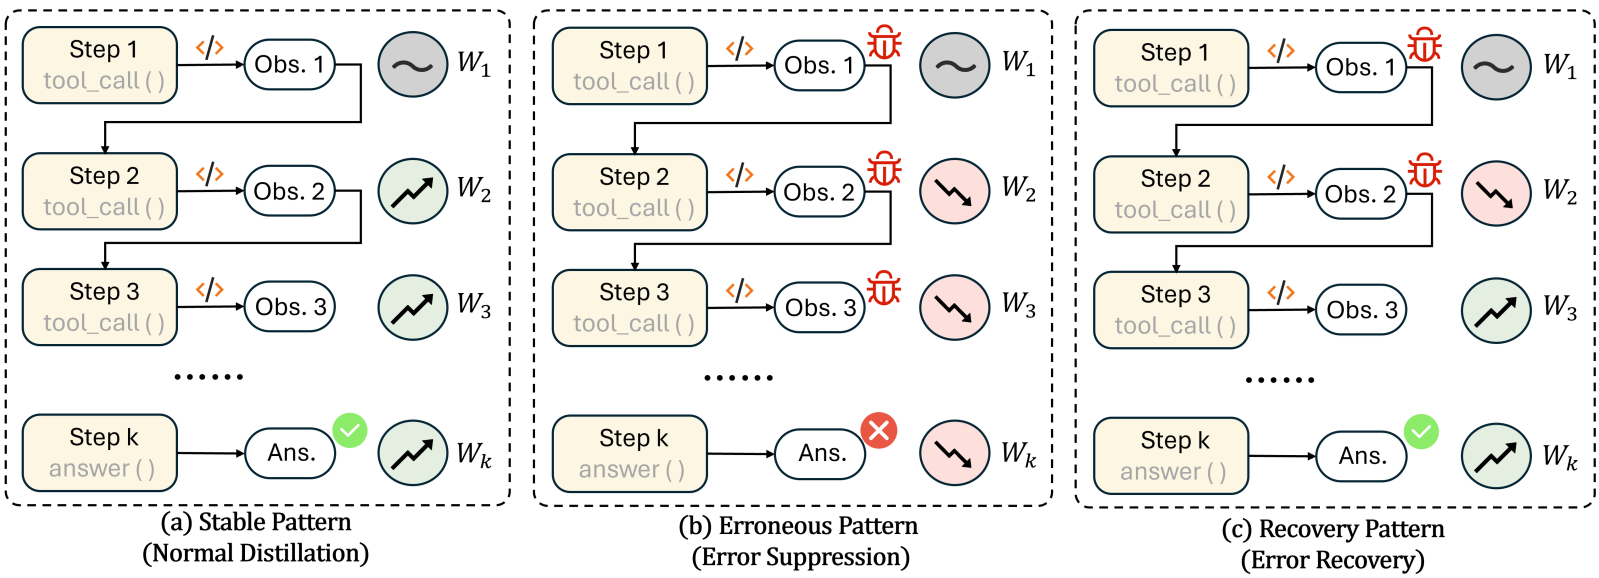
SOD 在实际训练中展现出了三种极具启发性的模式:
- 稳定模式 (Stable Pattern):学生紧跟教师,全程保持高权重蒸馏。
- 错误模式 (Erroneous Pattern):学生持续犯错,权重迅速衰减,防止垃圾信号污染梯度。
- 恢复模式 (Recovery Pattern):这是最关键的发现。当学生在中间步骤出错但在后文自行纠正时,SOD 能识别出这种趋势并重新加强对后期正确步骤的引导。
4. 实验战绩:Sub-Billion 模型的巅峰表现
SOD 的效果极其显著,尤其是在数学和科学基准测试上:
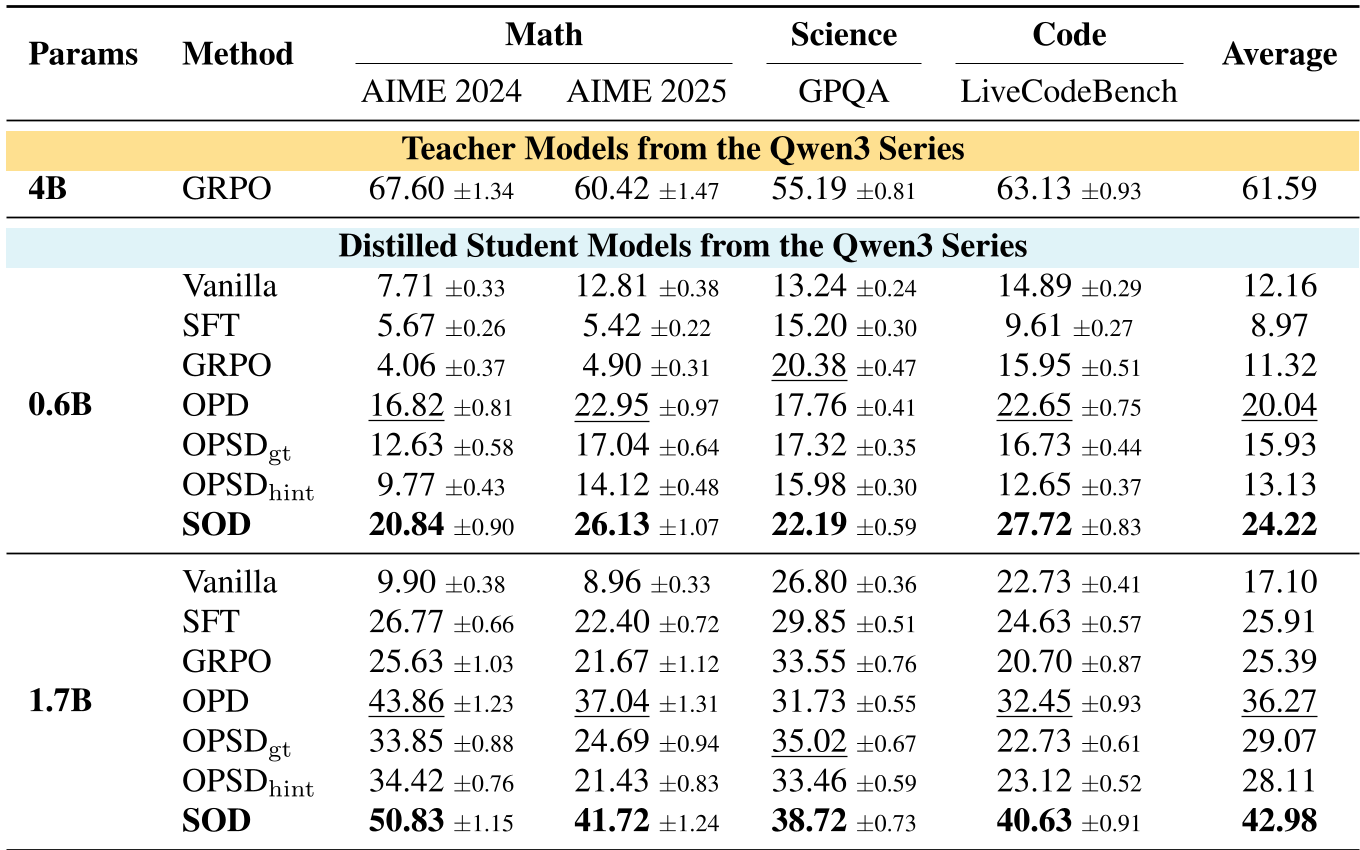
- AIME 2025:0.6B 模型凭借 SOD 达到了 26.13% 的分数。相比之下,传统的 OPD 仅有 22.95%,而基线 SFT 只有可怜的 5.42%。
- 效率提升:在 1.7B 规模下,SOD 比 OPD 的平均准确率高出近 19%。
5. 深度洞察:为什么 SOD 对小模型至关重要?
论文中的消融实验揭示了一个重要结论:对于小模型,单纯的强化学习(如 GRPO)往往会导致“熵坍缩”。如图 4 所示,GRPO 训练的小模型会逐渐丧失探索欲望,甚至完全放弃调用工具。
SOD 通过引入分步的 Token 级密集监督,在保持策略探索的同时,给出了极其精细的纠错指导。这种“松紧有度”的监督机制,才是让 SLM 真正掌握复杂 Agent 能力的秘诀。
6. 总结与反思
SOD 的成功告诉我们,在 Agentic Reasoning 领域,“更多的数据”不如“更可靠的梯度”。通过简单的步级散度感知,我们能够让只有 0.6B 参数的模型迸发出超越其容量限制的逻辑能力。
局限性:目前研究主要集中在 Python 代码解释器环境。在 API 调用、Web 导航等更具随机性和观测噪声的环境中,如何构建更稳健的 代理指标,将是未来的重要研究方向。
主编点评:这是一篇极具工程实操价值的论文。它没有通过复杂的数学推导来炫技,而是洞察了 TIR 任务中“状态不连续”的本质,用最小的算力代价(仅增加极少的标量运算)换取了显著的 SOTA 提升。