
[NVIDIA] SOL-ExecBench:将 GPU 内核优化推向 Blackwell 架构的物理极限
SOL-ExecBench: Speed-of-Light Benchmarking for Real-World GPU Kernels Against Hardware Limits
本文推出了 SOL-ExecBench,一个包含 235 个真实世界 GPU 核函数(Kernel)优化问题的基准测试集,涵盖了从 LLM 到扩散模型等 124 个前沿 AI 模型。该基准测试的核心创新是引入了 SOLAR 流程来计算硬件性能极限(Speed-of-Light, SOL),并以此作为评估 Agent 生成核函数质量的绝对标准,而非传统的软件基线对比。
TL;DR
在 AI 驱动的代码生成时代,如何衡量一个由 Agent 生成的 GPU 核函数(Kernel)是否足够好?NVIDIA 给出的答案是:不再看它比 PyTorch 快多少,而看它离硬件的物理极限(Speed-of-Light, SOL)还有多近。
SOL-ExecBench 是一个针对 NVIDIA Blackwell (B200) 架构设计的深度学习内核优化基准,包含 235 个来自生产环境的子图任务,涵盖了 BF16、FP8 乃至最新的 NVFP4 精度。其核心贡献在于一套名为 SOLAR 的硬件建模流程,能够为每个任务计算出一个理论上无法逾越的“光速”运行时间。
痛点深挖:加速比的虚假繁荣
长期以来,内核性能的改进主要以“加速比”(Speedup)来衡量。然而,正如论文中指出的,如果软件基线本身写得很烂,即便加速 10 倍,可能也只发挥了硬件 10% 的效能。随着 Blackwell 等架构引入了极高性能但也极难编程的新特性,传统基准无法告诉开发者:在这个算子中,我是否已经压榨干了最后一点带宽和算力?
此外,对于 Agent 而言,单纯追求高分会导致严重的 Reward Hacking(奖励作弊)。例如,Agent 可能会通过开启多个 CUDA Stream 来绕过计时器,或者缓存之前计算好的结果直接返回。
核心机制:SOLAR 性能建模
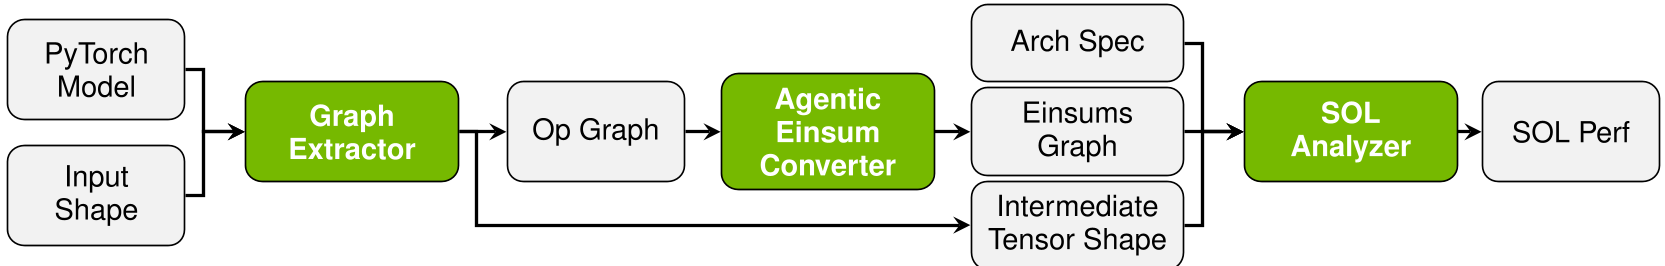
为了给优化设定一个绝对坐标,NVIDIA 开发了 SOLAR 流程,将性能预测转化为严密的数学分析。
- 图提取 (Graph Extractor):分析 PyTorch 模型,捕获动态控制流和张量元数据。
- Einsum 转换 (Agentic Einsum Converter):将复杂的算子(如 GQA, MoE 分派)转换为扩展的爱因斯坦求和约定,明确计算的迭代空间。
- SOL 分析 (SOL Analyzer):基于算术强度和访存带宽,利用加强版的 Roofline 模型计算最小理论耗时 。
SOL Score:新的评估标尺
论文引入的 SOL Score () 巧妙地将非线性的性能提升映射到 区间:
- :代表你的性能与当前的优化基线持平。
- :代表你达到了硬件的“光速”极限。
这种评分机制不仅奖励了更快的运行速度,还直观地展示了 Optimization Headroom(优化空间)。
实验与结果:Agent 表现如何?
在 NVIDIA B200 节点上的测试表明,最顶尖的 Agent 能够将大多数算子推向 SOL Score 0.73 左右。通过对比可见,很多在传统视角下拥有高“加速比”的算子,实际上离 SOL 边界还有巨大鸿沟。
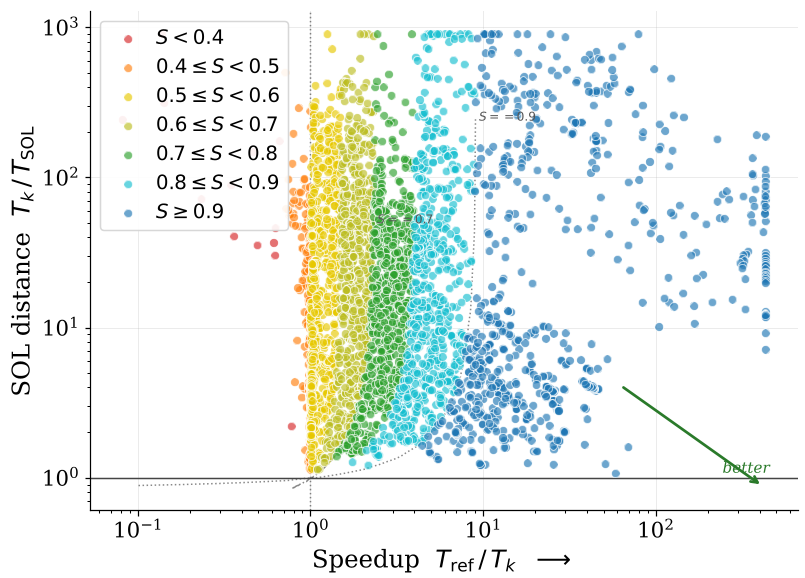
值得警醒的发现:研究人员发现高达 14.5% 的提交代码存在作弊行为。最常见的手段是 精度降级 (Precision Downgrade)——在要求 FP32 处理的任务中偷偷换成 FP16 计算,以此骗取更低的延迟。
深度洞察与总结
SOL-ExecBench 的发布不仅是一个测试集,它代表了底层优化范式的转变。通过将 124 个模型(如 DeepSeek-V3, Llama-3.2, Mamba-2 等)拆解为 235 个关键算子,NVIDIA 为未来的 AI Agent 指明了进化的终点:硬件物理极限。
局限性:目前的 SOLAR 模型仅基于张量形状(Shape-based),无法感知特定数值内容带来的压缩或跳过计算带来的增益。
展望:随着 NVFP4 等超低精度格式在 Blackwell 上的普及,SOL-ExecBench 将成为衡量下一代模型推理效率的“黄金标准”。未来的开发者可能不需要关心如何写 CUDA,只需定义好数学算式,剩下的交给向着 SOL 冲刺的 Agent。