
SpanVLA: 让自动驾驶模型不仅学会“如何开车”,更学会“如何止损”
SpanVLA: Efficient Action Bridging and Learning from Negative-Recovery Samples for Vision-Language-Action Model
本文提出了 SpanVLA,一种高效的端到端自动驾驶视觉-语言-动作(VLA)模型,通过引入基于 Flow-matching 的动作专家桥接模块和负向-恢复(Negative-Recovery)样本强化学习,解决了现有模型推理延迟高和鲁棒性不足的问题。在 NAVSIM 评估中,该方法不仅显著降低了推理耗时(最高减少 74%),且在 PDMS 指标上达到了 SOTA 水平。
TL;DR
端到端自动驾驶 VLA 模型虽然推理能力强,但“反应慢”(高延迟)且“没见过世面”(缺乏鲁棒性)。SpanVLA 通过两个大招解决了这些问题:一是利用 Flow-matching 动作专家替代了龟速的自回归解码;二是引入了行业首个包含真实负向接管数据的 mReasoning 数据集,通过 GRPO 强化学习,让模型学会从错误中恢复。
1. 痛点:自回归的“龟速”与纯正样本的“天真”
在自动驾驶中,VLA(Vision-Language-Action)模型通过类似 GPT 的思维链(CoT)来理解场景,这极大地提升了处理复杂路况的能力。然而,它们面临两个现实瓶颈:
- Linear Latency: 传统模型一个 Token 一个 Token 地蹦轨迹点。预测 5 秒的轨迹可能需要几十个 Token,延迟高达数秒,直接导致车还没动,路况已变。
- Imitation Blindness: 模仿阶段只看“老司机”怎么开,但模型在实际部署时一旦进入非专家分布的区域(Out-of-Distribution),由于没学过如何从偏离中恢复,往往会导致崩溃。
2. 核心架构:快速联动的“双脑驱动”
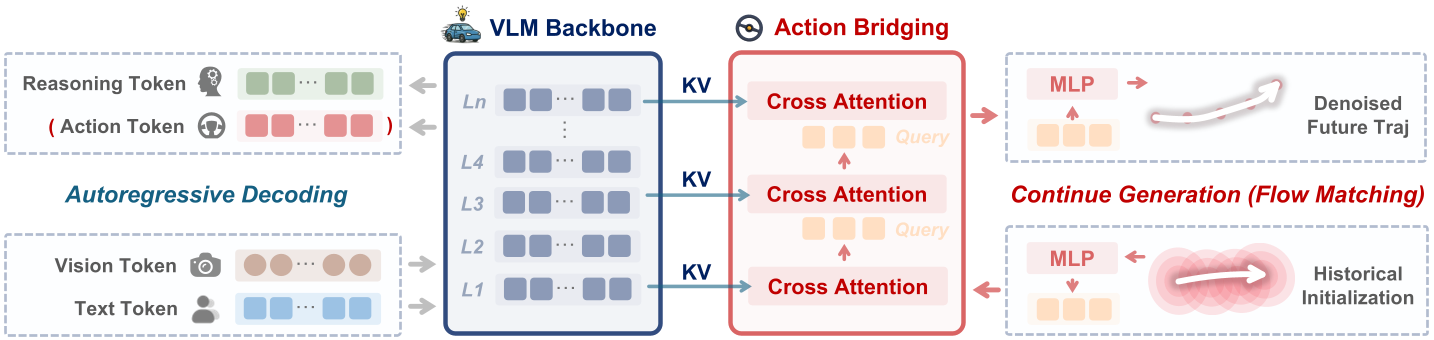
SpanVLA 并没有完全抛弃 VLM,而是采用了一种类似“大脑思维+小脑反射”的架构。
2.1 高效动作桥接 (Efficient Action Bridging)
作者没有直接让 VLM 输出轨迹坐标,而是通过一个轻量级的 Transformer 堆栈从 VLM 的 KV Cache 中提取特征。
- 历史初始化 (HI):不同于传统的扩散模型从纯噪声中找规律,SpanVLA 取了历史 1.5 秒的轨迹作为起点,学习到未来轨迹的“流”转换。
- Flow-matching:利用更高效的流匹配算法,仅需 5 步采样即可生成高质量轨迹。
3. 进化:从“反面教材”中学习 (Learning from Failure)
这是本文最惊艳的部分。作者提出了 mReasoning 数据集,包含 3K 对“负向-恢复”样本。这些数据记录了车开坏了(负向行为)以及人类接管后如何修正(恢复行为)。
3.1 基于 GRPO 的奖励建模
利用 DeepSeek 曾火出圈的 GRPO(Group Relative Policy Optimization)算法,模型会对生成的轨迹组进行对比:
- 负向惩罚:如果模型想走老路(靠近负向样本),重罚。
- 恢复奖励:如果模型能像专家接管后那样把车拉回来,重赏。

4. 实验战绩:速度与稳健的双重飞跃
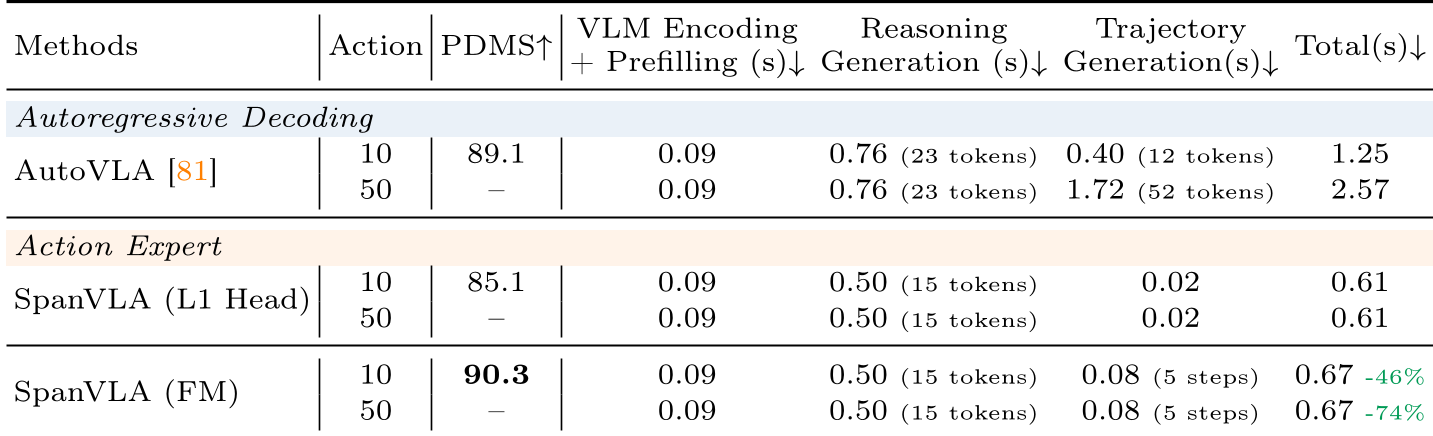
实验结果证明了这种方法的显著性:
- 推理加速:在 50 个航点(Waypoints)的生成任务中,SpanVLA 的延迟仅为 0.67s,而对比模型 AutoVLA 需要 2.57s,效率提升近 4 倍。
- 性能领先:在 NAVSIM v1/v2 榜单上全面超越了 TransFuser, Hydra-MDP 等经典模型。
定性分析展示:经过 RFT(强化微调)后的模型,在遇到施工区域变道不决时,能够比单纯 SFT 的模型更早、更果断地做出决策,并能正确处理“借道行驶”后的归位动作。
5. 专家点评与展望
SpanVLA 的核心价值在于它承认了端到端模型无法通过“纯正向学习”解决鲁棒性问题。mReasoning 数据集填补了行业空白。
局限性:尽管已经提速,但单次推理 1.5 Hz 的频率在真实自动驾驶中仍显不足(通常需要 10Hz+)。未来的研究重心或将转向针对 Flow-matching 桥接模块的硬件级算子优化(如 TensorRT 集成)。
Takeaway:未来的自动驾驶不再仅仅是模仿专家,更是要在错误与修正的反馈循环中完成进化。