
稀疏自编码器捕捉到概念流形了吗?从线性方向到几何结构的范式转移
Do Sparse Autoencoders Capture Concept Manifolds?
本文探讨了稀疏自编码器(SAE)是否能有效捕捉 LLM 表示中的概念流形。作者提出了一种基于“流形叠加”的理论框架,发现 SAE 目前主要通过“分片平铺”(Tiling)而非“全局捕捉”(Subspace Capture)来表示非线性概念。
TL;DR
大语言模型(LLM)的内部表示真的像我们想象中那样是“线性叠加”的吗?最新的研究《Do Sparse Autoencoders Capture Concept Manifolds?》给出了否定且深刻的回答。研究发现,虽然我们习惯用**稀疏自编码器(SAE)去提取一个个线性的“特征方向”,但这些特征往往只是对更复杂的、连续弯曲的语义流形(Manifolds)**进行的碎片化切割(Tiling)。
痛点深挖:线性假设的局限
目前的机械可解释性(Mechanistic Interpretability)大多基于线性表示假设(LRH)。该假设认为:一个概念 = 一个方向。
然而,现实中的概念往往是连续且有几何关系的。例如:
- 温度:在一条直线上连续变化。
- 星期:呈现闭合的环状结构。
- 颜色:具有色调(环状)和明度(线性)交织的复杂拓扑。
如果我们强行用线性的 SAE 去拟合这些弯曲的流形,就会出现特征碎片化:一个完整的颜色概念被拆散成了几十个各司其职的“局部探测器”。这解释了为什么我们调整单个 SAE 特征时,模型的表现往往很脆弱。
核心直觉:捕捉(Capture)vs 平铺(Tiling)
作者提出了两种 SAE 表达流形的方式:
- 全局子空间捕获(Subspace Capture):理想状态下,SAE 分配一小组原子,它们的张成空间包含了整个流形。
- 局部区域平铺(Tiling):现实状态下,SAE 用大量原子像贴瓷砖一样覆盖流形。
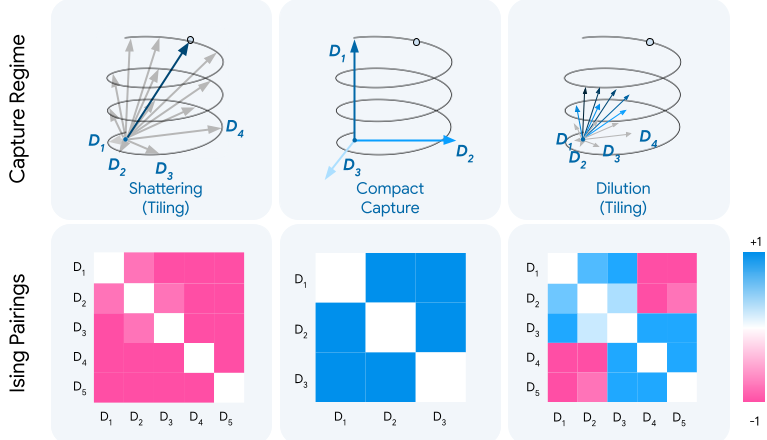
研究发现,当前的 SAE 架构处于一种被称为**“稀释”(Dilution)**的尴尬境地:它既没有实现紧凑的捕获,也没有实现完美的平铺,而是通过大量冗余、互有重叠的原子分布在流形上。
方法论详解:引入 Ising 模型
为了在成千上万个 SAE 特征中找到属于同一个流形的“亲兄弟”,作者借鉴了物理学中的 Ising 模型。
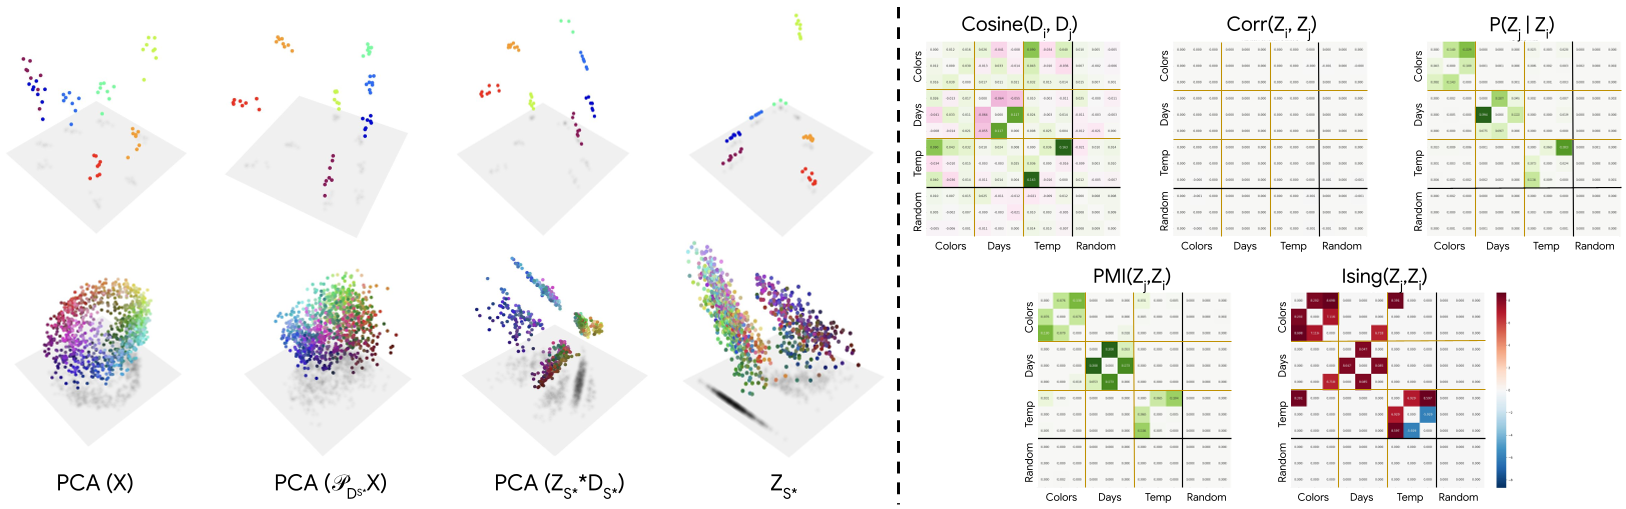
既然余弦相似度(方向相似性)不可靠(因为流形是弯曲的,各处的切线方向可能正交),那么就看协同激活统计(Co-activation Statistics)。作者通过拟合 Ising 模型得到特征间的耦合矩阵 :
- 如果两个特征属于同一个流形并互相补充,它们会表现出强烈的耦合。
- 这种方法能比传统的聚类更精准地剥离出功能性的特征集群。
实验战绩:LLM 的“真实面目”
研究者在 Llama-3.1-8B 上进行了验证。实验结果显示:
- 流形无处不在:政治偏向、科学不确定性、甚至是格式的规范程度,在残差流中都呈现出清晰的几何形状。
- SAE 的瓶颈:无论使用 TopK、BatchTopK 还是传统的 L1 惩罚,SAE 都无法用 个原子(流形的嵌入维度)完美重建流形,而是需要庞大的“特征稀释集”。
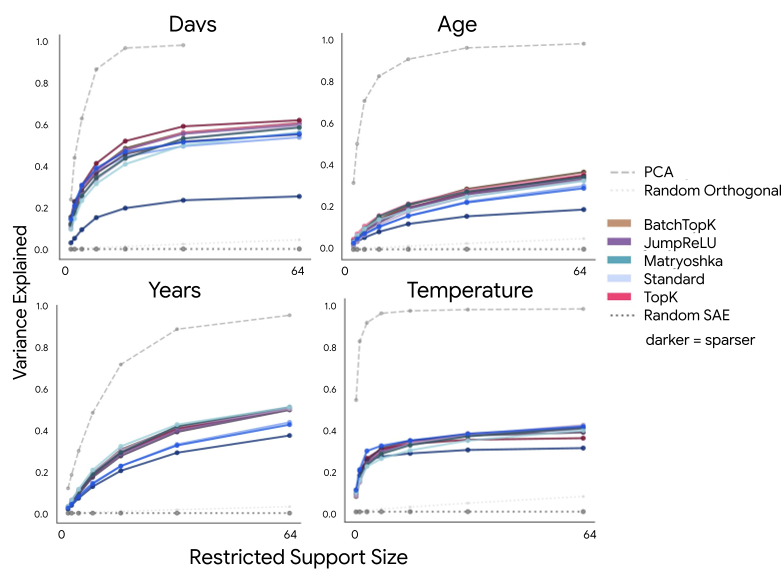
上图显示, 曲线在远超流形本质维度时才趋于平缓,证明了现有 SAE 在捕捉非线性结构时的低效。
深度洞察:可解释性的未来
这篇文章不仅是关于 SAE 的诊断报告,更是对可解释性领域的范式挑战:
- 从方向到对象:我们不应再孤立地看某个感知机或某个 SAE 原子,而应关注它们共同编织成的“几何对象”。
- 新一代 Featurizer 的需求:我们需要能够原生处理非线性曲率和拓扑结构的特征提取算法。
- 干预的新视角:在流形上移动(Steering),比沿着单一方向推送,更能符合模型的内部推理逻辑。
总结: AI 的思想可能不是一根根整齐的线条,而是一张张起伏的薄膜。SAE 只是这张薄膜上的显微镜,而真正的理解,源于对全貌的复原。