
[arXiv 2025] 机器人也会“死记硬背”?SAE 揭秘 VLA 模型的内部表征与操控
Sparse Autoencoders Reveal Interpretable and Steerable Features in VLA Models
本文提出了一种基于稀疏自编码器 (SAE) 的视觉-语言-动作 (VLA) 模型机械可解释性分析框架。通过在 π0.5 和 OpenVLA 等 SOTA 模型上训练 SAE,成功在稠密激活中提取出具有语义含义、可解释且可操控的稀疏特征,揭示了机器人策略内部的泛化与记忆机制。
TL;DR
视觉-语言-动作(VLA)模型虽然强大,但其背后的决策逻辑一直是个“黑盒”。本文通过稀疏自编码器 (SAE) 成功拆解了 VLA 模型的内部激活,识别出了哪些神经元在负责“抓取”、“运输”等通用任务,哪些则在偷偷“死记硬背”特定的演示序列。这不仅让我们看清了模型的逻辑,还能通过干预这些特征直接“操控”机器人的动作。
背景定位
目前 VLA 模型(如 OpenVLA, π0)正处于从实验室走向现实世界的十字路口。虽然它们在 LIBERO 等仿真环境中刷到了高分,但往往表现出极强的脆弱性:稍微改变一下环境布局,模型就可能失效。本文是首个利用机械可解释性(Mechanistic Interpretability)手段深入剖析 VLA 泛化与记忆本质的工作。
痛点深挖:泛化的幻觉
作者指出,SFT(监督微调)是一把双刃剑。在小规模机器人数据集上微调,往往会导致模型出现轨迹级记忆(Trajectory-level Memorization)。
- 现有痛点:我们缺乏工具来判断,模型成功完成任务是因为它理解了“杯子”和“放进篮子”的关系,还是因为它记住了“在此坐标下向左移 5 厘米”的指令。
- 核心直觉:借鉴 LLM 的“线性倾向假设”,复杂的概念在模型的高维空间中是叠加的。如果能用 SAE 将其投影到稀疏空间,就能把“记忆”和“原语”分离开来。
方法论详解:SAE 的机械拆解
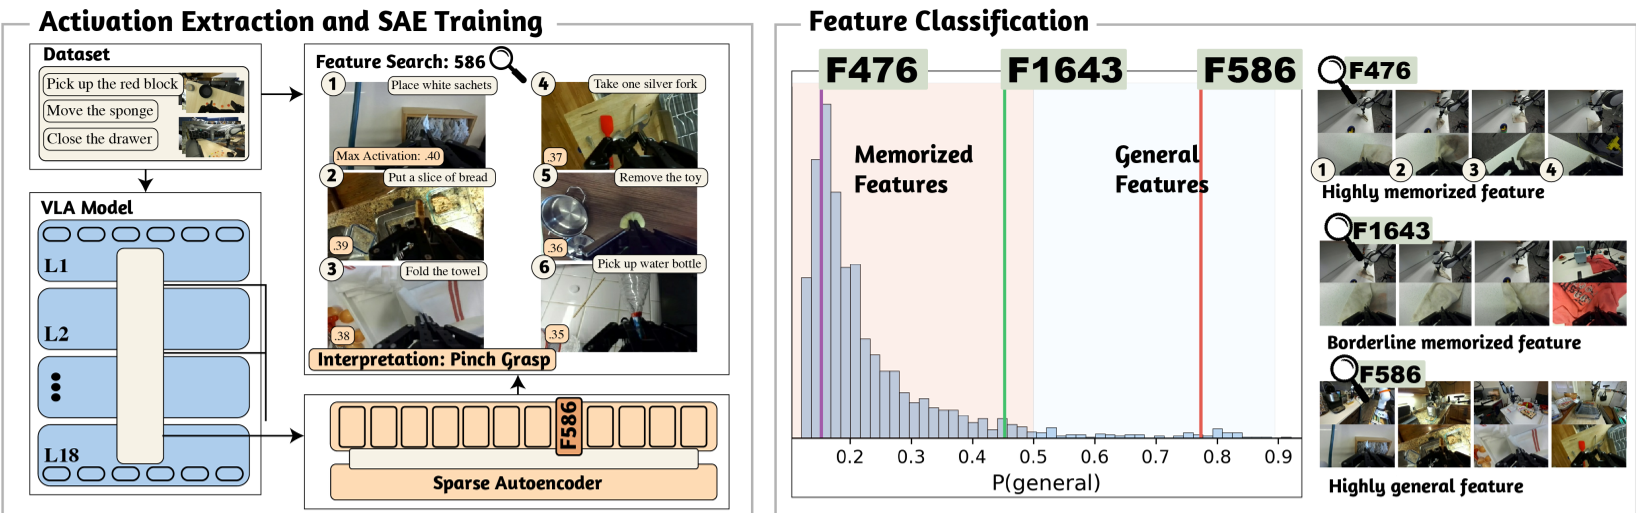
作者在 π0.5 模型的 PaliGemma 层和 Action Expert 层插入了 SAE。
1. 架构解析
SAE 通过无监督学习,试图将稠密的隐藏层激活 重构为稀疏的特征向量 。其核心在于 TopK 激活函数,它强迫模型只使用最关键的 个方向来解释当前状态。
2. 特征分类学
为了处理数以万计的特征,作者定义了四大维度:
- Episode Coverage (c):特征在多少个不同场景中出现?
- Mean Onset Count (o):特征是突然爆发(代表事件触发)还是持续长盛(代表背景记忆)?
- Relative Run Length:激活时长占比。
通过逻辑回归,模型被自动划分为:
- General Features (通用特征):如“抓取”、“放置”、“任务完成”。
- Memorized Features (记忆特征):仅在特定场景或特定演示中激活。
实验与结果:因果干预的魔力
通用特征的视觉发现
在 DROID 数据集上,SAE 提取出了极具物理意义的特征。例如特征 F586 (Pinch Grasp),无论是抓取薄片、糖包还是毛巾,只要涉及到这种“捏”的动作,该方向就会激活。
特征转向 (Feature Steering)
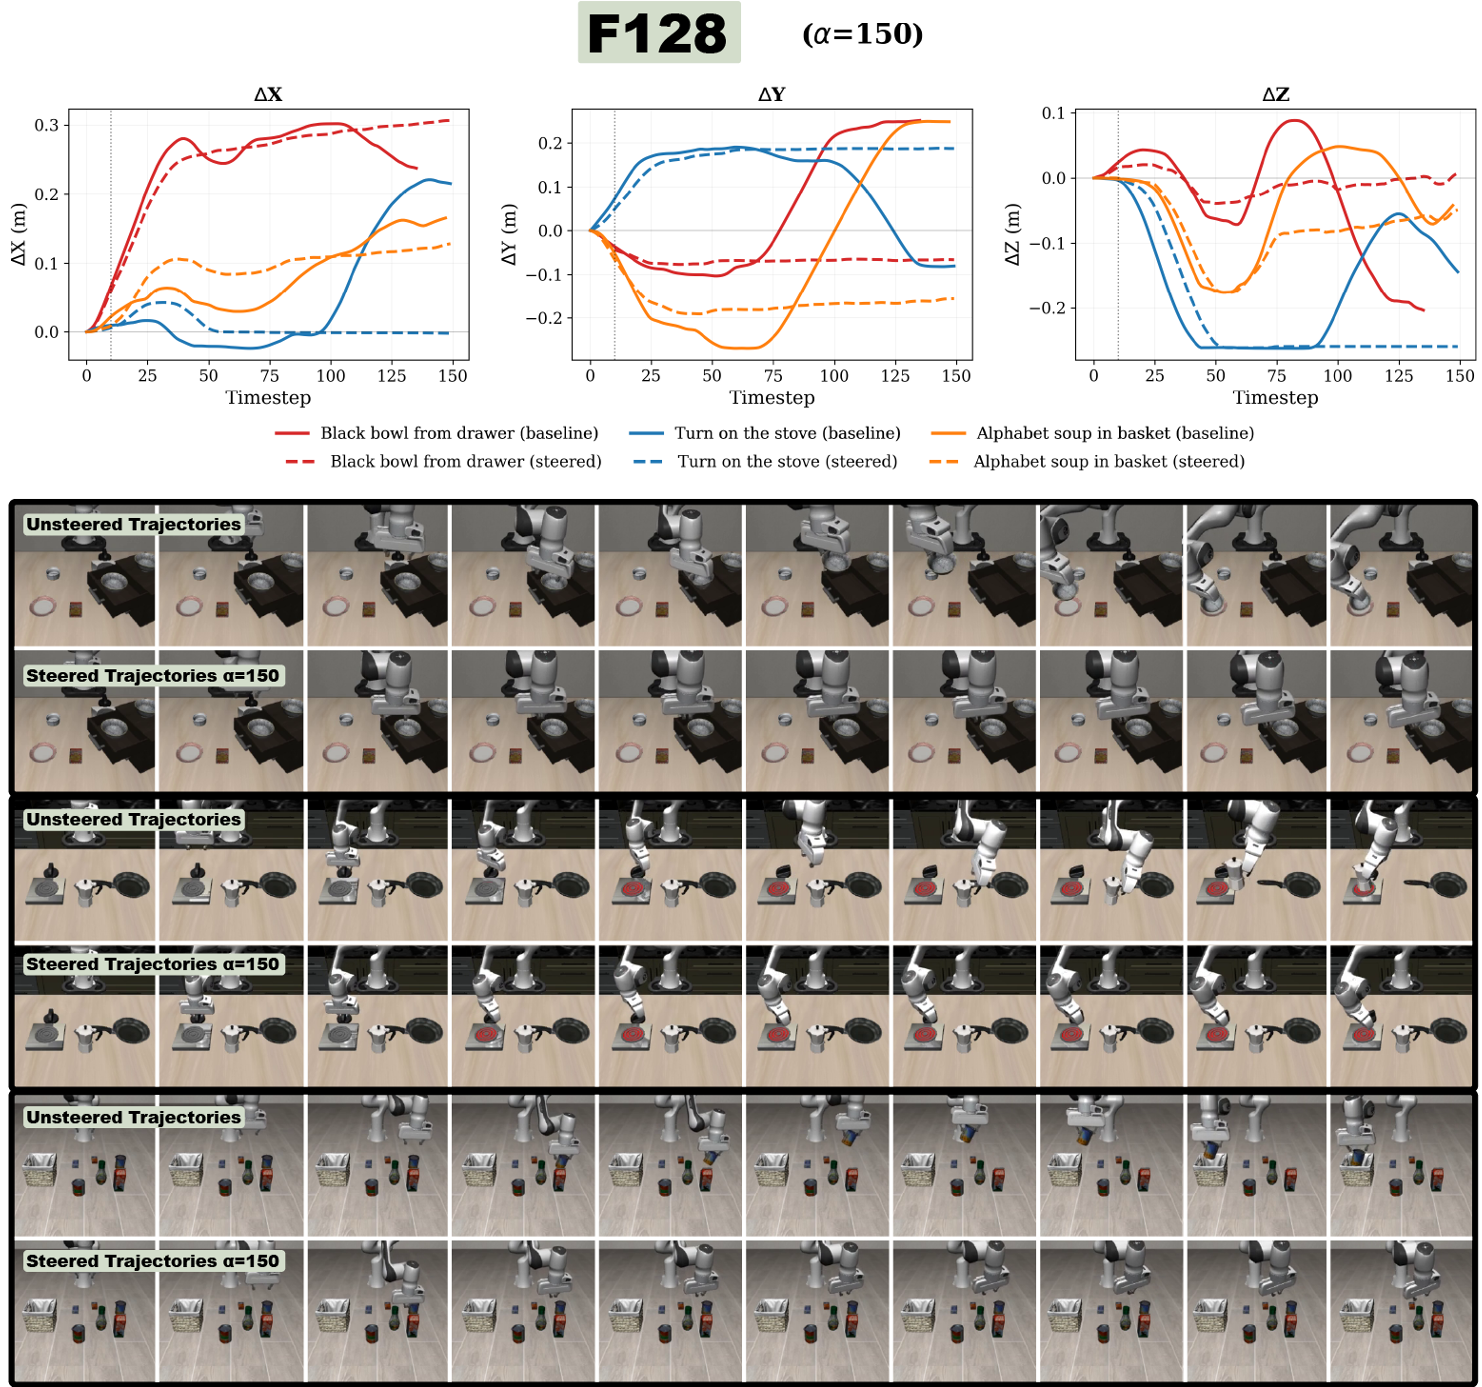
这是本文最惊艳的部分。作者通过修改残差流中的特定特征向量方向来干预推理:
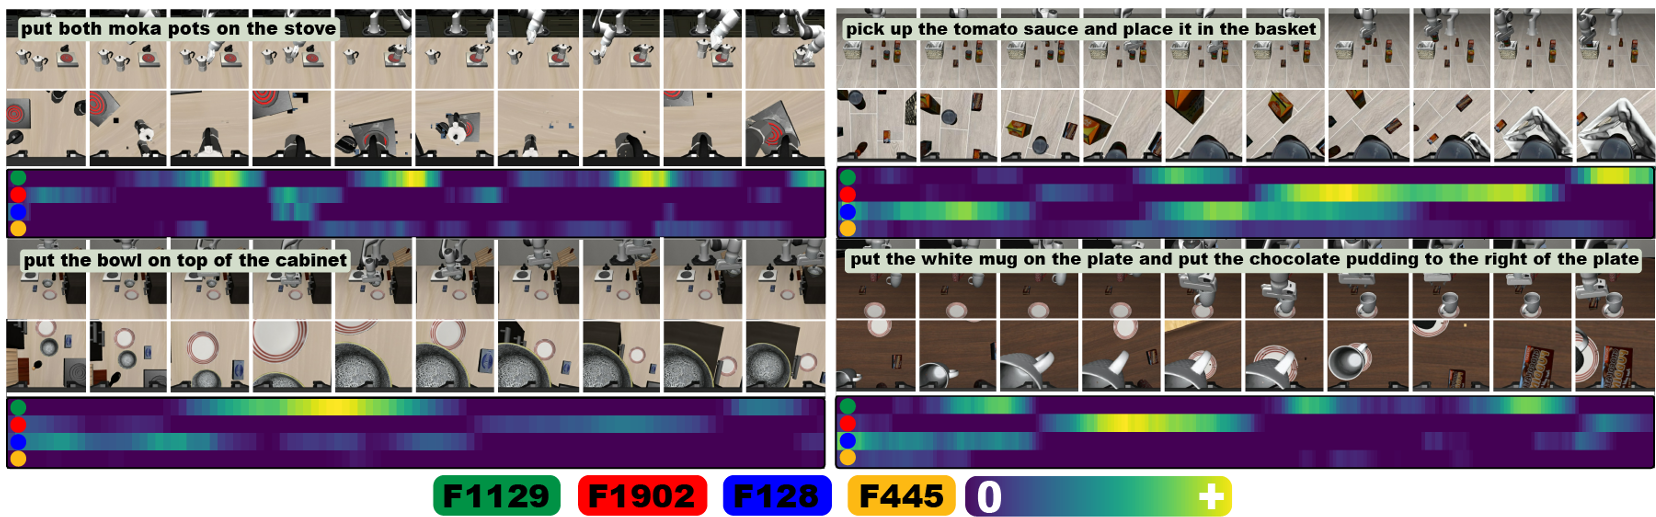
- 干预 F128 (预抓取对齐):即使机器人离杯子很近,它也会停留在杯子上方“反复对齐”,而不是执行抓取。
- 干预 F1902 (运输特征):机器人会直接跳过抓取阶段,直接向目标放置区域移动,甚至撞上障碍物。
这有力证明了 SAE 找到的不仅仅是相关性,而是控制行为的因果变量。
深度洞察:如何提升泛化性能?
作者通过对比发现,训练策略对泛化有本质影响:
- 数据集规模:从 LIBERO 到 DROID,随着数据多样性增加,通用特征占比明显提升。
- 知识绝缘 (KI):使用知识绝缘技术能有效减缓微调过程中的“记忆化”倾向,保持模型内部表征的纯净度。
- 训练步数:微调步数越多,模型往往越倾向于死记硬背(记忆特征占比增加),存在明显的退化曲线。
总结与局限
Takeaway:本文证明了 VLA 确实可以学习跨场景的通用技能,但这些技能往往被大量的记忆特征所淹没。通过 SAE 指标,我们可以在模型还没上真机之前,就通过“离线体检”预测其泛化能力。
局限性:尽管特征可解释,但并非所有特征都能实现完美的转向。由于 VLA 输出层采用流匹配 (Flow Matching) 或扩散模型,非线性的下游交互可能削弱线性干预的效果。下一阶段的研究将聚焦于如何在训练实时环节引入 SAE 约束,以强制模型学习更多的通用原语。