
SAEgis:将稀疏自编码器转化为视觉语言模型的“即插即用”防火墙
Sparse Autoencoders as Plug-and-Play Firewalls for Adversarial Attack Detection in VLMs
本文提出了 SAEgis,一种基于稀疏自编码器(SAE)的轻量级视觉语言模型(VLM)对抗攻击检测框架。该方法通过将 SAE 作为插件模块插入预训练 VLM,利用其学习到的稀疏潜特征(Sparse Latent Features)来识别攻击信号,在不改变原模型权重的前提下实现了 SOTA 级别的防御。
TL;DR
随着 VLM(Vision-Language Models)从简单的聊天工具演变为具备执行能力的 Agent,其安全性问题日益凸显。本文提出的 SAEgis 框架通过在模型中嵌入稀疏自编码器 (SAE),巧妙地将原本用于可解释性研究的工具转化为防御利器。该方法无需任何昂贵的对抗训练,仅通过分析隐藏层特征的稀疏激活模式,就能以极低的开销识别各种已知的对抗攻击,并在跨任务、跨领域的复杂场景下展现出极强的鲁棒性。
1. 痛点:为什么 VLM 防御这么难?
当前的视觉语言模型(如 Qwen-VL, LLaVA)在理解和逻辑推理上突飞猛进,但在对抗攻击面前几乎是“裸奔”。只需要在图像中加入微小的扰动,模型就会完全无视原本的视觉语义,转而输出攻击者预设的恶意内容。
现有防御方法(如基于 SVM 的分类或 Steering Vector 方向检测)存在两大局限:
- 缺乏泛化性:在 A 数据集训练的防御者,在 B 领域(如医学影像)往往完全失效。
- 过度依赖强假设:往往需要预先知道攻击类型,无法应对快速演进的攻击策略。
2. 核心直觉:寻找扰动的“指纹”
作者的 Insight 非常深刻:对抗扰动在流形空间中是“非自然”的异常信号。
通过训练一个以重建为目标的 SAE,模型学会了如何以极端稀疏的方式表达“清洁图像”的特征。由于对抗扰动破坏了图像的统计规律,它们往往会激活那些在正常图像中极少出现的、特定的潜在特征。SAEgis 正是利用这一特性,通过监控这些“对抗相关特征”的激活情况来判定输入是否安全。
3. SAEgis 架构解析:即插即用的防御
SAEgis 的流程极其精干,分为两步:
3.1 寻找对抗特征 (Feature Selection)
在少量(如 100 张)已知攻击图像中,计算特征 activation 的分值。分值综合考虑了激活的峰值强度和空间覆盖范围: 那些在攻击图中异常活跃但在清洁图中“保持沉默”的特征,被选定为 top-K 攻击探测器。
3.2 动态阈值检测 (Inference)
在推理阶段,SAEgis 只需要统计有多少个被选定的“指纹特征”被触发。阈值的设定仅参考清洁数据集的分布(例如设定 2% 的假阳性容忍度 α),无需预见未来的攻击。
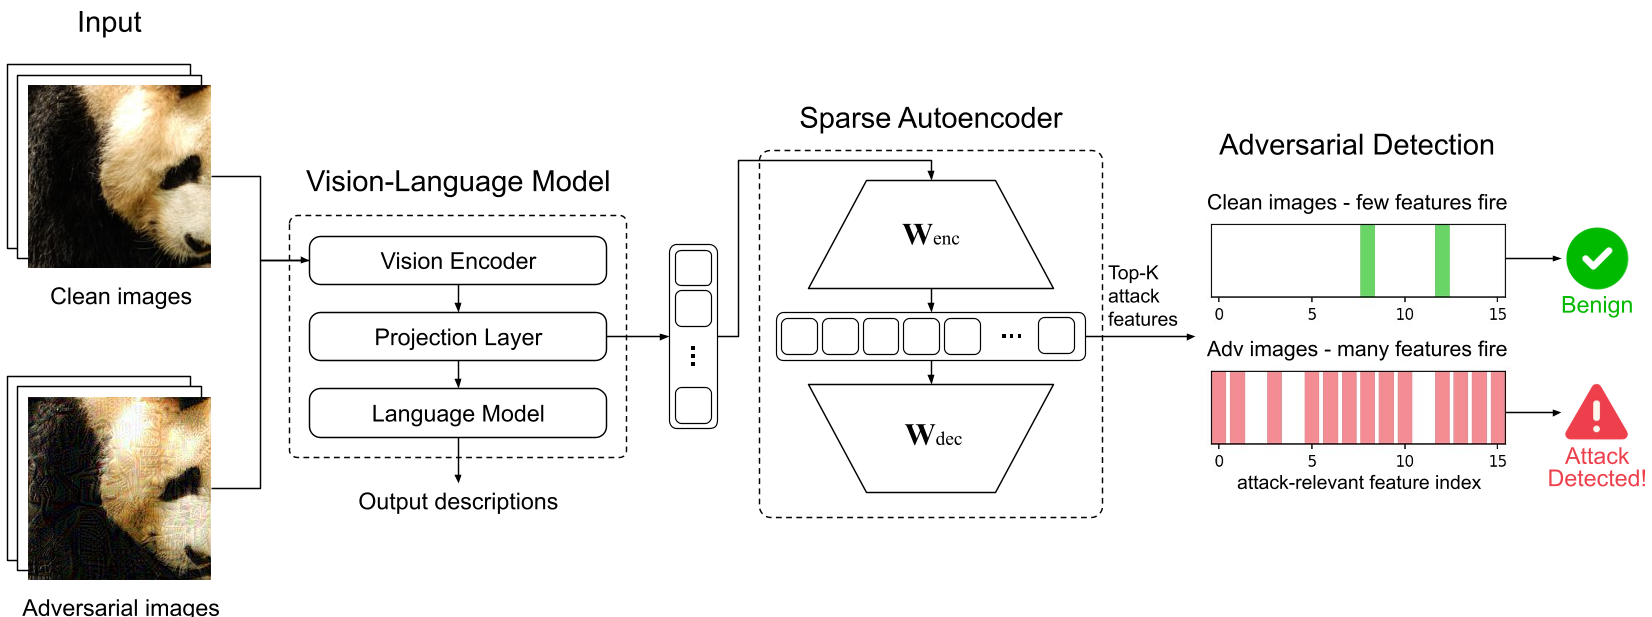 图 1: SAEgis 整体流程:从特征提取到基于分布的异常检测
4. 实验战绩:跨域能力的“碾压”
SAEgis 最大的亮点在于其跨域泛化能力。
在从自然图像(LLaVA)迁移到医学影像(Medical)的严苛测试中:
- 传统 Dense 基线:由于过度拟合了特定场景的隐藏层均值,跨域后的 F1 分数发生雪崩式下降(跌幅超过 40%)。
- SAEgis (Ensemble):利用不同层(Vision Encoder 的早期层与 Projection 投影层)的互补性,即便在未见过的医学影像和未见过的攻击方式(FOA-Attack)下,依然保持了 90% 以上的检测精度。
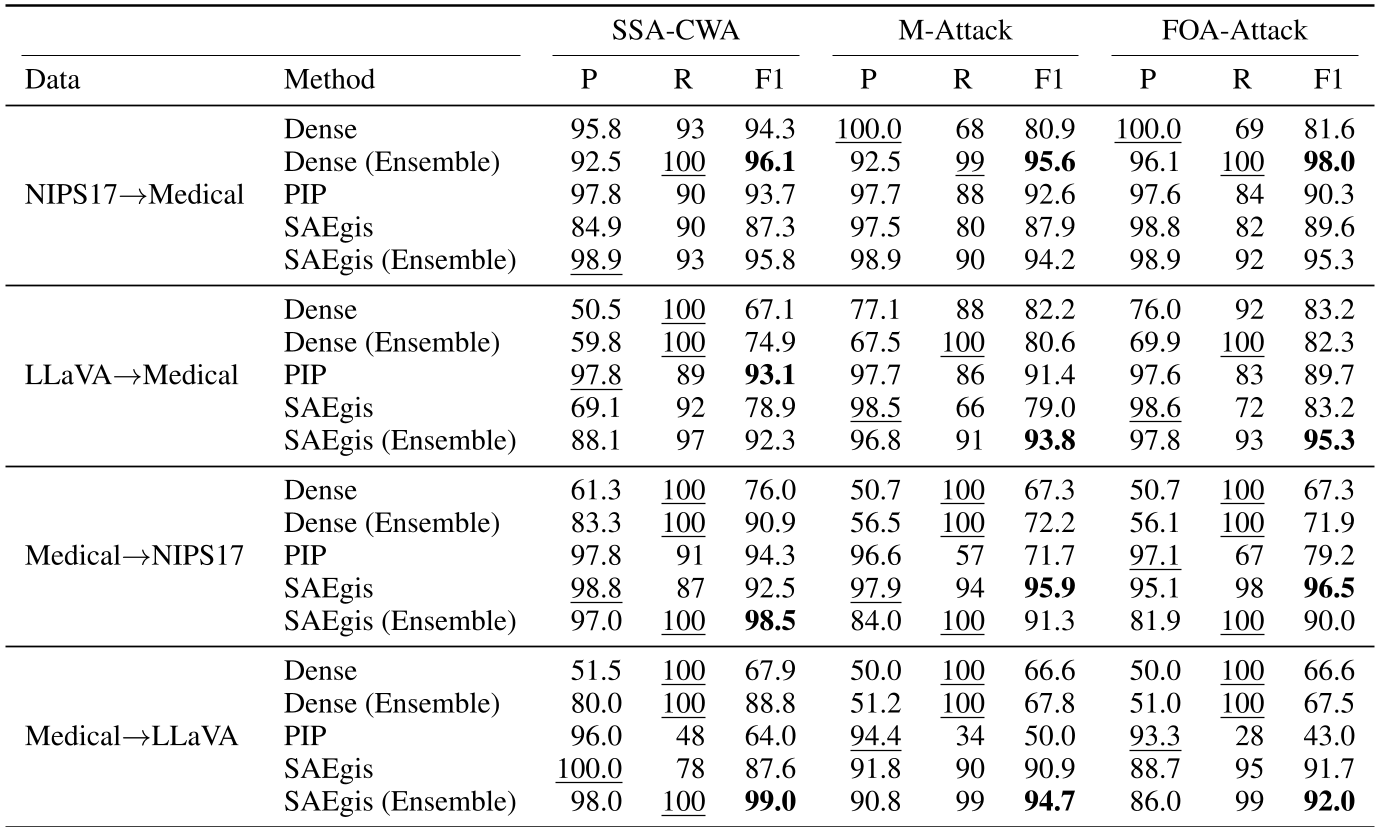 表 2: 跨域迁移实验数据:SAEgis 在各种领域偏移下展现出的恐怖稳定性
5. 深度洞察:为什么多层集成更有效?
作者通过消融实验(Ablation Study)指出,对抗攻击的信号分布在不同层中:
- 早期层 (Early Layers):由于编码了低级别的纹理和边缘,更容易捕捉基于高频噪声的扰动。
- 投影层 (Projection Layers):负责将视觉特征映射到语言空间,能更好地捕捉具有全局语义偏移的“高级”攻击。
采用多层集成策略使得检测系统能够同时兼顾局部统计异常和全局语义偏离。
6. 总结与反思
Takeaway: SAEgis 证明了 SAE 不仅仅是打开大模型“黑盒”的扳手,也可以是保护模型的铠甲。它的轻量级(minimal overhead)和无需对抗训练的特性,使其成为目前商业 VLM 部署中最具吸引力的安全方案之一。
局限性: 虽然对抗特征具有一定通用性,但如果攻击者知晓了 SAE 模块的存在,可能会设计针对 SAE 的“自适应攻击(Adaptive Attack)”来绕过检测。未来的研究需要进一步探索如何增强 SAE 特征本身的不可感性。