
SDVG:投机采样杀入视频生成,14B 大模型推理提速 60%
Speculative Decoding for Autoregressive Video Generation
本文提出了 SDVG,这是首个将投机采样(Speculative Decoding)引入自回归视频扩散生成领域的框架。通过 1.3B 的小模型作为 Drafter 生成候选视频块,并利用 ImageReward 结合“最差帧聚合”策略进行质量校验,在保持 14B Target 模型 98.1% 画质的同时,实现了 1.59 倍的推理加速。
TL;DR
在 LLM 领域,投机采样 (Speculative Decoding) 已经是 SOTA 级别的加速标配。然而,视频扩散模型由于其连续的张量输出和复杂的时序依赖,一直难以套用这一范式。今日分享的论文提出了 SDVG,通过引入一个“图像质量路由器”来判定小模型的预测是否达标。它不需要任何训练,在保持大模型级画质的前提下,将推理速度提升了近 1.6 倍。
1. 痛点:为什么视频不能直接“投机”?
传统 LLM 的投机采样依赖于 拒绝采样 (Rejection Sampling):大模型通过对比 Token 的概率分布来拍板是否接受小模型的预测。但在视频生成中:
- 无离散 Token:视频块(Video Blocks)是连续的 Spatiotemporal Tensors,没有 Logits 可以对比。
- 伪影敏感度:平均质量不错的视频块,如果中间有一帧崩了(Artifacts),整个视频的感官就会毁掉,这种“局部坏果”在自回归逻辑下会被积累放大。
2. SDVG 核心机制:质量驱动的路由
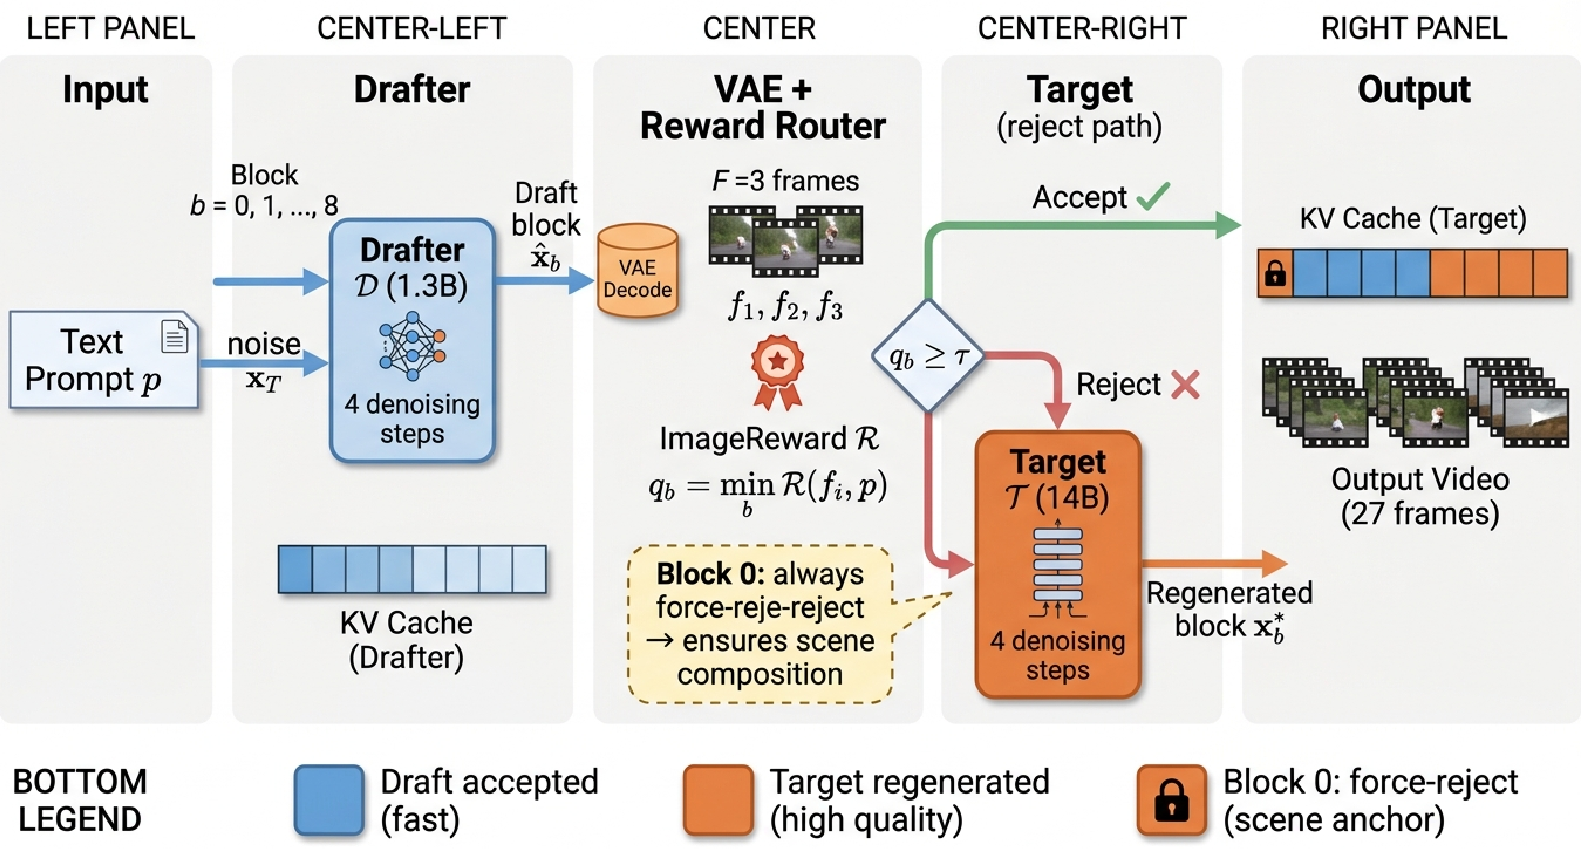
作者提出了一种“训练无关、插件化”的架构,其推理流程如下:
关键设计一:锚定首块 (Force-reject Block 0)
作者发现,视频的第一块决定了场景布局、主体特征和视觉风格。如果第一块让小模型草率处理,后续即便大模型介入也难以挽回。因此,SDVG 强行让大模型生成第一个 Block,作为整个序列的 "Anchor"。
关键设计二:最差帧聚合 (Worst-frame Aggregation)
传统的打分往往看平均分,但在视频里,均值会掩盖掉“一闪而过的错误”。 通过取一个 Block 内所有帧的最低分作为判定标准,SDVG 能够精准捕捉到闪烁和严重的单帧畸变,确保只有高质量的 Draft 被移入大模型的 KV Cache。
3. 实验表现:丝滑的 Pareto 前沿
研究人员在 MovieGenVideoBench 上进行了详尽测试。
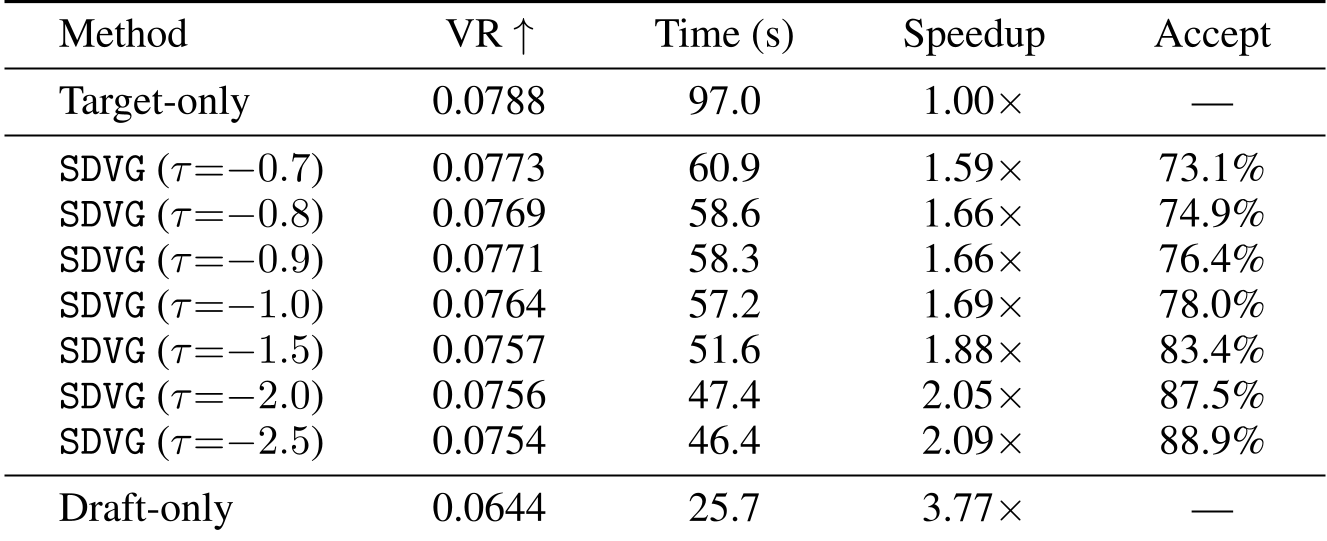
- 加速效率:在设置阈值 时,系统接受了约 73% 的小模型预测,实现了 1.59x 的墙钟时间加速。
- 画质无损:其 VisionReward 指标与纯大模型生成基本持平(98.1% 保留率),而相比纯小模型生成,画质直接跃升了一个梯度(+17.1%)。
4. 深度洞察:为什么这有效?
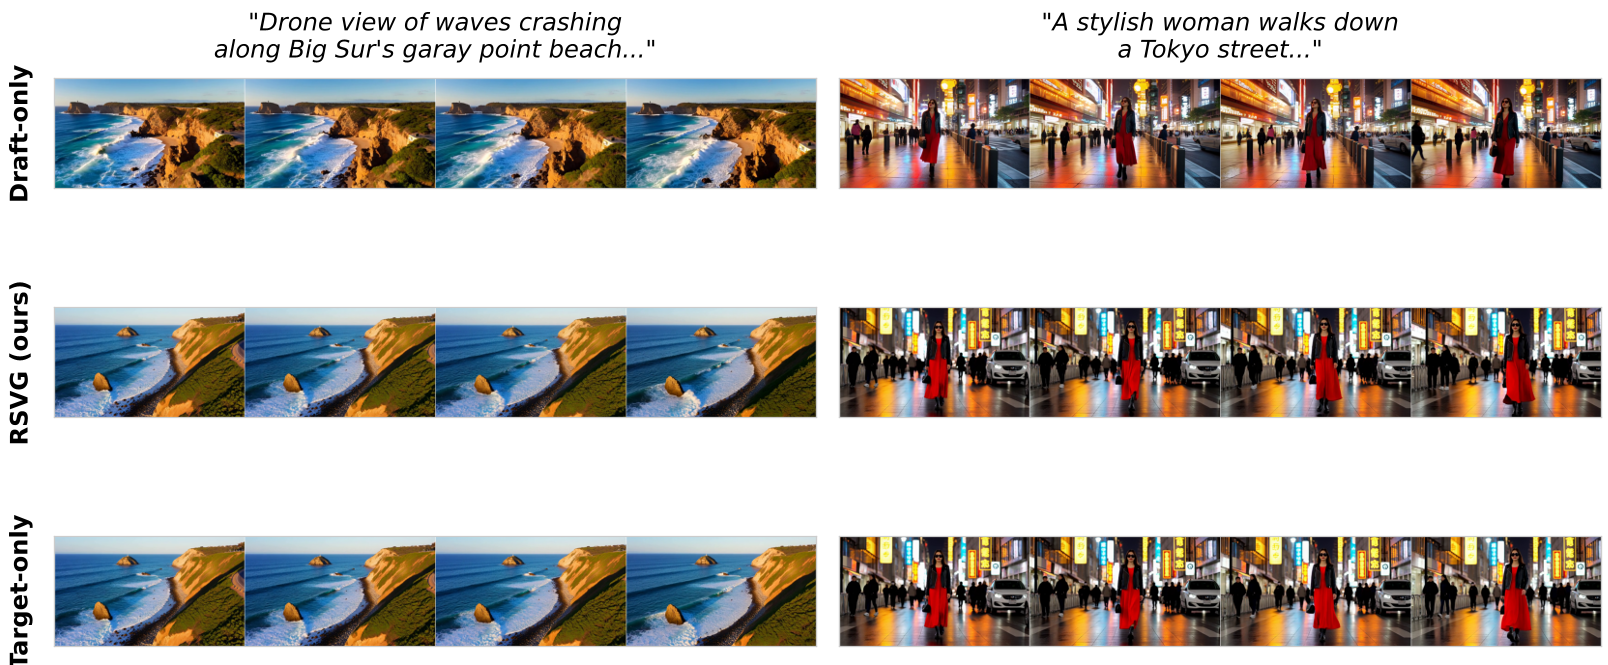
该研究揭示了一个深刻的直觉:在生成任务中,“验证”确实比“预测”简单得多。小模型虽然在处理复杂指令和精细构图上不如大模型,但它生成的某些“简单块(如背景平移、简单的动态)”其实能量产出足以媲美大模型的图像。SDVG 的本质是提供了一个计算资源分配器:把简单的块交给 1.3B 模型,把决定成败的块交给 14B 模型。
5. 局限与展望
尽管 SDVG 表现优异,但仍存在优化空间:
- 离散偏移:由于没有精确概率对齐,仍存在微小的分布偏移。
- 奖励模型延迟:目前使用的 ImageReward 虽然准确,但在推理中引入了额外的 VAE 解码和打分开销。未来如果能直接在 Latent 空间进行质量判定,速度还能进一步飞跃。
总结
SDVG 填补了自回归视频生成在投机采样领域的空白。它告诉我们,在缺乏数学精确分布证明的情况下,利用 Heuristic Reward (启发式奖励) 依然能构建出高效且稳健的加速系统。