
StableI2I:识破图像转换中的“瞒天过海”,精准捕捉非预期漂移
StableI2I: Spotting Unintended Changes in Image-to-Image Transition
本文推出了 StableI2I,一个专门用于评估图像到图像(I2I)转换任务中内容忠实度的统一动态框架。它通过整合语义、结构和底层外观三个维度,能够在无需参考图的情况下,精准捕捉图像编辑或修复过程中产生的非预期变化。
TL;DR
在 Image-to-Image (I2I) 领域,模型往往能生成好看的图,却很难保证“该留的地方一点没变”。StableI2I 是首个从语义级别、结构级别、底层外观三个维度系统评估 I2I 忠实度的框架。它不仅推出了一个极具挑战性的 Benchmark,还通过一种“误差放大”的训练策略,让 8B 规模的模型在检测图像一致性方面击败了包括 GPT-5 和 Gemini-3-pro 在内的顶尖顶配模型。
痛点深挖:消失的栅栏与被重绘的天空
现有的生成模型(如 Flux.1 或 GPT-Image-1)在接收到“把建筑换成树”的指令时,虽然能完美种出一棵树,但往往会顺便把旁边的栅栏删了,或者强行重绘了原本不需要变动的天空。
现有的评估方法面临两大尴尬:
- Mask 的局限性:简单的掩码对比无法处理合理的全局变化(如物体改变后的投影变化)。
- 大模型的“老花眼”:强如 GPT-4o 或 Gemini,往往能看懂语义,却对像素级的纹理变形和微小的结构位移视而不见。
核心算法:StableI2I 的三维诊疗
StableI2I 将忠实度拆解为三个互补的维度:
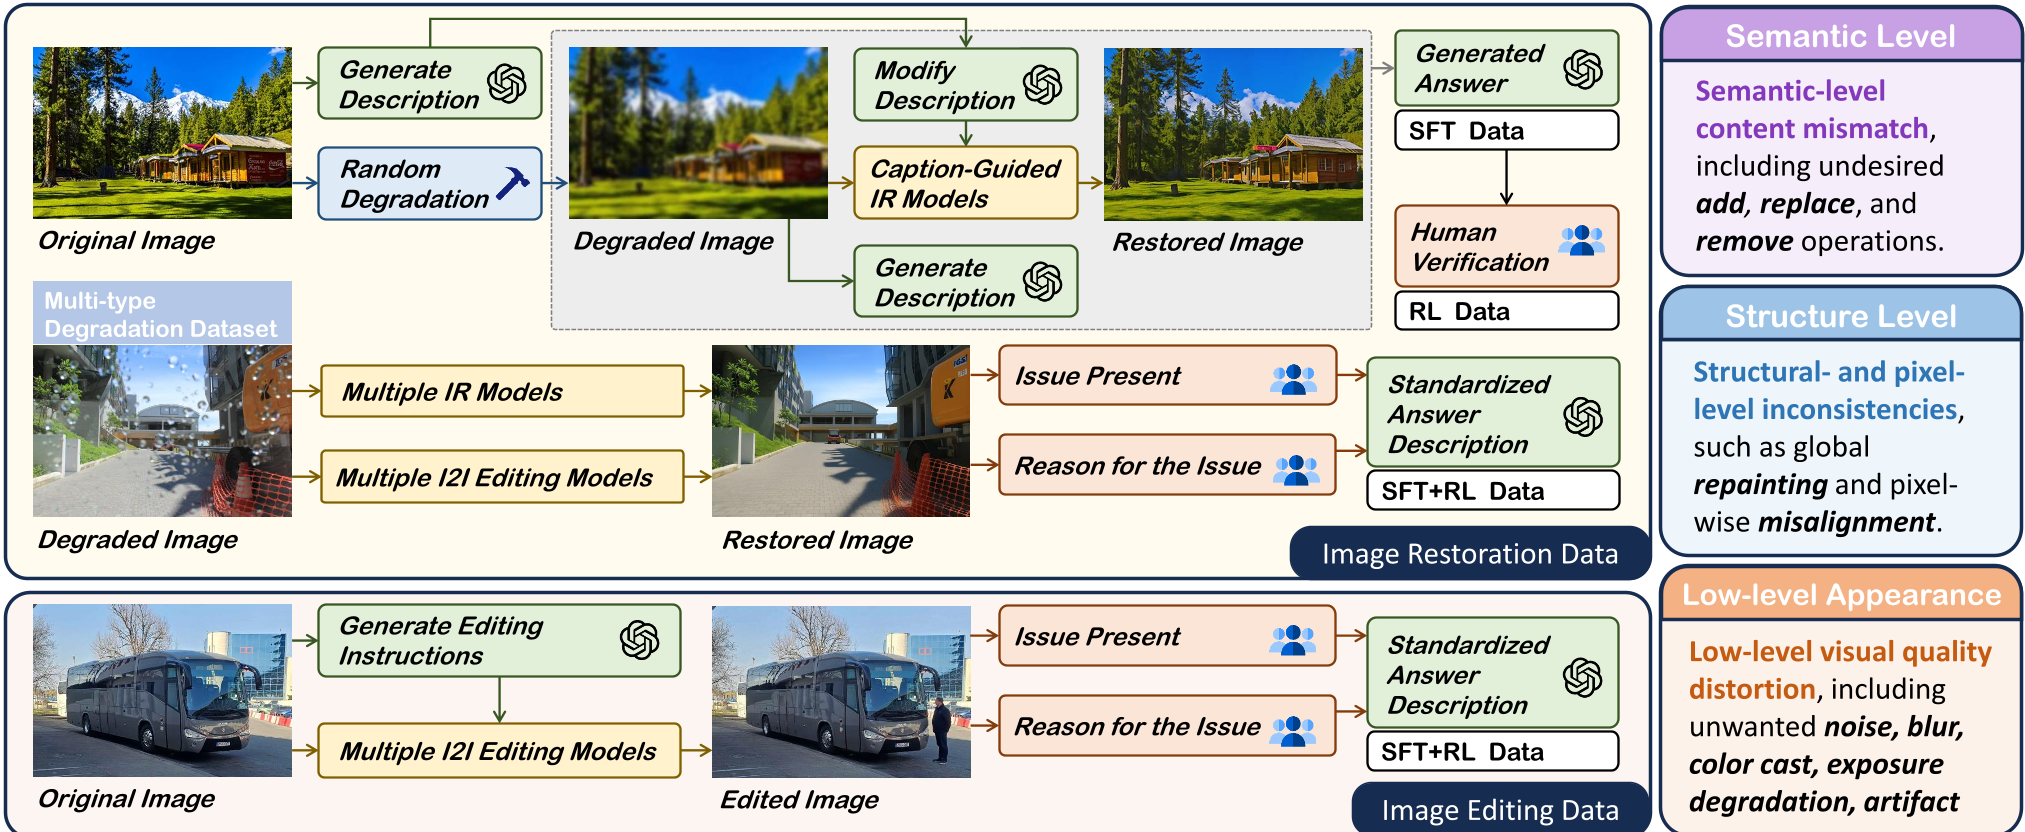
- Semantic Level:是否非预期地添加、删除了语义实体?
- Structure Level:是否存在像素错位、形状扭曲或纹理重绘?
- Low-level Appearance:是否引入了噪声、模糊或色偏?
特色的数据流水线:主动制造失败
为了让模型学会识别错误,作者设计了“误差放大”策略:在图像修复任务中,故意给模型喂错误的语义描述(通过 GPT-5 生成),诱导模型产生错误的修复结果。这种“负样本驱动”的思路极大地提升了模型对细节违规的敏感度。
实验战绩:反杀闭源大模型
在自建的 StableI2I-Bench 上,作者对比了目前市面上最强的视觉大模型。
| 模型 | 结构准确率 | 语义准确率 | 底层外观准确率 | 平均 |
|---|---|---|---|---|
| GPT-4o | 46.6% | 60.8% | 71.1% | 59.5% |
| Gemini-3-pro | 62.1% | 63.6% | 75.5% | 67.1% |
| StableI2I (Ours) | 83.7% | 67.3% | 98.0% | 83.0% |
深度洞察:
我们可以看到,StableI2I 在 Low-level (98%) 和 Structure (83.7%) 维度上几乎呈现降维打击。这证明了通过 Texture-Aware Enhancement(纹理感知增强数据)训练,MLLMs 可以获得极强的像素级对齐能力。
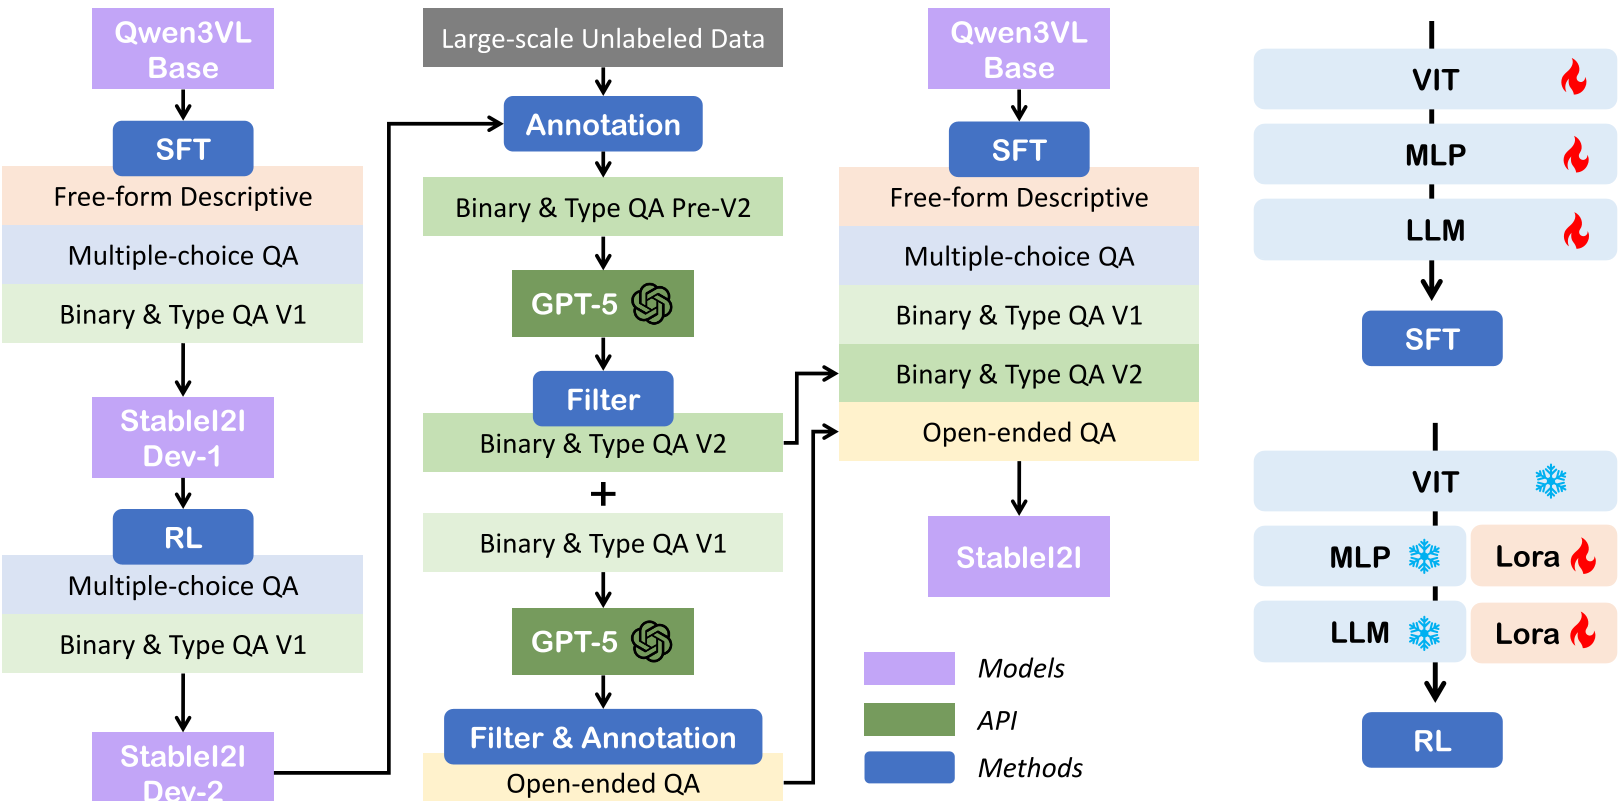 上图展示了 StableI2I 如何通过强化学习(GRPO)和 SFT 结合,最终获得诊断级的评估能力。
典型案例分析
StableI2I 的强大之处在于其解释性。当模型判断为“No”时,它能给出逻辑严密的 Think 链条:
- 场景:将歌手替换为拿气球的人。
- 诊断:背景从红色的体育馆变成了中性户外场景(判定为语义添加/替换错误)。
- 底层错误:检测到细微的色偏(Cool color cast)。

总结与局限
StableI2I 填补了 I2I 领域“细粒度忠实度评估”的空白。它证明了即便是在大模型时代,针对特定任务的视觉感官训练依然具有通用模型无法替代的精度。
局限性:在处理“风格迁移”等任务时,模型有时会将合理的风格渲染误判为“重绘(Repainting)”。未来,如何区分“必要的编辑意图”与“非预期的伪影”,仍是该领域值得探索的长远目标。