
STARFlow2:打破 Diffusion 统治,以“流”之名重塑自回归多模态架构
STARFlow2: Bridging Language Models and Normalizing Flows for Unified Multimodal Generation
本文提出了 STARFlow2,一种通过 Pretzel 架构将大语言模型 (LLM) 与自回归归一化流 (Normalizing Flows) 深度耦合的统一多模态生成框架。该方法实现了在单一因果 Transformer 流下同时进行文本生成与高保真连续图像生成,在 GenEval 图像生成基准上达到 0.82 的高分,并保持了强大的多模态理解能力。
TL;DR
Apple 团队近期发布的 STARFlow2 为多模态生成提供了一个极具竞争力的替代方案。它摒弃了主流的“LLM + Diffusion”混合架构,转而使用自回归归一化流(Autoregressive Normalizing Flows),实现了文本与连续视觉信号在同一个因果 Transformer 掩码下的完美融合。该系统支持“缓存友好”的交错图文生成,无需重新编码图像即可复用 KV-cache,在视觉质量与理解精度之间取得了难得的平衡。
痛点深挖:为什么“缝合怪”不是最优解?
目前多模态模型主要分为两派:
- 离散派 (Discrete Tokenization):将图像切成 Token 投喂给 LLM。这种方法架构最纯粹,但视觉信息在量化过程中损失严重,生成的图像往往缺乏细节。
- 混合派 (Diffusion Hybrids):LLM 负责文本,Diffusion 负责图像。尽管画质上去了,但两者机制格格不入——LLM 是单向因果生成,Diffusion 是双向去噪迭代。这意味着生成的图像无法像文本一样平滑地存入 KV-cache 供下一轮对话使用。
STARFlow2 的作者指出,一个真正的统一模型必须满足:保护 VLM 理解力 (D1)、生成连续高保真画质 (D2)、且结构上完全因果对齐 (D3)。
核心机制:Pretzel(蝴蝶酥)架构
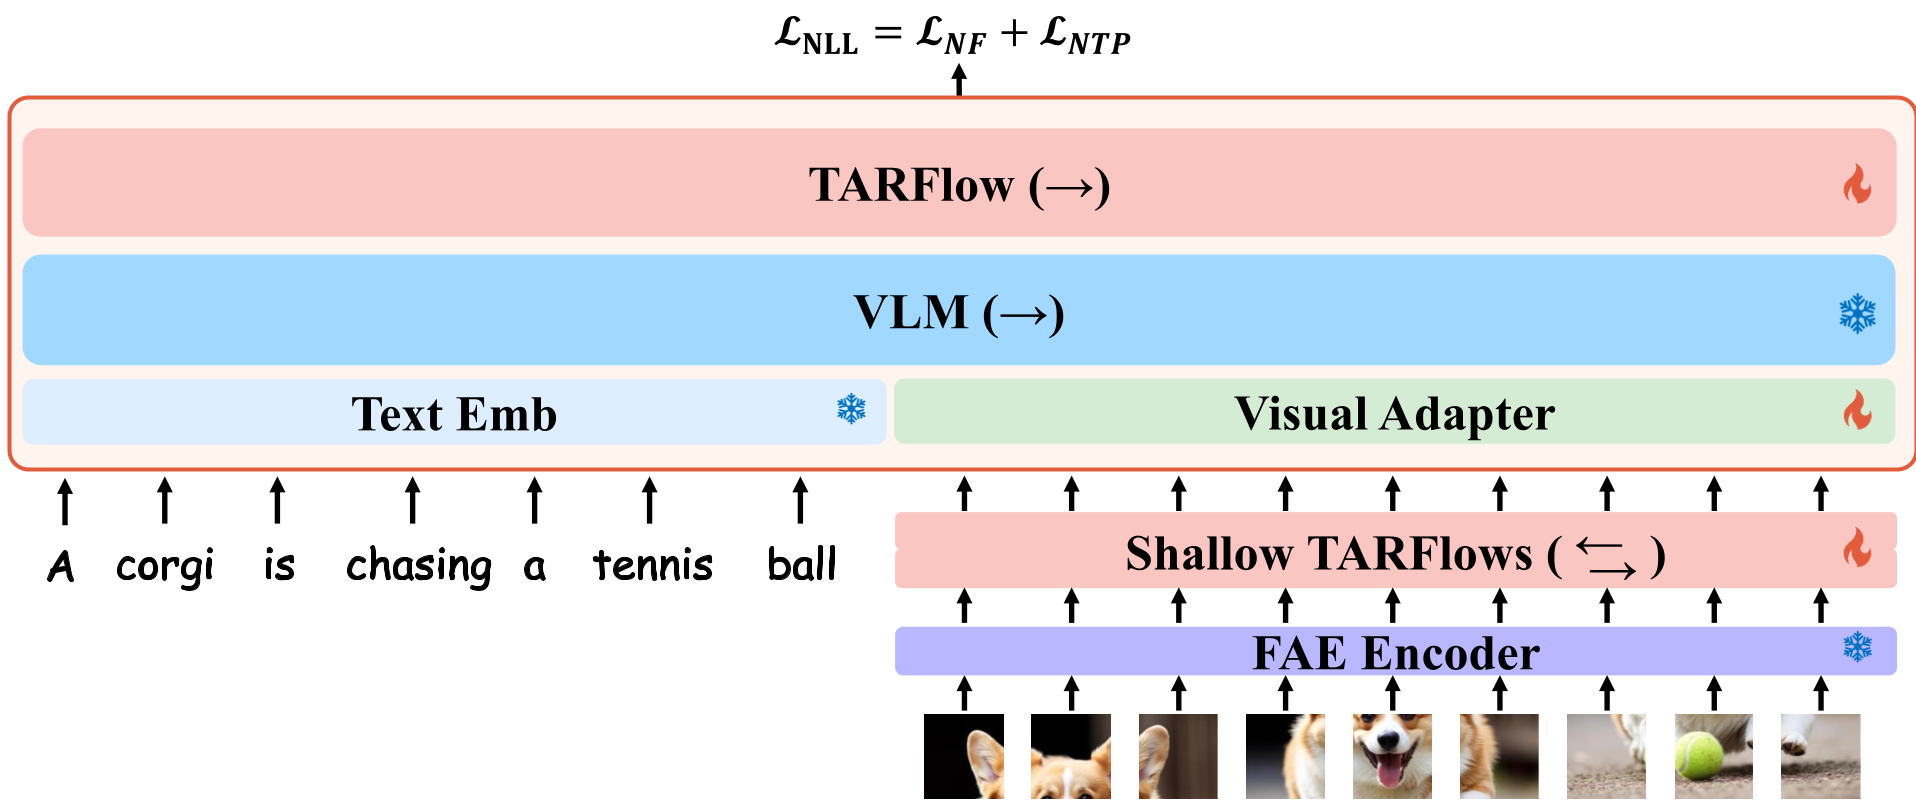
STARFlow2 的核心在于 Pretzel 架构。之所以起这个名字,是因为其内部 VLM 流与 TARFlow 流像蝴蝶酥的线条一样纵向交织。
1. 纵向交错而非横向路由
与常见的 MoT(Mixture-of-Transformers)不同,MoT 是将不同 Token 路由到不同参数块,而 Pretzel 让所有 Token 同时经过两个流:
- VLM 流 (Frozen):保留强大的预训练语义理解和推理能力。
- TARFlow 流 (Trainable):通过自回归流参数化连续图像潜空间。
2. 物理直觉:Next Gaussian Prediction
在 TARFlow 流中,模型不再是预测下一个词的概率,而是预测下一个像素/潜变量的高斯分布参数(均值 和缩放 )。这种“Next Gaussian Prediction”机制让图像生成在逻辑上等同于“Next Token Prediction”,从而能共用一套 KV-cache。
实验与结果:强强联合的飞跃
实验结果表明,通过垂直跳跃连接(Vertical Skip Connections),TARFlow 能够有效汲取 VLM 的高层语义信息。
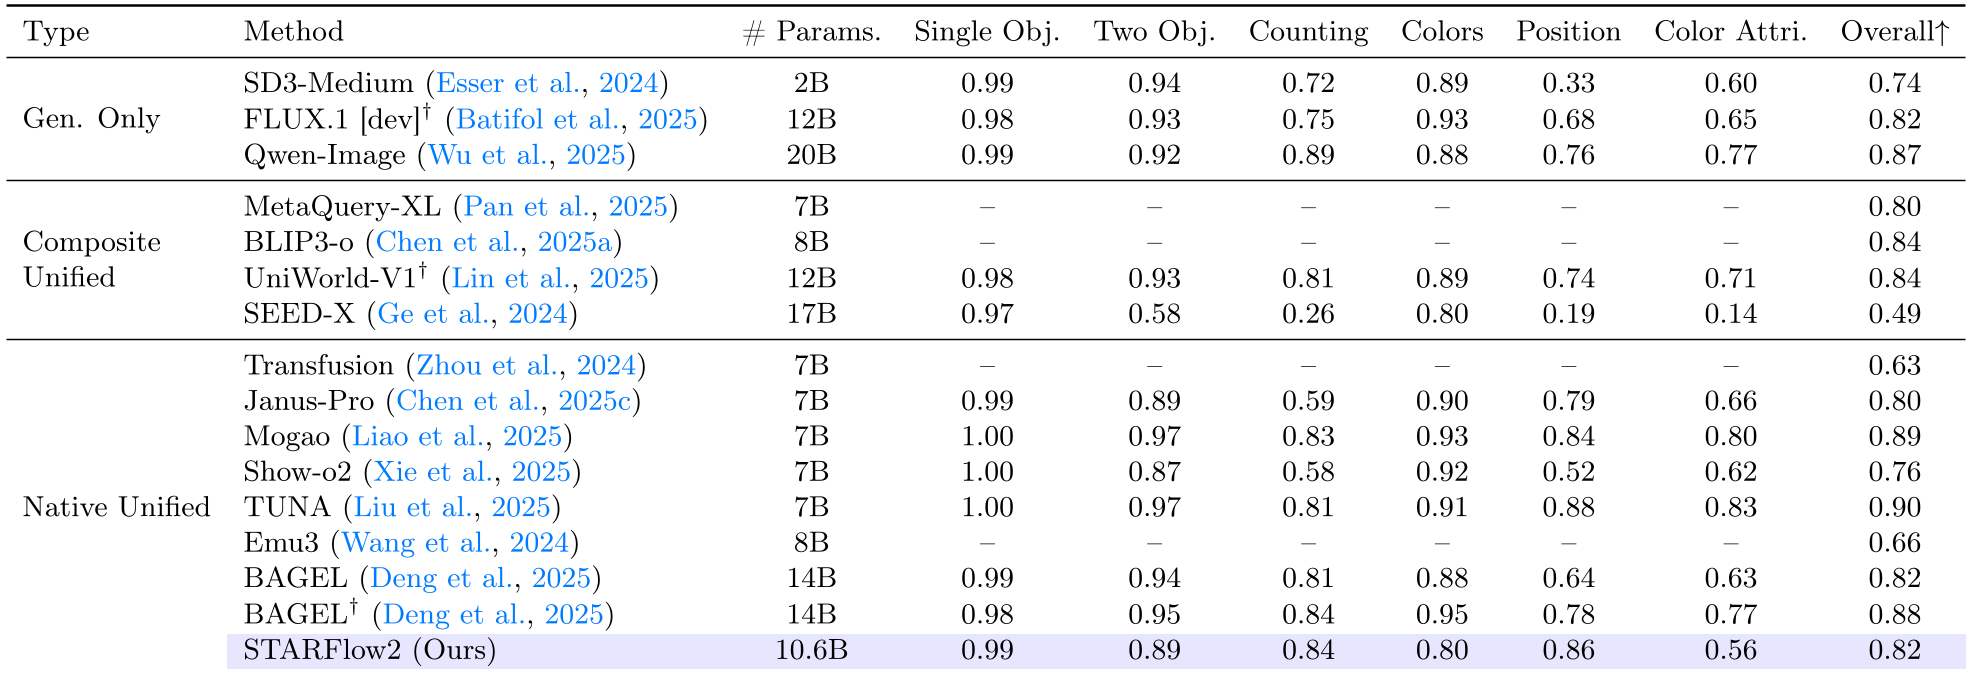
- 性能评估:在 GenEval 任务中,STARFlow2 拿到了 0.82 的高分,优于许多原生统一模型(如 Emu3)。
- 消融实验:论文证明了“垂直连接”优于“横向 MoT”。如果冻结 VLM 只练流,画质会塌缩;如果微调 VLM,理解力会严重下降。Pretzel 这种“冻结核心+残差引导”的方式解决了这一悖论。
深度洞察:迈向纯净的 AGI
STARFlow2 最令人兴奋的特性是它的缓存友好性 (Cache-friendly)。在处理像“帮我把这个男孩的衣服换成红色,并生成一段描述”这样的任务时,模型生成的图像潜变量可以直接作为后面文本生成的输入上下文,无需反复调用 Image Encoder。这种端到端的“闭环”是迈向实时交互式 AI 的关键。
总结与未来
Takeaway: STARFlow2 证明了自回归归一化流是统一图文建模的强有力竞争者。它避开了离散化的模糊和扩散模型的繁琐迭代。
局限性: 目前的分辨率受限于 FAE 编码器(256x256),且多阶段训练(Stage 1-3)流程较为复杂。 展望: 未来若能实现全参数端到端联合优化,并引入更高分辨率的原始像素嵌入,归一化流架构极有可能在效率和画质上全面超越当前的扩散模型基座。