
StateVLM:赋予机器人模型“状态”感知力,辅助回归损失突破数值推理瓶颈
StateVLM: A State-Aware Vision-Language Model for Robotic Affordance Reasoning
本文提出了 StateVLM,一种专门为机器人可操作性(Affordance)推理设计的状态感知视觉语言模型。该模型引入了辅助回归损失(ARL)训练策略,在保持推理端 Pix2Seq 格式的同时,显著提升了模型在物体检测、状态定位及抓取区域预测上的精度。
TL;DR
传统的视觉语言模型(VLM)在面对“物体检测”时,往往像是在背诵坐标文本,而非真正理解空间数值。StateVLM 通过引入一种辅助回归损失(ARL),在不改变原有 Transformer 推理结构的情况下,让模型在微调期间学会了“精细感知”。通过这种方式,它不仅能精准定位物体,还能识别物体是脏是净,并给出最佳抓取位置。
痛点深挖:离散 Token 无法承载连续空间
目前领域内的共识是:LLM 擅长文字处理,但不擅长数学运算和空间坐标。主流模型如 Shikra、Qwen-VL 采用的是 Pix2Seq 范式,即把坐标 [x, y] 看作单词。
这种方案存在两个硬伤:
- Inductive Bias 缺失:离散的 Token 无法体现数值之间的连续性(例如 0.51 和 0.52 在 Token 空间中可能毫无关联)。
- 训练效率低下:在有限的算力下,模型很难仅通过交叉熵损失来学习高精度的回归任务。
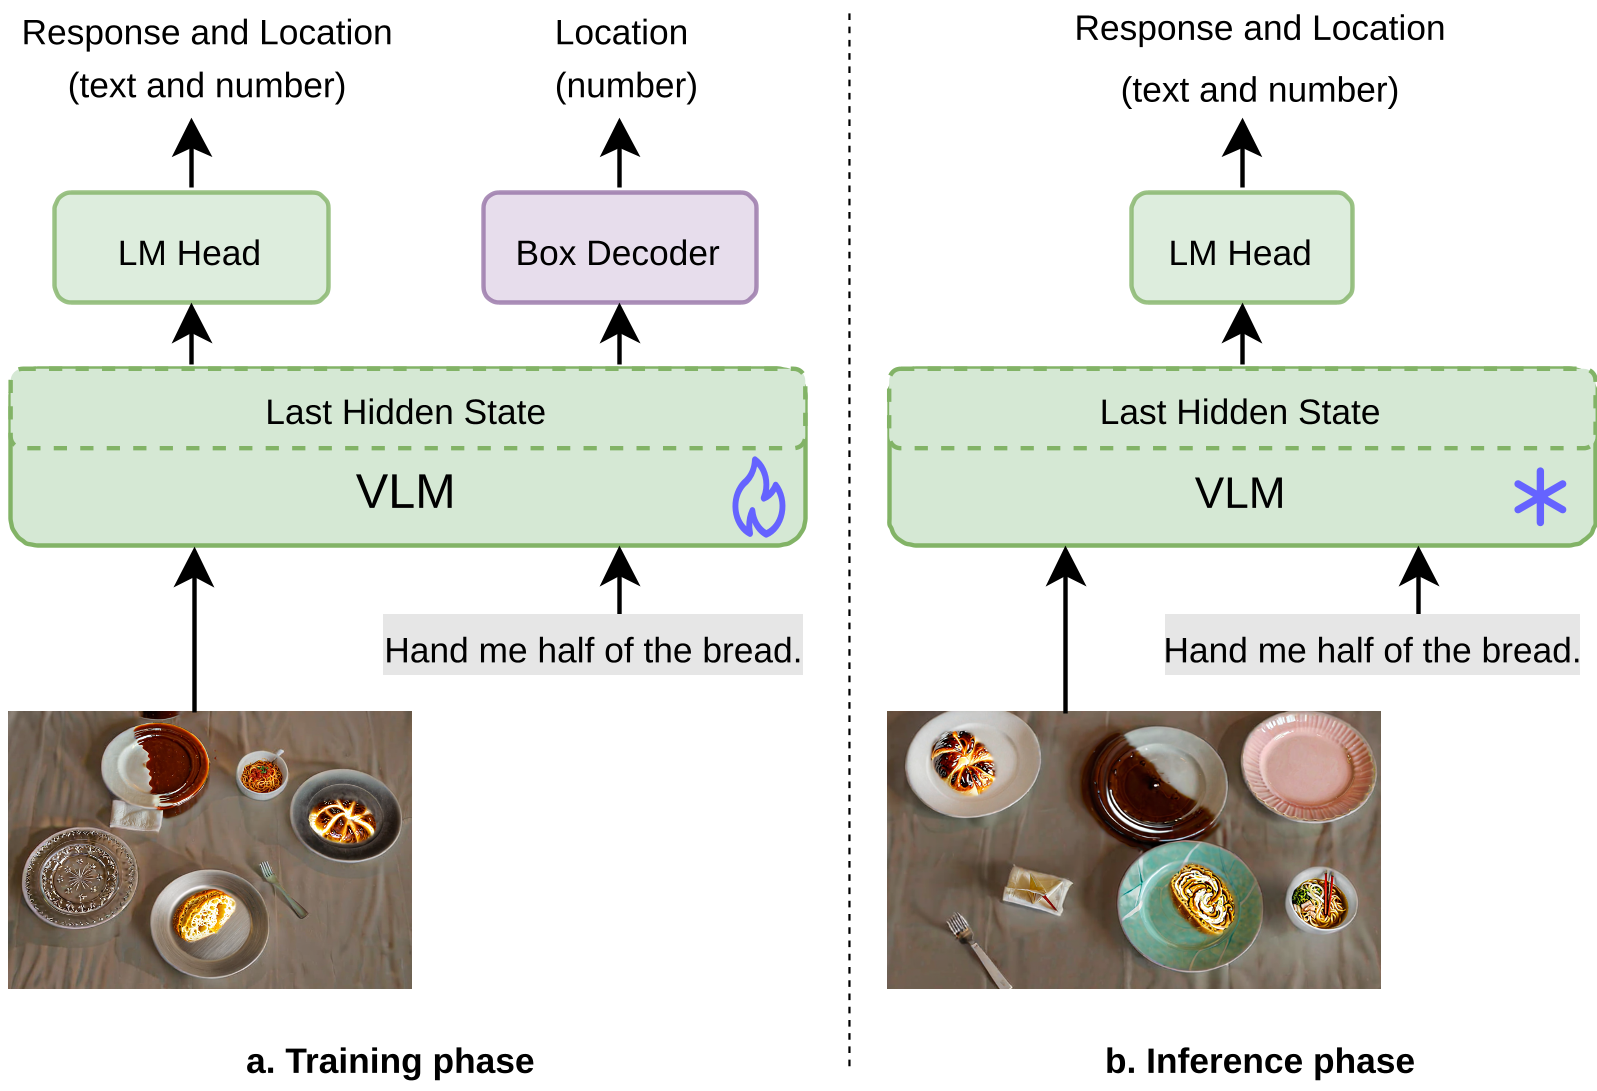
关键直觉:用回归牵引序列
StateVLM 的核心贡献在于其**“进可攻,退可守”**的训练策略。
ARL 辅助回归损失
作者在训练时给 LLM 挂了一个轻量级的 Box Decoder(由两层 MLP 组成)。这个 Decoder 接收 LLM 的隐藏层输出,直接预测连续的坐标值。此时,总损失函数变为: 其中 结合了 L1 Loss 和 GIoU Loss。这种设计的精妙之处在于:
- 训练期:ARL 像是一个严厉的老师,强迫 LLM 的隐藏层表征具备更强的空间数值意义。
- 推理期:拆掉 Box Decoder,模型依然输出标准的文本坐标,保持了与下游任务的兼容性。
实验与结果:不仅是 SOTA,更是“一致性”的胜利
作者在 RefCOCO 系列数据集和自建的 OSAR(物体状态可操作性推理) 数据集上进行了验证。
核心战绩
- 性能普适性提升:在 RefCOCO 基准上,ARL 版本比纯 CLM 版本平均提升了 1.6%。
- 解决“胡言乱语”:在复杂的机器人抓取推理任务中,传统的 Pix2Seq 模型经常输出错误的坐标格式(Exception Rate 高达 33.36%),而 StateVLM 通过 ARL 约束,将异常率降为了 0%。
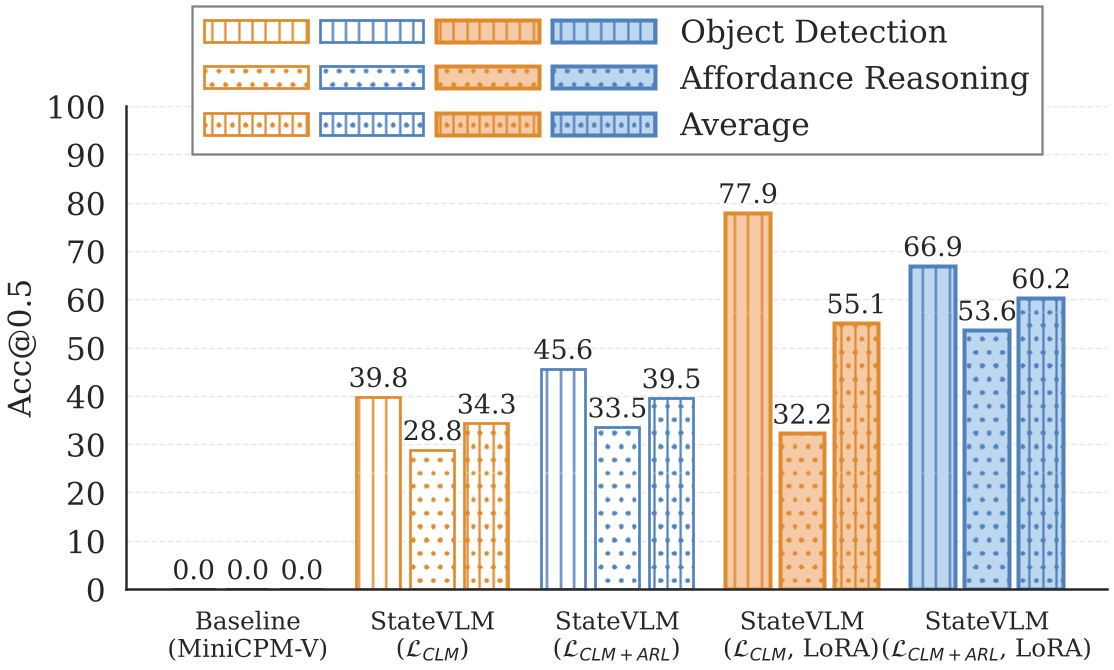
消融实验:为什么 ARL 有效?
实验显示,StateVLM (LCLM+ARL) 的验证损失曲线比单纯的序列预测模型更加平滑且持续下降。这意味着 ARL 成功缓解了 LLM 在处理数值坐标时的**过拟合(Overfitting)**倾向,有效增强了模型的泛化能力。
机器人视角:从“看到物体”到“理解状态”
为了贴合真实家庭场景(如清理餐桌),作者提出了 OSAR 基准。
- 物体状态定位:不仅要找叉子,还要找“干净的叉子”。
- 可操作性推理:如果刀尖上有食物残渣,模型需要指出应该抓取刀柄部位。
这种细粒度的感知能力,是未来通用 Embodied AI 走向复杂环境的关键。
深度总结与局限性
StateVLM 提供了一个极具性价比的 VLM 适配方案:不需要重构臃肿的底座,仅需在微调阶段加入回归约束。
局限性探析:
- 数据集生成:目前 OSAR 数据集依赖 Stable Diffusion 辅助生成,虽然经过人工校验,但与真实世界的物理交互细节(如光影对材质判断的影响)仍有差距。
- 复杂指令:目前对于模糊指令(如“随便拿个东西”)的处理还有待加强。
展望:StateVLM 的成功表明,未来机器人大脑不仅需要强大的逻辑推理,更需要通过回归手段强化其物理空间常识。