
引导而不牺牲:大模型转向向量的原则性训练与 Prompt 局部干预
Towards Steering without Sacrifice: Principled Training of Steering Vectors for Prompt-only Interventions
本文提出了 PrOSV (Prompt-Only Steering Vector) 方法及一种基于神经缩放理论的联合训练方案,旨在通过仅在 Prompt 阶段干预极少数 Token 来控制大语言模型的行为。在 AXBENCH 评估中,该方法配合 SimPO 目标函数,在基本不损失模型通用能力的前提下,实现了 SOTA 的概念引导效果。
TL;DR
传统的转向向量(Steering Vectors, SV)虽然轻量,但往往面临“大力出奇迹”后的副作用:生成质量暴跌、超参数调试如玄学。本文提出的 PrOSV (Prompt-Only Steering Vector) 通过“联合训练”与“局部干预”两大杀手锏,实现了在仅干预 4 个 Prompt Token 的情况下,达成超越全序列干预的效果,且几乎不损害模型的数学和通用推理能力。
背景定位:转向向量的工程化困境
转向向量是机械解释性(Mechanistic Interpretability)领域的一颗明珠,它通过在模型表征空间加一个方向向量来改变模型行为(例如让它表现得更诚实或谈论金钱)。然而,现状是遗憾的:
- 推理时的苦力劳动:必须为每个任务手动筛选转向因子(Factor),可扩展性极差。
- 效用崩溃:全序列干预(FSSV)像在模型每一步生成时都强行“推一把”,导致模型注意力机制紊乱,逻辑能力受损。
核心动机:为什么要联合训练?
作者通过 神经缩放理论 (Scaling Theory) 发现,如果我们把转向因子()和方向()看作独立的训练参数,它们之间存在严格的配对关系。通过公式推导,发现学习率的乘积应维持在 量级。这使得我们不再需要在推理时“拍脑袋”试参数,而是在训练阶段一次性解决。
方法论:PrOSV 深度拆解
PrOSV 的直觉非常优雅:我们不需要在生成(Decode)时一直监控模型,只需要在输入(Prompt)阶段适当地“调包” KV Cache。
1. 架构解析
PrOSV 放弃了对响应 Token 的干预,转而专注于 Prompt 的前缀(Prefix)和后缀(Suffix)。
- 干预位置:实验证明
p2+s2(前 2 个 Token + 后 2 个 Token)是平衡转向强度与效用的甜点位。 - 机制直觉:通过修改 Prompt 的表征,隐式地编辑了 KV Cache,使模型在后续解码时自然地产生目标行为。
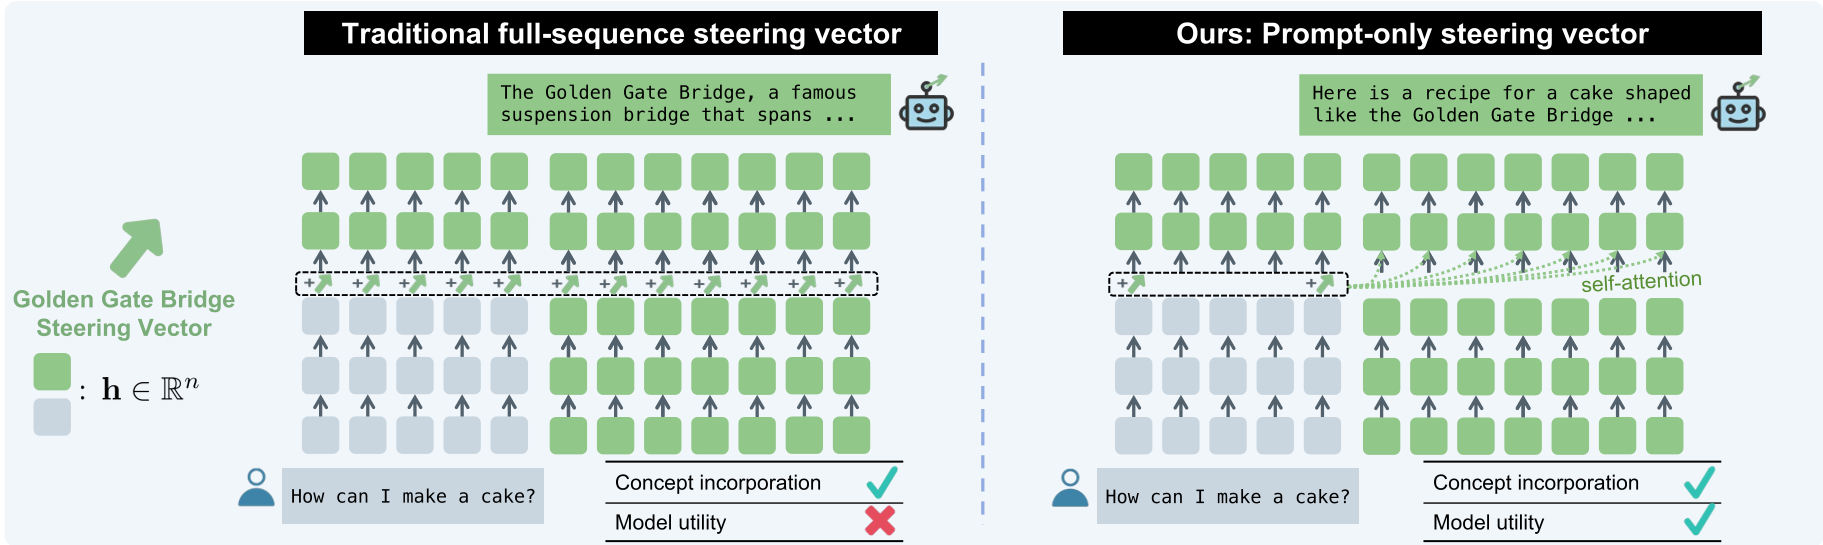 图 1:传统 FSSV 在 Decode 阶段持续干预,导致效用牺牲;PrOSV 仅在 Prefill 阶段干预,保持了生成的纯净性。
实验与结果:算力与效能的双重胜利分析
作者在 Gemma2 和 Qwen2.5 等最新模型上进行了大规模测试(AXBENCH 500 个概念)。
1. 转向表现与通用能力的平衡
在 tinyGSM8K 数学任务中,PrOSV 的优势被无限放大。传统 FSSV 因为在计算数学步骤时不断被向量干扰,准确率惨不忍睹;而 PrOSV 因为生成阶段未受物理干预,保留了原始模型近 80% 的数学推理精度。
2. 注意力机制的可视化证据
通过可视化发现,FSSV 会强行让模型的所有 Token 关注 BOS Token,导致正常注意力模式消失。而 PrOSV 的注意力热力图与原始模型惊人地一致,这解释了其为何能“润物细无声”。
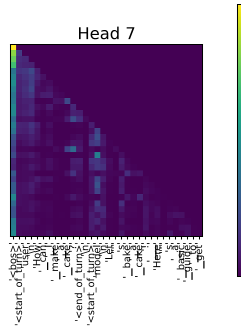 图 2:PrOSV(b)保持了健康的注意力流,而 FSSV(c, d)导致了注意力的病态坍缩。
深度洞察与总结
核心贡献(Takeaway)
- 工程友好:联合训练协议让 SV 的部署从“手工调优”转变为“原则驱动”。
- 效率革命:37 倍的计算开销降低对于大规模在线推理具有极高的产业价值。
- 效用对冲:证明了“局部干预”不仅足够,而且比“全局干预”更好。
局限性与展望
尽管 PrOSV 在大型模型上表现稳健,但在超长上下文(>1K tokens)中的引导力在小模型上会有所稀释(可能因为 KV Cache 被稀释了)。未来的研究可能会探索动态位置的干预,或将此方法扩展到控制模型的更复杂逻辑(如反欺骗攻击等)。
结论:这是一篇将“解释性工具”向“可靠工程工具”转化的佳作,推荐所有关注大模型对齐与可控生成的开发者阅读。