
UNO:以理解之“翼”引导视觉生成,打破统一模型的解耦瓶颈
Steering Visual Generation in Unified Multimodal Models with Understanding Supervision
本文提出了 UNO (Understanding-Oriented Post-Training),这是一个轻量级的统一多模态模型后训练框架。该方法通过引入语言监督(Captioning)和视觉理解监督(Visual Regression),将理解信号作为梯度直接引导生成表示的学习,显著提升了图像生成与编辑的语义一致性。
TL;DR
在多模态模型(UMM)领域,理解与生成的“能力协同”一直是圣杯。清华大学与快手团队提出的 UNO (Understanding-Oriented Post-Training) 框架,巧妙地利用模型已有的理解能力来“教”它如何生成。通过将理解专家的梯度回传给生成模块,UNO 在不增加架构复杂度的前提下,显著提升了图像生成的指令遵循度(GenEval2 +3.4)和编辑的语义准确性。
1. 现状痛点:同床异梦的“统一”模型
理想中的统一多模态模型应该能像人类一样,因为看得懂(Understanding),所以画得好(Generation)。但现实是,为了追求 SOTA 性能,目前如 BAGEL、Janus 等模型普遍采用解耦表示——理解和生成在内部几乎是两个平行的世界。
- 痛点:生成任务通常只受低级损失函数(如 Flow-matching MSE)驱动,这让模型在像素细节上很努力,但在语义理解上很“迟钝”。
- 动机:既然模型本身就是一个强大的“理解专家”,为什么不让它作为监考官,直接监督生成过程中的中间表示呢?
2. 核心机制:UNO 的“左右互搏”
UNO 的核心直觉是:让生成表示通过理解专家的考核。
2.1 信息流重路由
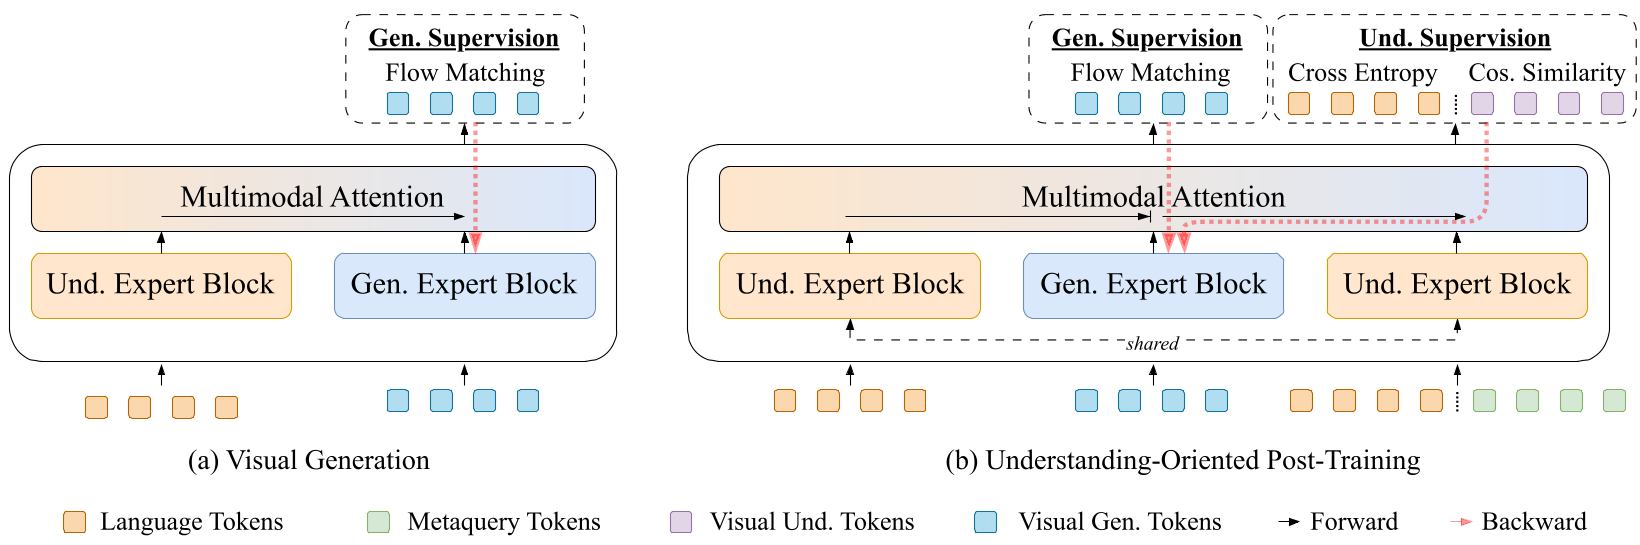
在 UNO 中,作者将带噪声的中间生成表示(Noised Generative Representations)输入到冻结的理解专家中。
2.2 双重监督任务
为了全方位覆盖语义,UNO 提出了两种互补的监督:
- 语言监督 (Captioning):要求模型根据生成的中间特征写出描述。为了防止模型通过“偷看”Prompt 走捷径,作者引入了 Semantic Augmentation(用不同的词描述同一图像),强制模型进行真实的语义提取。
- 视觉理解监督 (Visual Regression):引入 MetaQuery 令牌,要求模型回归出目标图像的密集视觉特征,确保生成的图像在空间结构和细节上也是合理的。
3. 实验战绩:全线飘红
在 BAGEL-7B 基础上,UNO 证明了理解信号是生成任务的绝佳“催化剂”。
3.1 量化提升
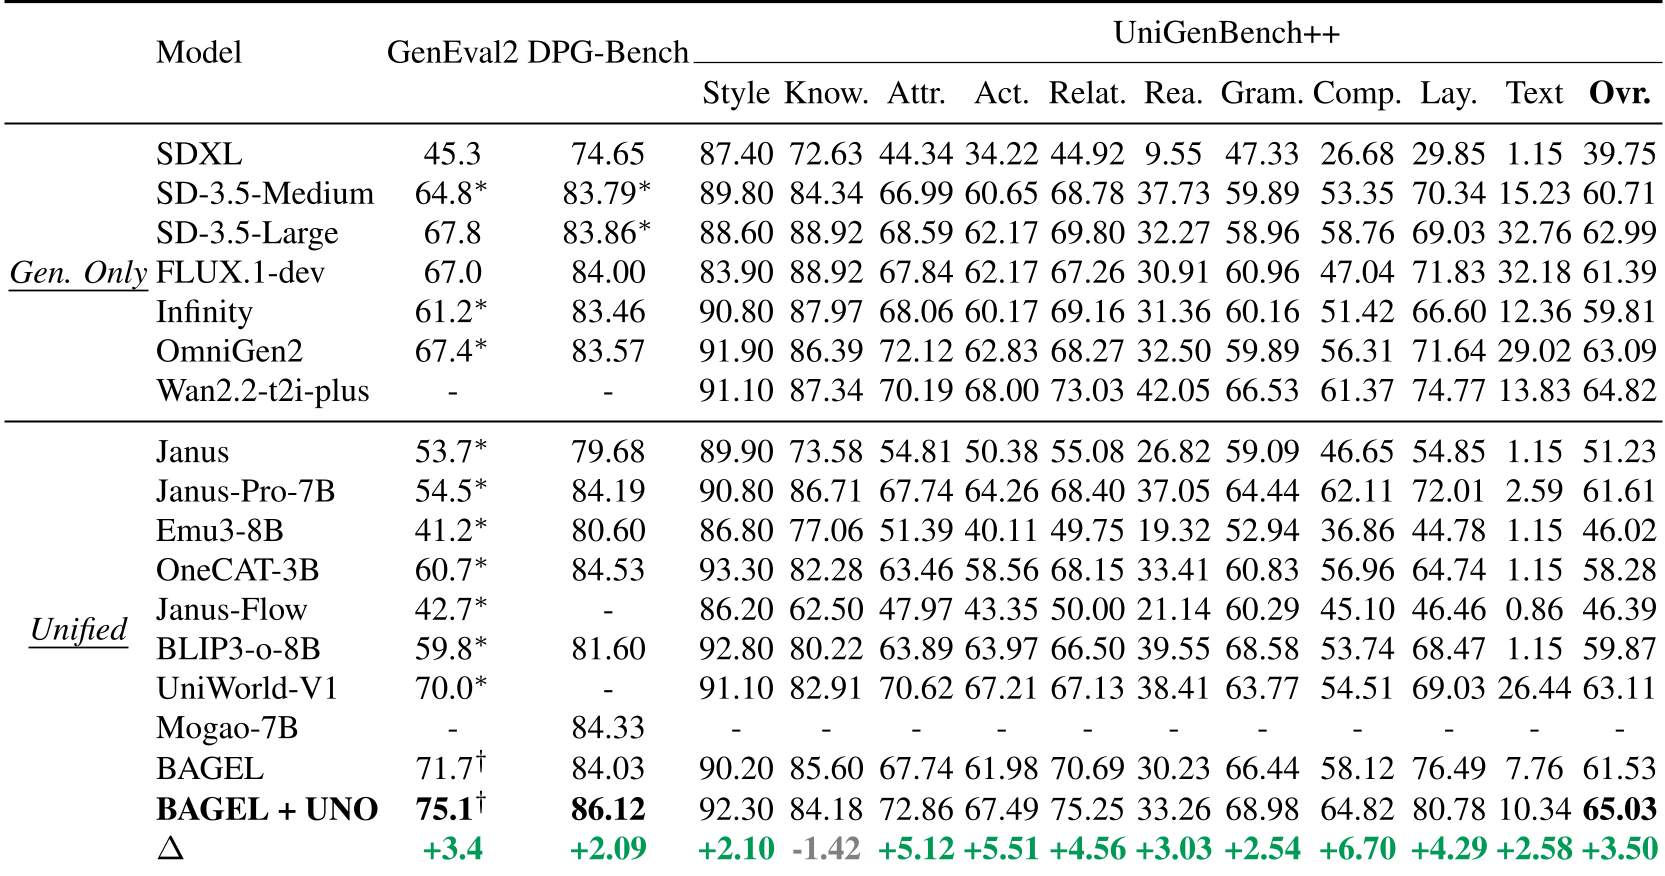
在衡量语义符合度的 UniGenBench++ 榜单上,UNO 在属性(Attribute)、行为(Action)和关系(Relationship)等核心指标上提升尤为明显,整体得分从 61.53 跃升至 65.03。
3.2 潜空间可视化:更干净的语义
通过 PCA 对高噪声时间步的特征进行可视化发现,经过 UNO 训练后的特征在早期阶段就展现出更清晰的语义轮廓,背景噪声更少,细节保留更完整。

4. 深度洞察:为什么 UNO 有效?
作者通过梯度相似度分析(Gradient Similarity)发现,理解任务产生的梯度与生成任务的梯度在大部分层中是正交或正向对齐的。这意味着加入理解监督并不会造成优化冲突,反而提供了生成目标(MSE)所欠缺的高级语义引导。
5. 局限与未来
尽管 UNO 效果显著,但它目前尚未深度利用垂直领域的专业数据(如知识图谱)。未来,将这种“理解驱动生成”的思路扩展到多步推理和更复杂的世界建模中,将是迈向真正统一智能的关键一步。
总结:UNO 告诉我们,与其设计更复杂的架构,不如更好地利用模型已有的“知识”。这种对内部梯度流的重新设计,为统一模型的性能压榨提供了一个优雅且高效的新范式。