
Stream-R1:打破蒸馏上限,当视频生成学会“重点突破”
Stream-R1: Reliability-Perplexity Aware Reward Distillation for Streaming Video Generation
本文提出了 Stream-R1,一个针对流式视频生成模型的可靠性-困惑度感知奖励蒸馏框架。该方法通过引入预训练视频奖励模型的梯度信息,显著提升了自回归视频扩散模型在蒸馏加速后的生成质量,在 VBench 等基准测试中超越了多步迭代的 Teacher 模型。
TL;DR
传统的模型蒸馏通常被视为一种“打折”:学生模型用更少的计算量去模仿老师。但 Stream-R1 告诉我们,学生不仅能跑得比老师快,甚至能考得比老师好。通过引入可靠性-困惑度感知 (Reliability-Perplexity Aware) 机制,Stream-R1 在流式视频生成任务中,让蒸馏后的 4 步学生模型在质量上反超了多步迭代的 Teacher 模型,同时推理速度提升了 30 倍。
痛点深挖:平等的蒸馏是不效率的
目前的视频模型蒸馏(如 DMD)存在一个直觉上的盲点:它对所有监督信号“一视同仁”。
作者指出,这忽略了两个关键的方差轴:
- Inter-Reliability (样本间可靠性):Teacher 模型本质上是个降噪器。如果学生生成的视频太烂,超出了 Teacher 的“知识范围”,Teacher 给出的修正方向可能是乱指的。
- Intra-Perplexity (样本内困惑度):在一帧画面里,有些背景已经很完美了,继续优化是浪费能量;而有些运动物体(如变形的脸)则亟需更强的关注。
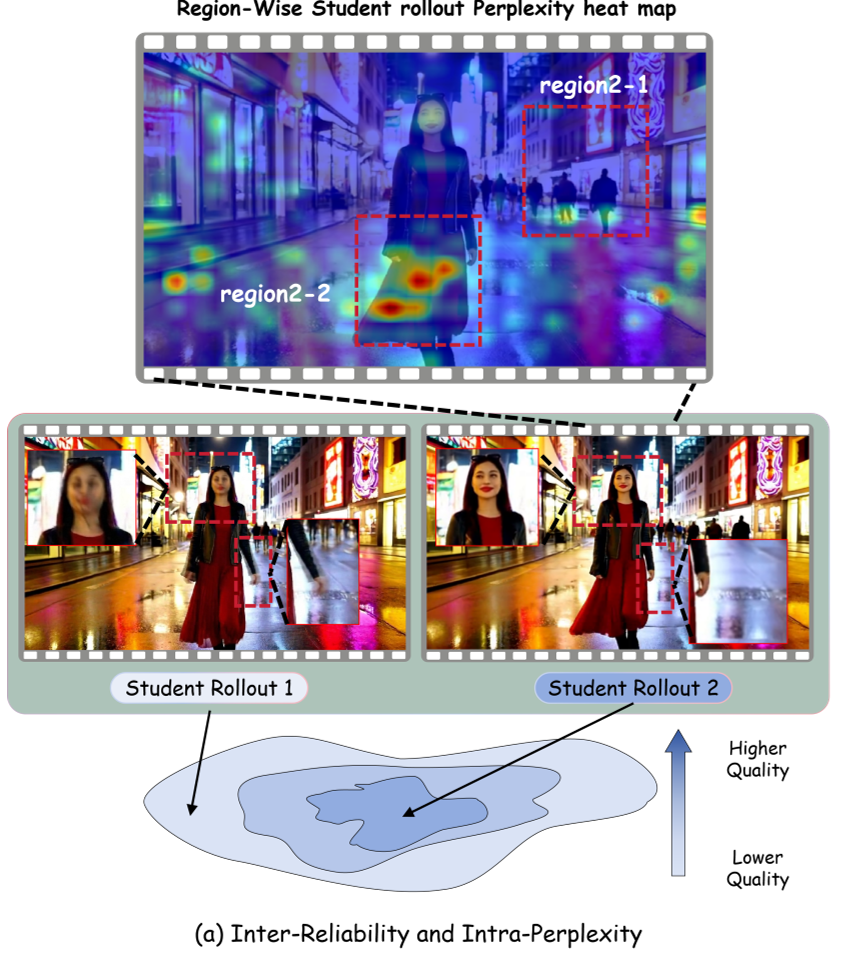
方法论:把 Reward 模型当成“精密仪表”
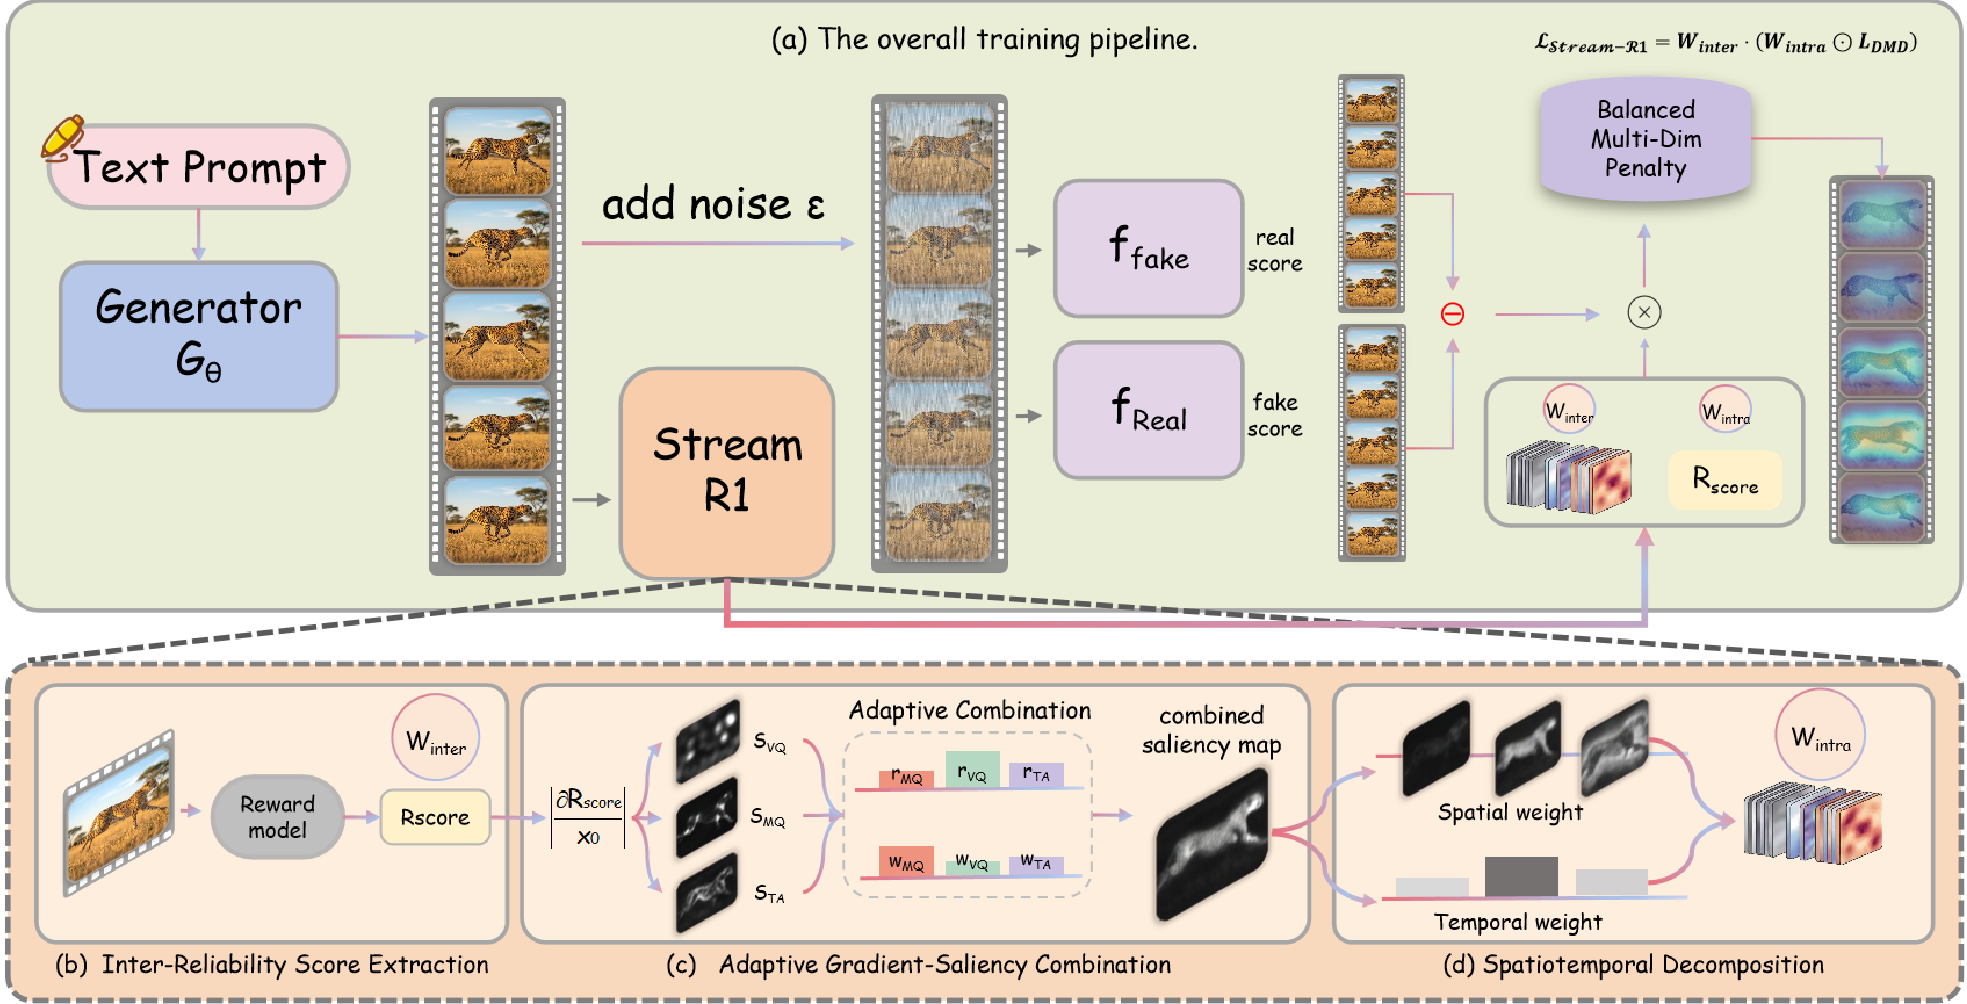
Stream-R1 并没有简单地把 Reward 当成一个分数,而是通过反向传播 (Back-propagation),把 Reward 模型变成了一个带导航功能的“梯度放大器”。
1. 让“靠谱”的样本说话 (Inter-Reliability Weighting)
系统会给每个生成的序列打分。得分高的样本(位于 Teacher 掌握得好的高质分布区)会被赋予更高的 Loss 权重。这保证了模型是在学习正确的“捷径”,而不是在错误的方向上死磕。
2. 哪里不好补哪里 (Intra-Perplexity Weighting)
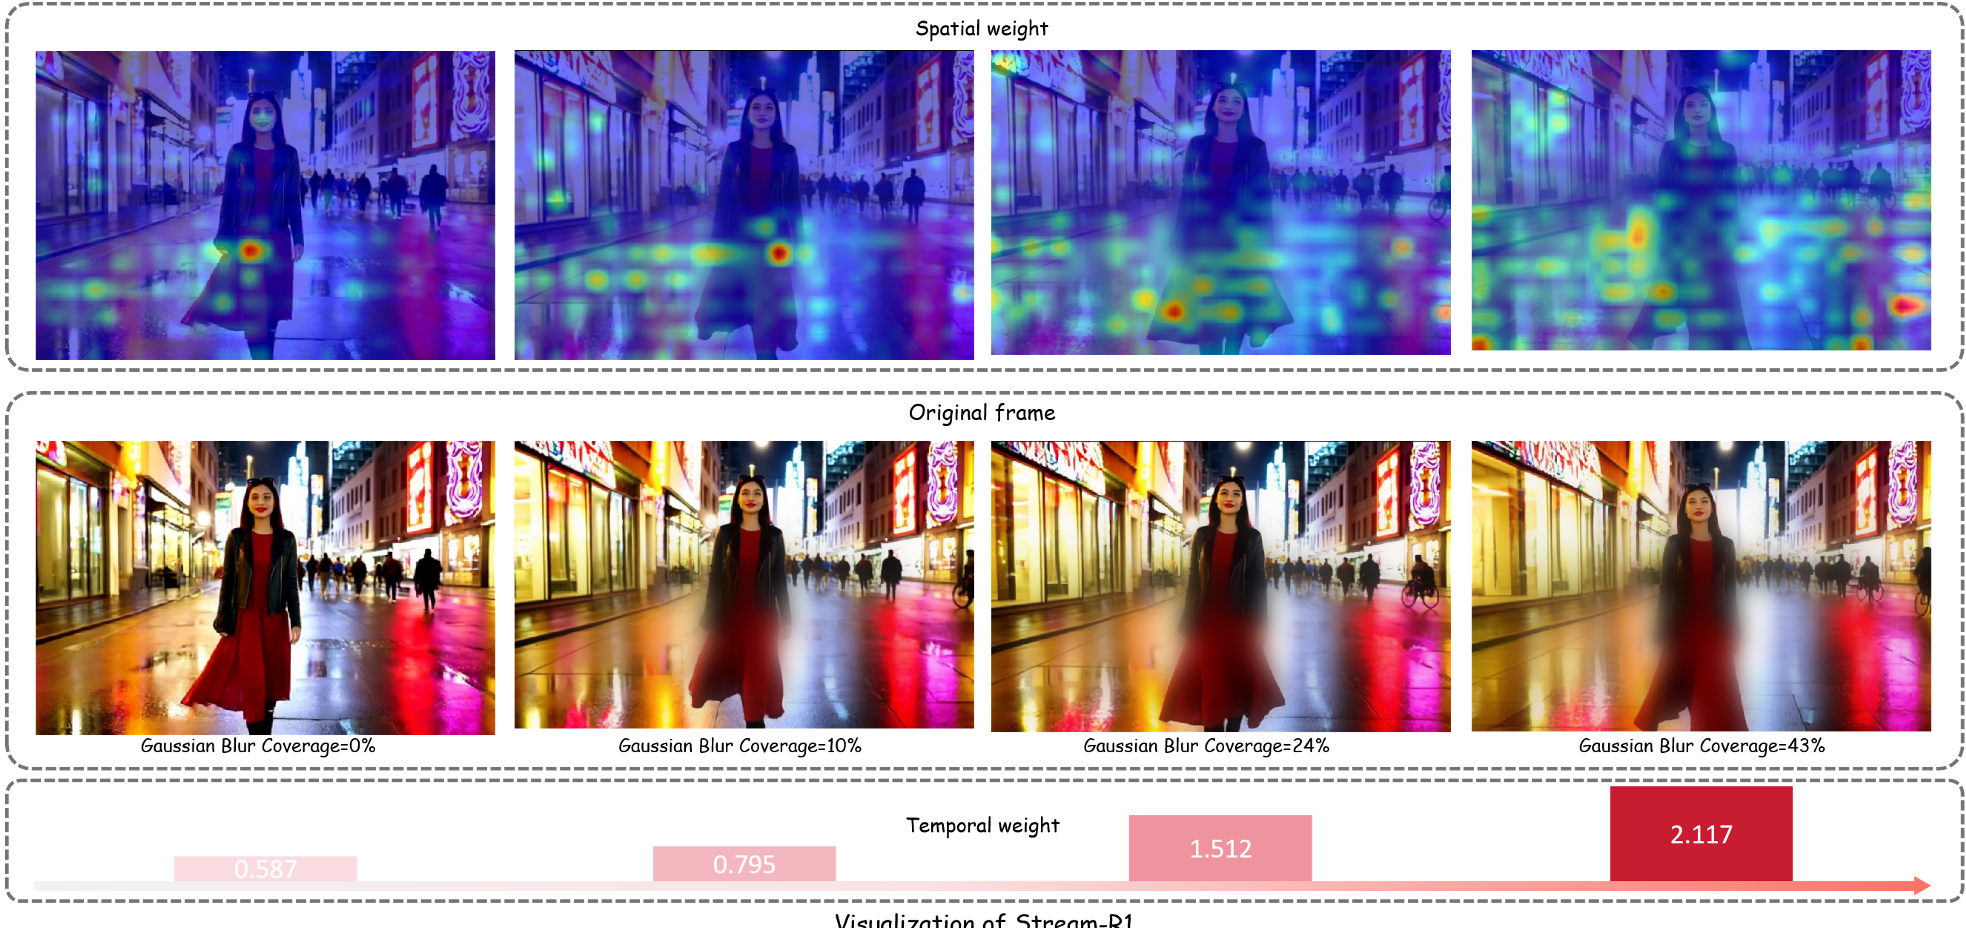
这是本文最惊艳的技术细节。通过对视频奖励模型求导,提取像素级显著图 (Saliency Map)。
- 空间维度:识别人眼中觉得违和的区域。
- 时间维度:识别内容漂移、动作不连贯的特定帧。
这些显著性信息被分解并重新加权到蒸馏 Loss 中,让优化器(Optimizer)把火力集中在画面中质量最差、提升空间最大的位置。
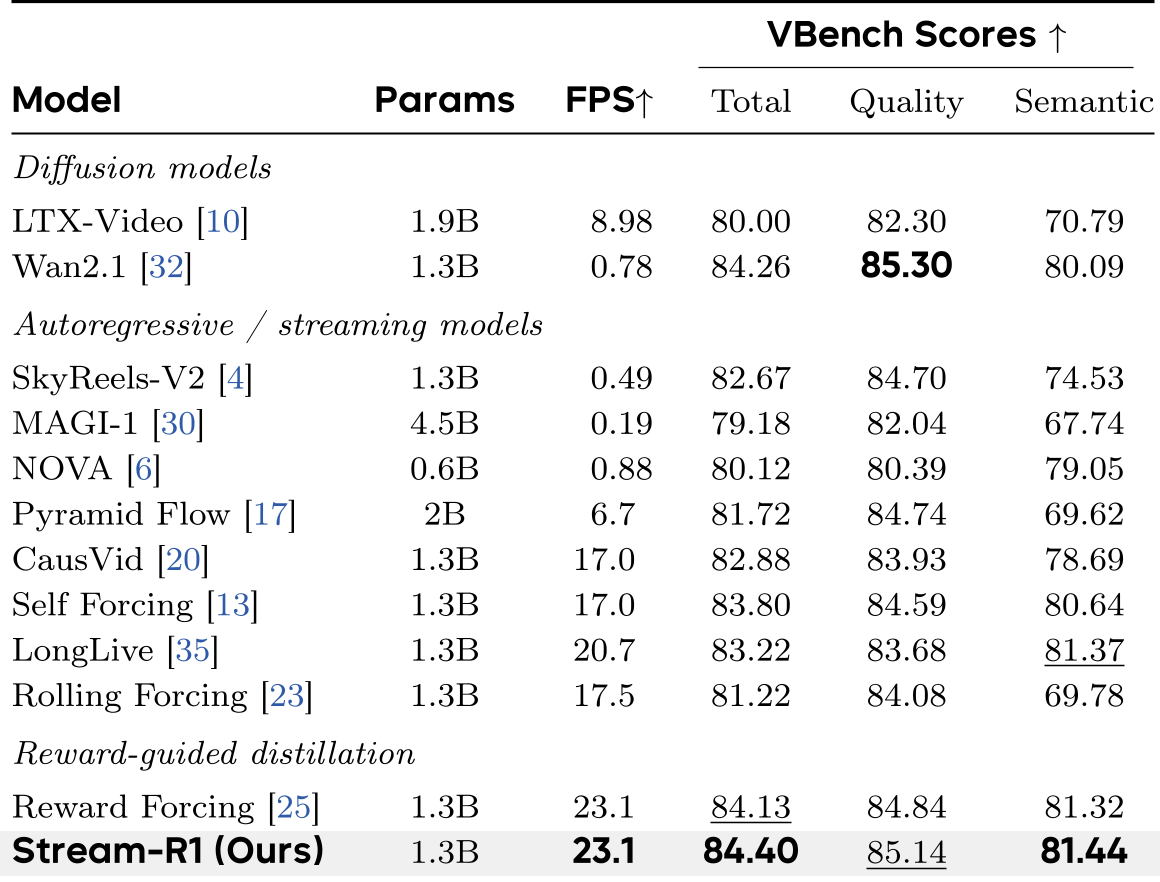
实验战绩:反杀 Teacher 模型
Stream-R1 基于 Wan2.1-1.3B 架构进行实验,表现出了统治级的 SOTA 性能:
- 短视频表现:在 VBench 测试中,Stream-R1 总分为 84.40,不仅秒杀了一众流式生成模型(如 LongLive, Self Forcing),还超过了它的母体 Teacher Wan2.1 (84.26)。
- 长视频耐力:在生成 120 秒甚至 180 秒的长视频时,Stream-R1 的质量跌落极小,成功解决了自回归生成中常见的“画质漂移”难题。
在可视化的消融实验中,我们可以清楚地看到:当人工给视频画面注入局部模糊时,Stream-R1 的 Saliency 机制会迅速锁死这些模糊区域并自动调高 Loss 权重。
总结与洞察
Stream-R1 的成功在于其对“监督资源”的精确分配。在 AI 已经进入“卷 Reward”的时代,这篇文章提供了一个新思路:不要只把 Reward 模型当裁判,要把它当成手术刀。
局限性:虽然训练效率高,但对预训练视频奖励模型的质量有极强的依赖。如果奖励模型本身对某种运动(如复杂手势)不敏感,Stream-R1 的引导就会失效。
随着 DeepSeek 等模型在推理侧的突破,这种“强化学习指导的精准蒸馏”可能会成为下一代视频生成、多模态实时交互的标准范式。