
Super Apriel:一个 Checkpoint,多种速度,LLM 推理进入“变速箱”时代
Super Apriel: One Checkpoint, Many Speeds
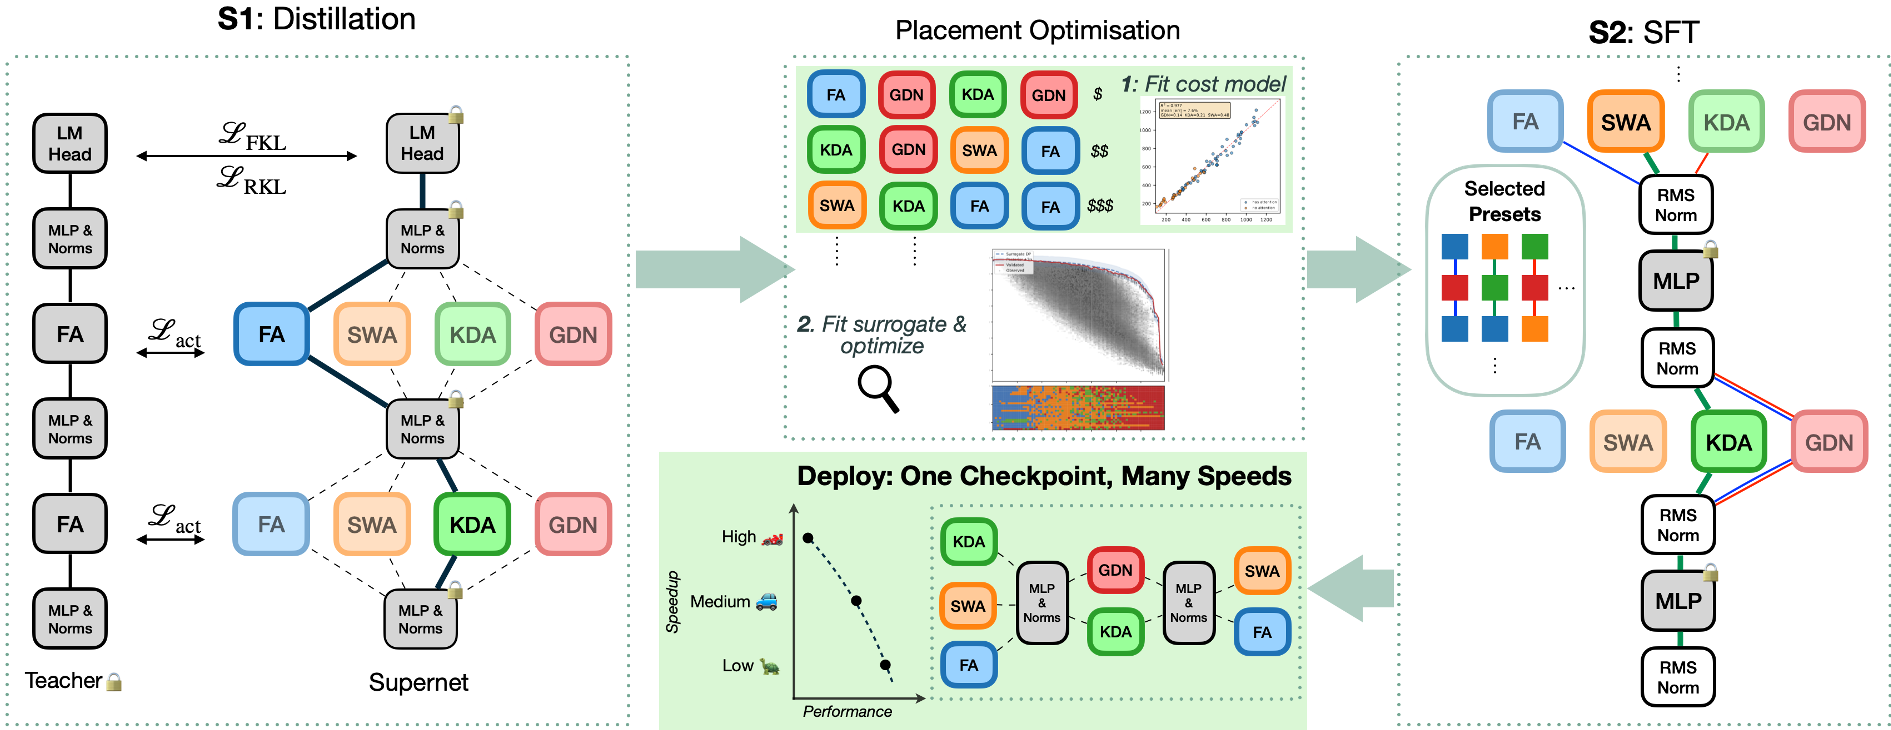
本文推出了 Super Apriel,这是一个拥有 15B 参数的 Token-mixer Supernet。其核心贡献在于:模型每一层都提供了四种可训练的 Mixer 选项(FA, SWA, KDA, GDN),允许在推理时根据性能需求动态切换 Placement,无需重新加载权重,且在 32k 上下文下实现了高达 10.7× 的吞吐量提升。
TL;DR
在 LLM 的部署中,我们通常必须在“极速生成”和“极致质量”之间选边站。ServiceNow 推出的 Super Apriel 打破了这一僵局。通过将一个 15B 的模型重构成一个“超网络 (Supernet)”,它让开发者可以在推理时实时切换每一层的 Mixer 类型(FA, SWA, KDA, GDN),在同一个 Checkpoint 上实现从 1x 到 10x 的动态性能跨度。
痛点深挖:为何我们需要“弹性”模型?
目前大多数加速 LLM 的方案(如 Mamba 或混合注意力模型)都是静态的。一旦训练完成,注意力层与线性层的位置就定死了。但在实际生产中,我们经常遇到以下尴尬:
- 流量波峰波谷:高峰期希望模型跑快点(即使牺牲 2% 精度),低谷期则希望体验最好。
- 任务异构性:简单的闲聊不需要全量 Attention,但复杂的长向量检索却离不开它。
- 部署负担:为了满足不同速度需求,得维护多个 Checkpoint,显著增加了显存占用和版本管理开销。
核心机制:四种 Mixer 的交响乐
Super Apriel 在每一层都内置了四种“插件”,可以在运行时动态路由:
- Full Attention (FA):保留最完整的 O(n²) 建模能力。
- Sliding Window Attention (SWA):固定窗口大小,限制 KV Cache 增长。
- Gated DeltaNet (GDN):带有门控机制的线性递归项,O(1) 固定状态。
- Kimi Delta Attention (KDA):在 GDN 基础上增加了维度级门控。
寻找最优解:Cluster Expansion 代理模型
在 种天文数字级的层排列中寻找最优解是一个典型的组合优化难题。作者借用了统计物理学中的 Cluster Expansion 方法。
- 物理直觉:将每一层看作晶格上的原子,Mixer 类型看作原子种类。变压器层的相互作用主要通过残差连接传播,且随距离几何级数递减。
- 搜索效率:利用二阶(成对)相互作用建模,通过 Viterbi 动态规划,可以在秒级时间内找到给定成本预算(Cost Budget)下的全局最优层排列(Placement)。
实验战绩:极致的推理性价比
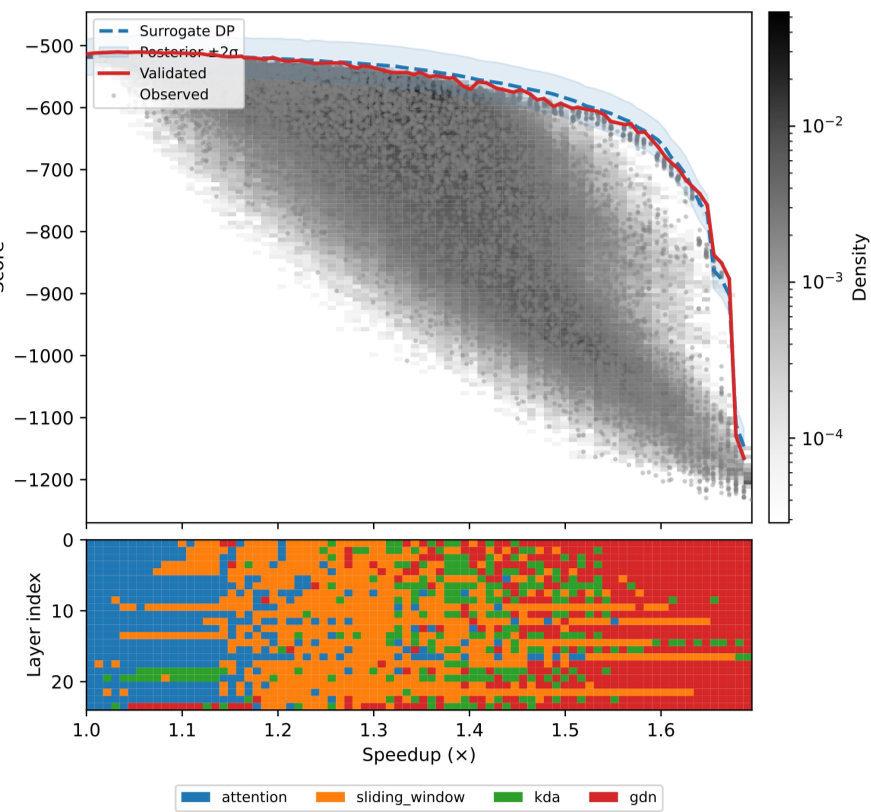
实验显示,Super Apriel 在 32k 上下文下的优势尤为明显。随着上下文变长,FA 的 KV Cache 成为瓶颈,而混合配置的优势呈指数级放大。
关键发现包括:
- 分层演化:最有性价比的配置通常是:前几层用 FA/SWA 抓特征,中间层向 KDA/GDN 切换以节省计算,最后往往保留一定的局部窗口能力。
- Speculative Decoding:更有趣的是,用户可以将同一个 Checkpoint 中的 GDN 配置作为“草稿模型(Draft)”,FA 配置作为“验证模型”,实现无损的投机采样加速,省去了维护两个模型的烦恼。
深度洞察:景观漂移(Landscape Drift)
论文探讨了一个硬核课题:层排列的优劣是训练初期就能定性,还是得练完才知道? 研究发现,在 0.5B 的小模型上,各配置的排名非常稳定(相关性 > 0.98);但在 15B 模型上,Pareto 前沿上的配置会出现明显的“排名漂移”。这意味着大规模 Supernet 的架构搜索不能简单的依靠小模型推断,必须在目标规模上进行适度的随机采样训练(Stochastic Distillation)。
总结与局限
Super Apriel 开启了“可变架构模型”的新范式。尽管它在长程检索任务(如 RULER)上仍面临线性 Mixer 带来的信息压缩损失,但其在推理工程上的价值是巨大的。 它不仅是一个模型,更是一套推理变速系统——让 AI 不再是只能跑 100 码的赛车,而是能根据路况(负载和任务)自动切换档位的全地形车。