
SwanNLP:突破叙事瓶颈,让 LLM 读懂人类眼中的“语义合理性”
SwanNLP at SemEval-2026 Task 5: An LLM-based Framework for Plausibility Scoring in Narrative Word Sense Disambiguation
本文提出了 SwanNLP 框架,旨在解决 SemEval-2026 Task 5 中的叙事文本词义消歧(WSD)及合理性评分任务。该框架结合了低参数量 LLMs 的有监督微调(SFT)、大参数量商用模型的动态 Few-shot 检索(RAG)以及模拟多标注者一致性的模型集成策略,最终在排行榜上取得第 10 名。
TL;DR
在 SemEval-2026 Task 5 中,来自斯旺西大学的研究团队 SwanNLP 提出了一套基于 LLM 的叙事词义合理性评分框架。该方法不再将词义消歧(WSD)视为简单的多分类问题,而是通过动态检索增强(RAG)、难度感知微调以及多模型集成,精准模拟人类对故事逻辑中词义合理性的 1-5 分量化评估。
背景定位:从单句消歧到叙事合理性
词义消歧(Word Sense Disambiguation, WSD)虽是 NLP 的老牌任务,但传统的评价体系往往局限在孤立的句子中。然而,真实世界的语言理解离不开叙事(Narrative)。语义的合理性往往取决于前文(Pre-context)的铺垫和结尾(Ending)的转折。SwanNLP 的这项工作正是瞄准了这一前沿挑战:如何让 LLM 像人类一样,在复杂的短篇故事中评估某个词义是否“讲得通”?
痛点深挖:模型无法感知的“人类共识”
现有的 LLM 在处理常见词义时游刃有余,但在面对叙事文本时存在两个核心痛点:
- 上下文依赖性弱:小参数模型往往只看邻近词,忽略了跨句子的逻辑约束。
- 主观性难以对齐:人类对合理性的判断并非是非黑即白,而是存在 1-5 分的连续光谱。
核心方法论:三阶驱动策略
1. 结构化推理微调(Finetuning with Thinking)
团队对 Qwen-4B 和 Gemma-4B 进行了微调。他们不仅给模型提供答案,还融入了“推理路径”:
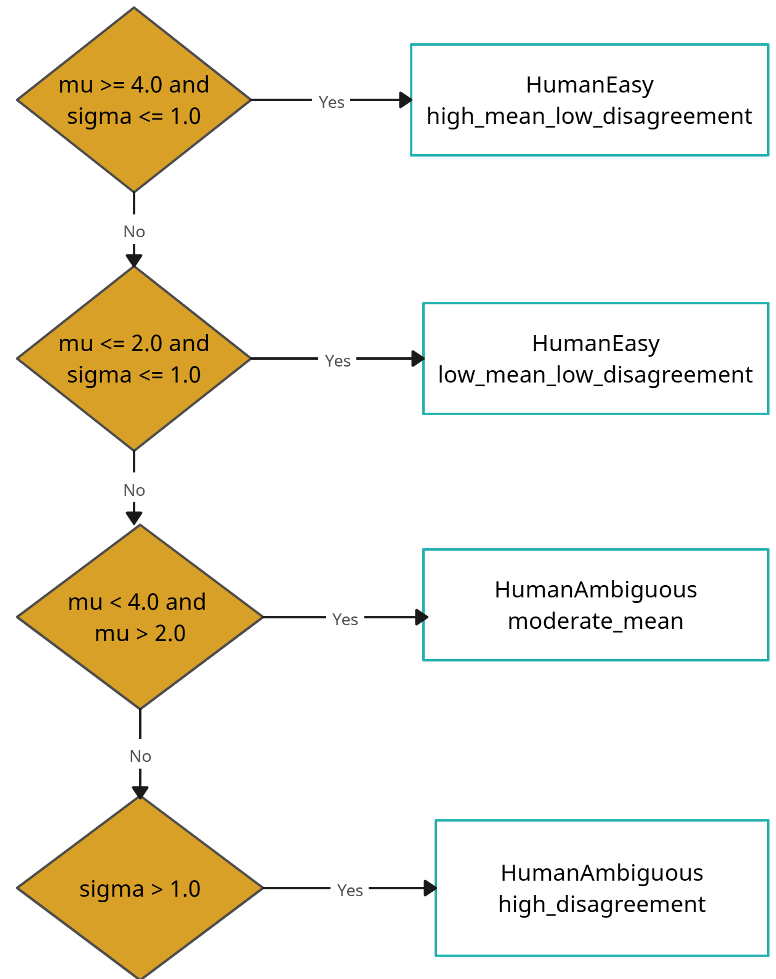
- 难度识别:先让模型判断这个故事是“一目了然”还是“充满歧义”。
- 单/多标注者模拟:训练模型同时输出五个模拟得分,以捕捉人类标注中的多样性。
2. 动态 Few-shot 与 RAG
对于 GPT-4o 等闭源强模型,作者设计了一个基于语义检索的动态 Prompt 系统。通过 FAISS 向量库,根据当前问题的特征(难度、词义类型)实时检索最相似的示例作为上下文,辅助模型进行 Zero-shot 之外的深度推理。
3. 集成学习:模拟“全体投票”
为了达到最优的 Spearman 相关性,作者引入了多种集成方案,包括逻辑回归(LRE)、SVR 和 XGBoost。结果显示,模拟多个标注者意见的集成策略能有效平滑单一模型的偏差。
实验与结果:GPT-4o 依然是王者
实验数据清晰地揭示了不同策略的效果:
- 微调效果:Qwen-4B 在加入“难度分析”模块后,Spearman 得分提升显著,远超基础推理模式。
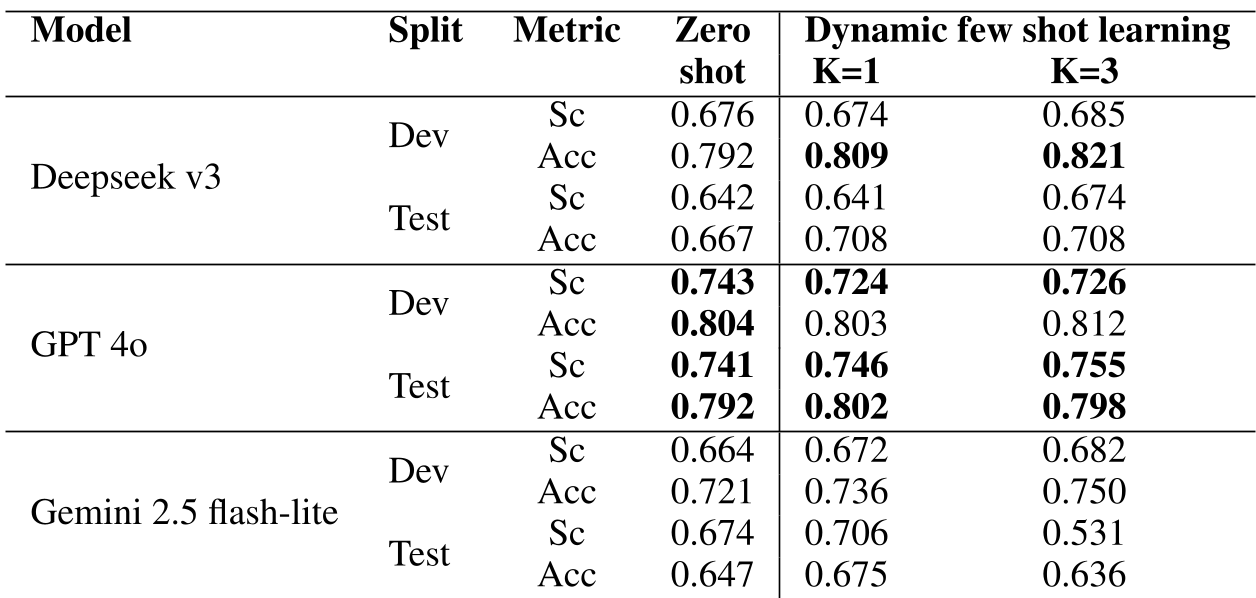
- 跨模型对比:GPT-4o 在 Spearman 相关性(0.741-0.755)和准确率上全面领先 DeepSeek 和 Gemini,显示出极强的逻辑一致性。
深度洞察与总结
核心价值 (Takeaway)
SwanNLP 的成功证明了:合理性评分不仅仅是语义匹配,更是逻辑推理。 通过将“任务难度”作为显式特征引入微调过程,可以显著增强轻量级模型对复杂语境的敏感度。
局限性与展望
尽管集成模型在排行榜上表现强劲,但在处理**高度模糊(Indeterminate)**的极端案例时,LLM 的预测与人类标注的一致性仍有下降。未来的方向在于如何利用更深层次的常识推理链(Complex CoT)来解析叙事中的隐喻与双关,进而实现完全“类人”的阅读理解。