
SWE-chat:走出实验室,看真实世界中的 AI 编程智能体如何“翻车”与协作
SWE-chat: Coding Agent Interactions From Real Users in the Wild
本文推出了 SWE-chat,这是首个大规模真实世界编程智能体(Coding Agent)交互数据集,包含来自开源开发者的 6,000 个会话、6.3 万个用户提示和 35.5 万个工具调用。该研究揭示了 AI 编程智能体在实际工作流中的使用模式、失败模式以及相对于人类代码的安全风险。
TL;DR
斯坦福大学研究团队发布了 SWE-chat,这是首个源自 GitHub 真实开发场景的大规模 AI 编程智能体交互数据集。研究发现,虽然“Vibe Coding”(由 AI 几乎完成所有代码编写)正成为趋势,但其代价惨重:智能体生成的代码仅有不到一半能通过人类审核进入代码库,且其安全漏洞率竟高出人类 9 倍。
背景定位:从“闭卷考试”到“实战演习”
在此之前,我们评价 AI 程序员(如 Claude Code, SWE-agent)大多依赖 SWE-bench 等基准测试。这些测试就像是“闭卷考试”,给出一个 Issue,让 AI 独立修补。但真实开发是** iteratively(迭代式)**的。开发者会吐槽 AI 的逻辑、强行中断运行、或者在 AI 写的代码基础上缝缝补补。
SWE-chat 的出现填补了这一空白。它通过 Entire.io 工具持续抓取真实开发者的操作日志,记录了人类与 AI 之间最真实的“拉锯战”。
痛点深挖:消失的效率与隐形的风险
过去我们认为 AI 编程只要能过 Unit Test 就算成功,但论文揭示了三个扎心的现实:
- 低存活率:平均只有 44.3% 的智能体产出代码能“挺进”最终的 Commit。
- 安全隐患:AI 在“放飞自我”独立编程(Vibe Coding)时,每千行引入的漏洞数(0.76)远高于人机协作模式(0.14)。
- 巨大的沟通成本:用户在接近一半(44%)的交互回合中都在做“负反馈”,包括修正、报告失败或直接按下“停止键”。
核心机制:Vibe Coding 及其代价
论文将编程模式划分为三种:
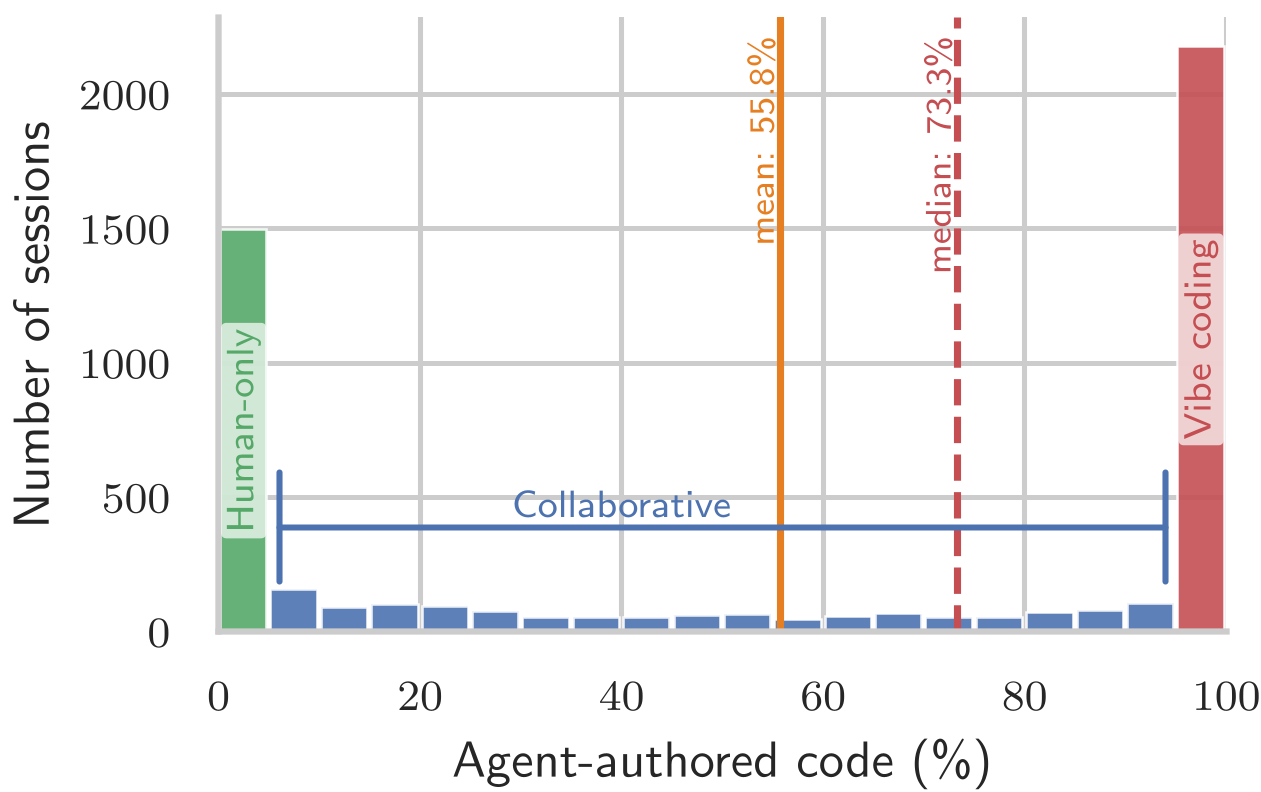
- Human-only (23%):AI 只是个查文档、解释代码的陪练。
- Collaborative (36.5%):人机共写,效率最高。
- Vibe Coding (41%):AI 完成 >99% 的代码。
研究指出,Vibe Coding 的经济性极差。为了每提交 100 行有效代码,Vibe Coding 消耗的 Token 是协作模式的 3 倍,成本(Dollar cost)也更高。这打破了“全自动化即高效率”的幻觉。
实验结果与深度洞察
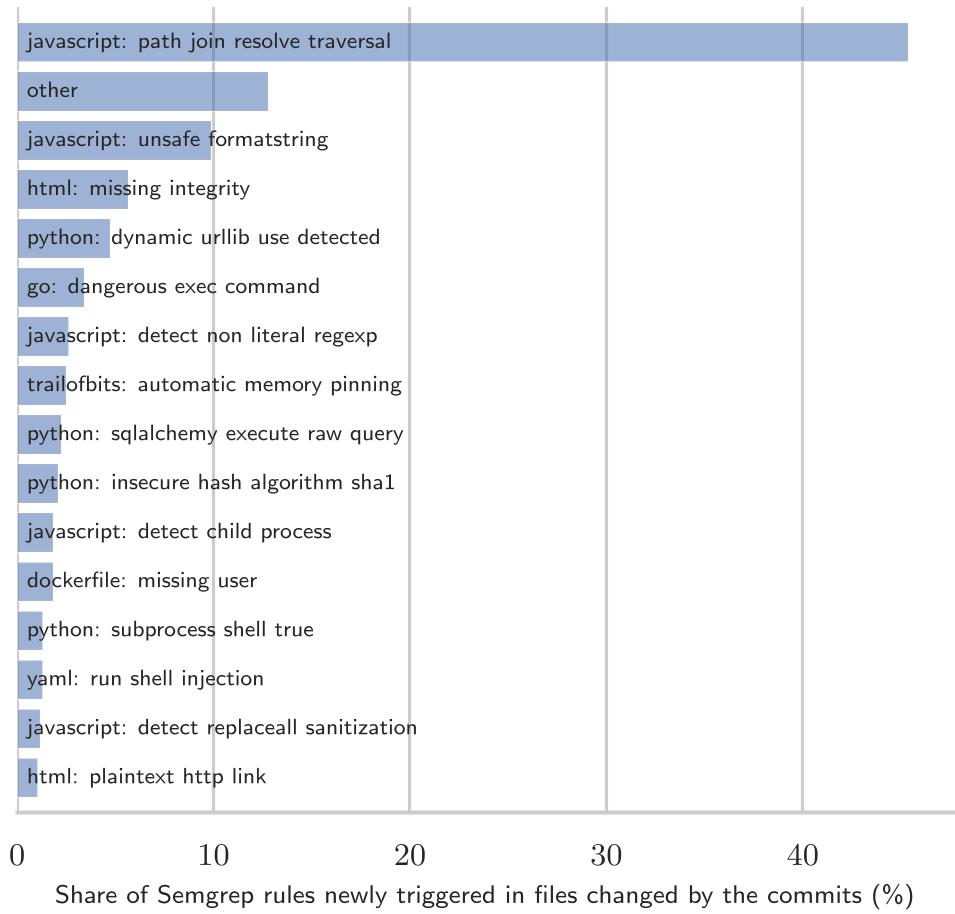
研究团队利用 Semgrep 对代码进行了静态扫描,发现 AI 尤其容易在路径穿越(Path Traversal)、命令注入(Command Injection)和 SQL 注入等经典安全问题上栽跟头。
关键发现:智能体太“闷”了。 数据显示,像 Claude Code 这样的顶尖智能体,只有在约 1.4% 的回合中会主动停下来问用户:“我这个方案你觉得行吗?”。大多数时候它们在埋头苦干,直到用户忍无可忍进行“硬中断”(Hard Interruption)。
总结与未来展望
SWE-chat 的价值在于其“Sim2Real”的启示:
- 评测转向:未来的 Benchmark 应该评估 AI 的“可指导性”(Steerability),而不是单纯的“成片输出能力”。
- 交互重构:Agent 需要学会何时停止并征求意见,而不是一味追求自主性(Autonomy)。
- 模拟器研发:利用 SWE-chat 训练“人类模拟器”,可以让 AI 在上线前先接受虚拟程序员的“毒打”和挑刺。
一句话总结:AI 编程还远未达到“自动驾驶”的 L5 阶段,目前最靠谱的姿势依然是:人坐在驾驶位,AI 负责辅助加速。
注:本文基于斯坦福大学 2026 年最新论文整理。