
SwiftI2V:202 倍加速!消费级显卡也能跑 2K 高清图生视频
SwiftI2V: Efficient High-Resolution Image-to-Video Generation via Conditional Segment-wise Generation
本文提出了 SwiftI2V,一个针对 2K 高分辨率图生视频 (I2V) 任务的高效生成框架。该方法通过将全局运动建模与局部细节增强解耦,并引入条件分段生成 (CSG) 机制,在保持与端到端 SOTA 模型相当的生成质量前提下,将 GPU 计算时间缩减了 202 倍。
TL;DR
在视频生成领域,2K 分辨率一直是一道“显存天堑”。本文介绍的 SwiftI2V 通过一种近乎“降维打击”的解耦策略,解决了高分辨率图生视频 (I2V) 的效率瓶颈。它不仅在画质和运动一致性上媲美最顶尖的端到端模型,更将计算成本降低了两个数量级(202×),让 2K 高清视频生成在单张 RTX 4090 上成为可能。
核心痛点:为什么 2K I2V 这么难?
现有的 2K 视频生成路径主要有两条,但各有“硬伤”:
- 端到端生成 (End-to-End):直接用 Transformer 处理 2K 分辨率的所有 Token。结果是显存爆炸,即使是 H800 集群也跑得气喘吁吁。
- 低分辨 + VSR (视频超分):先跑一个 360P 的小视频,再用超分模型放大。问题在于,通用超分模型“不认识”你的原图,放大过程会丢失细节,甚至让主角“换脸”。
SwiftI2V 的洞察非常直观:运动不需要高分辨率就能看清,但细节必须时刻对齐原图。
核心架构:解耦与双向交互
SwiftI2V 采用了精妙的两阶段设计(见下图):
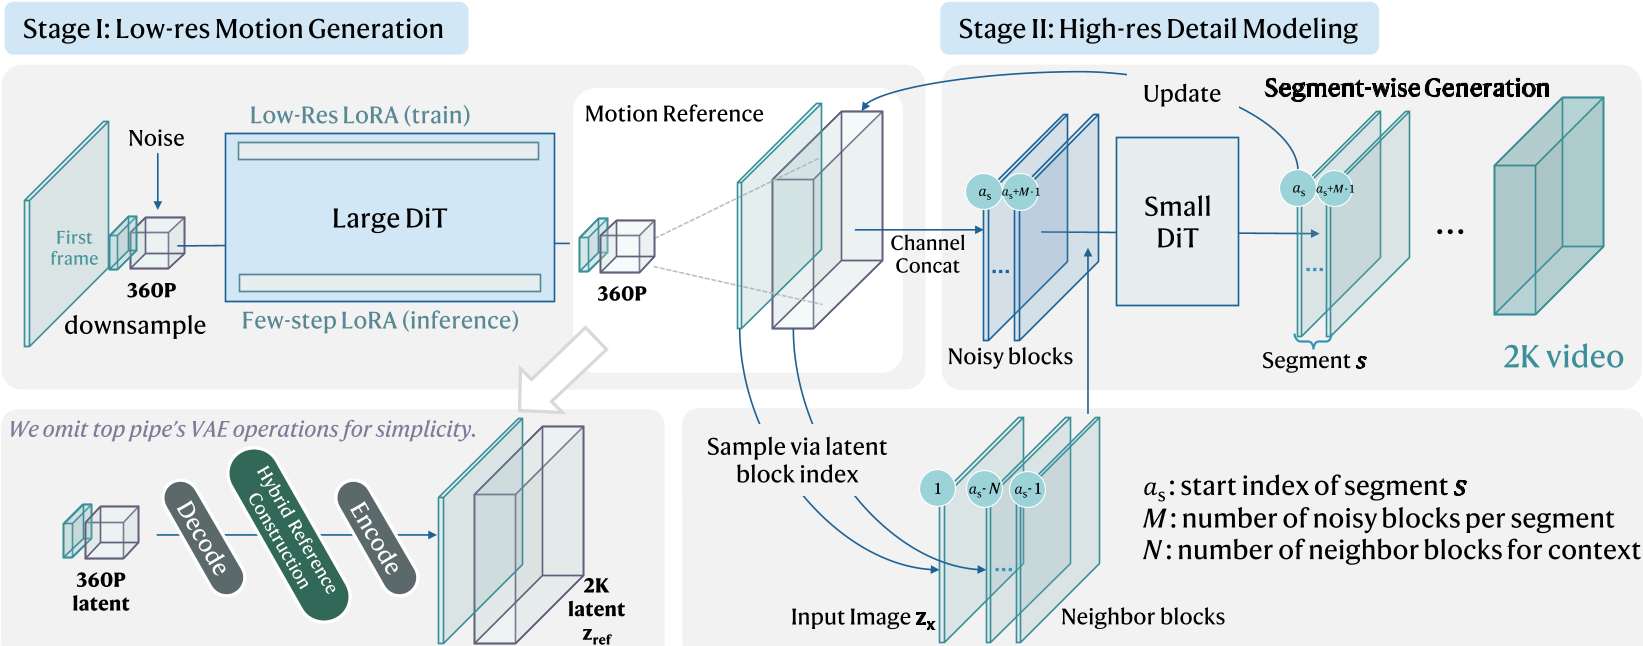
1. 运动参考阶段 (Stage I)
在低分辨空间(如 360P)利用轻量化的 DiT (Diffusion Transformer) 快速建模。这一步决定了“怎么动”,由于分辨率低,推理极其迅速。
2. 条件分段生成 (CSG - Stage II)
这是本文真正的“黑科技”。为了在 2K 分辨率下控制显存,作者提出了 Conditional Segment-wise Generation (CSG):
- 分段处理:将视频切成短片段进行生成,以此固定每一步的 Token 预算。
- 双向上下文交互 (Bidirectional Interaction):这是 CSG 的核心设计。不同于传统的自回归(只能前一帧看后一帧),CSG 让当前生成的噪声块、前序历史帧以及原始高清输入图在 Attention 层中进行“三方对谈”。
- 锚点锁定:第一帧始终被强制替换为原始高清水印,并作为锚点 (Anchor Block) 指引后续所有帧的纹理合成,彻底杜绝了纹理漂移。
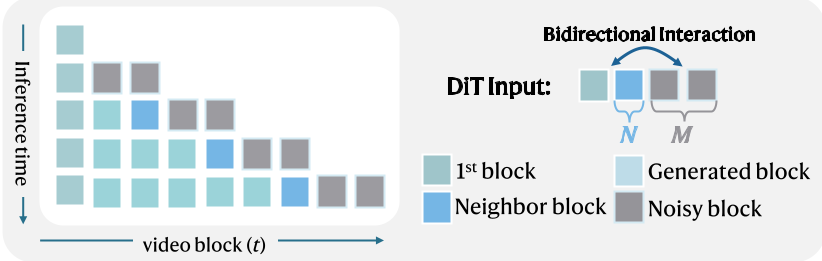
实验结果:速度、质量全都要
实验证明,SwiftI2V 在 VBench-I2V 的各项指标上均处于领先地位。
- 惊人的提速:对比 CineScale 模型,SwiftI2V 仅需 111 秒即可完成 81 帧 2K 视频生成,而前者在同样的硬件环境下可能需要数小时。
- 显存友好:得益于 CSG 机制,Stage II 的显存占用始终稳定在 20GB 左右,这意味着消费级的 RTX 3090/4090 也能轻松胜任。
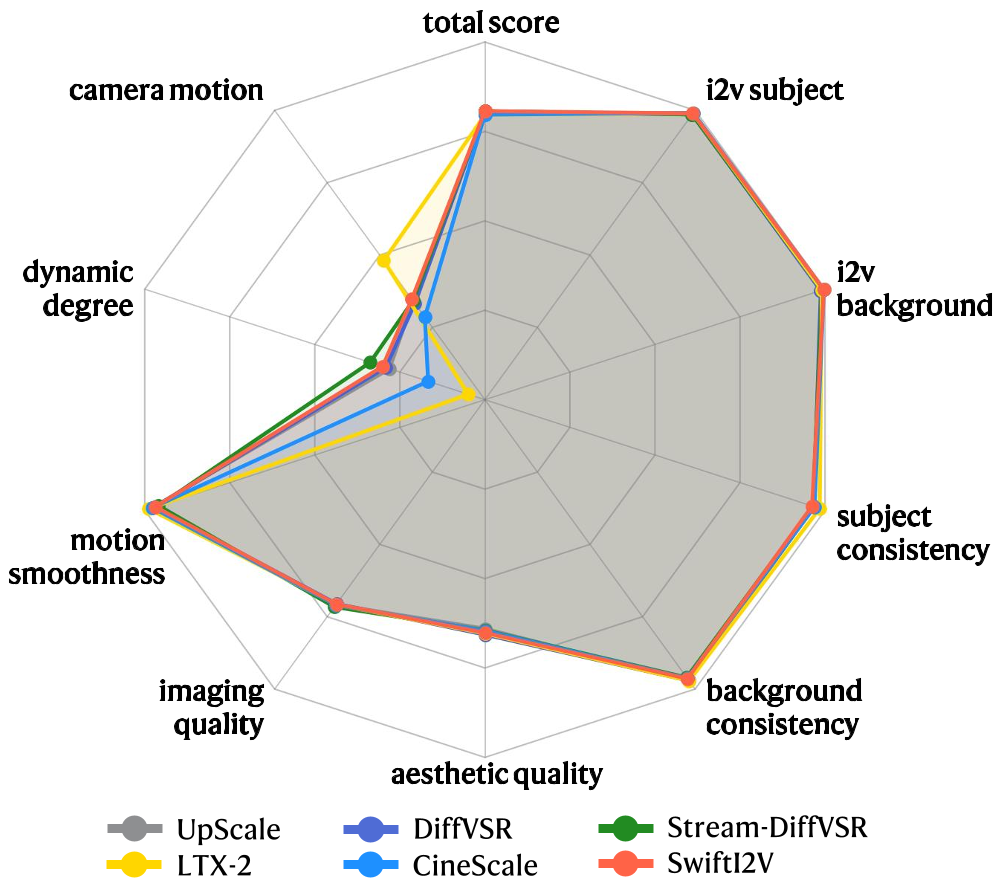
在上图的对比中可以看出,SwiftI2V 在保持高动态范围(Dynamic Degree)的同时,对背景(I2V Background)和主体(I2V Subject)的还原度更是达到了 SOTA 级别。
深度洞察:为什么这种做法有效?
SwiftI2V 的成功在于它精准捕捉到了 I2V 任务的归纳偏置 (Inductive Bias)。I2V 不同于从零开始的文生视频,它有一个“绝对真理”——第一帧图像。 作者引入的 Stage-Transition Training 策略也非常关键:他们在训练 Stage II 时,故意给 Stage I 的输入加入仿真采样噪声。这让模型学会了“容错”,即使低分辨参考稍微有点抖动,高分辨阶段通过强行比对原图,也能把画面修正回来。
总结与展望
SwiftI2V 不仅仅是一个模型,它更像是一套针对高分辨率生成任务的通用方法论。通过 “低分辨运动引导 + 高分辨分段细节注入”,它极大地降低了 AI 视频生成的创作门槛。
虽然它目前还无法做到“实时生成”(流式输出约 3.33 FPS),但其分段解耦的思想为未来的实时互动视频生成指明了方向。
主编点评:这是一篇典型的“工程直觉驱动学术创新”的佳作。它没有去卷更复杂的模型结构,而是通过精妙的采样策略和数据工程,解决了高分辨率场景下最现实的效率矛盾。