
Sword:突破世界模型的幻觉瓶颈,构建高保真 VLA 强化学习模拟器
Sword: Style-Robust World Models as Simulators via Dynamic Latent Bootstrapping for VLA Policy Post-Training
本文提出了 Sword,一种用于 VLA 模型强化学习后训练(Post-training)的鲁棒世界模型框架。通过引入结构引导的风格增强和动态潜空间引导(Dynamic Latent Bootstrapping, DLB)机制,Sword 在 LIBERO 基准测试中实现了 SOTA 的生成质量与泛化性,显著提升了 VLA 策略在虚拟环境中的训练成功率。
TL;DR
在具身智能(Embodied AI)领域,将世界模型(World Models)作为“想象”中的模拟器来训练 VLA(视觉-语言-动作)策略已成为一种新范式。然而,自回归生成的级联错误和对环境细节的过度拟合限制了其可靠性。本文介绍的 Sword 框架,通过“风格增强”与“动态潜空间引导”技术,成功打造了一个即便在视觉扰动下也能保持物理一致性的鲁棒模拟器,将策略训练成功率提升了近 10%。
痛点深挖:为什么现有的世界模型会“崩塌”?
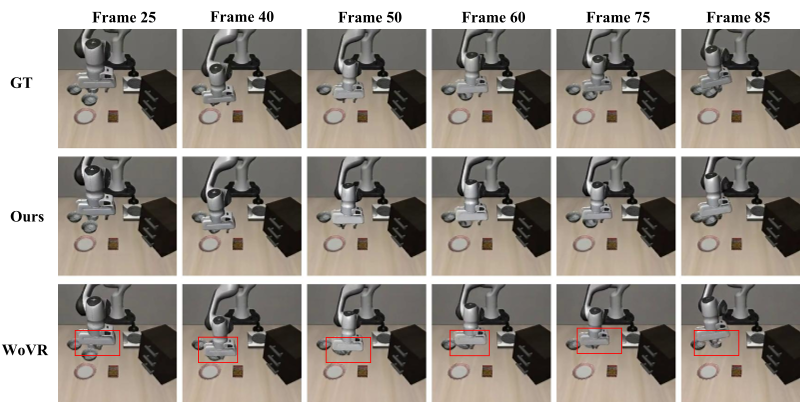
目前的主流方法(如 WoVR)在处理长程任务时,经常会出现令人苦恼的现象:
- 视觉泛化脆弱性:当背景颜色或光照稍有变化,模型会因为没见过这些“纹理”而产生严重的模糊或过度曝光,完全丧失物理推演能力。
- 曝光偏差(Exposure Bias):训练时模型看着正确的前一帧预测后一帧(Teacher Forcing),但推理时它必须根据自己可能出错的预测继续预测,错误像滚雪球一样放大,导致机械臂在屏幕中“凭空消失”或“瞬间移动”。
核心方法论:Sword 的解构与重塑
1. 结构引导的风格增强(Structure-Guided Style Augmentation)
为了让模型学会“物理规律”而非“背诵像素”,作者引入了风格迁移,但关键在于结构约束。
- 物理不变性:利用 DepthAnything 和 SAM2 提取深度图与语义掩码。
- 多样化渲染:在 Cosmos-Transfer 架构下,仅改变桌面颜色、机械臂涂装和光照,而强制模型必须在这些变体下遵循同样的运动轨迹和几何约束。
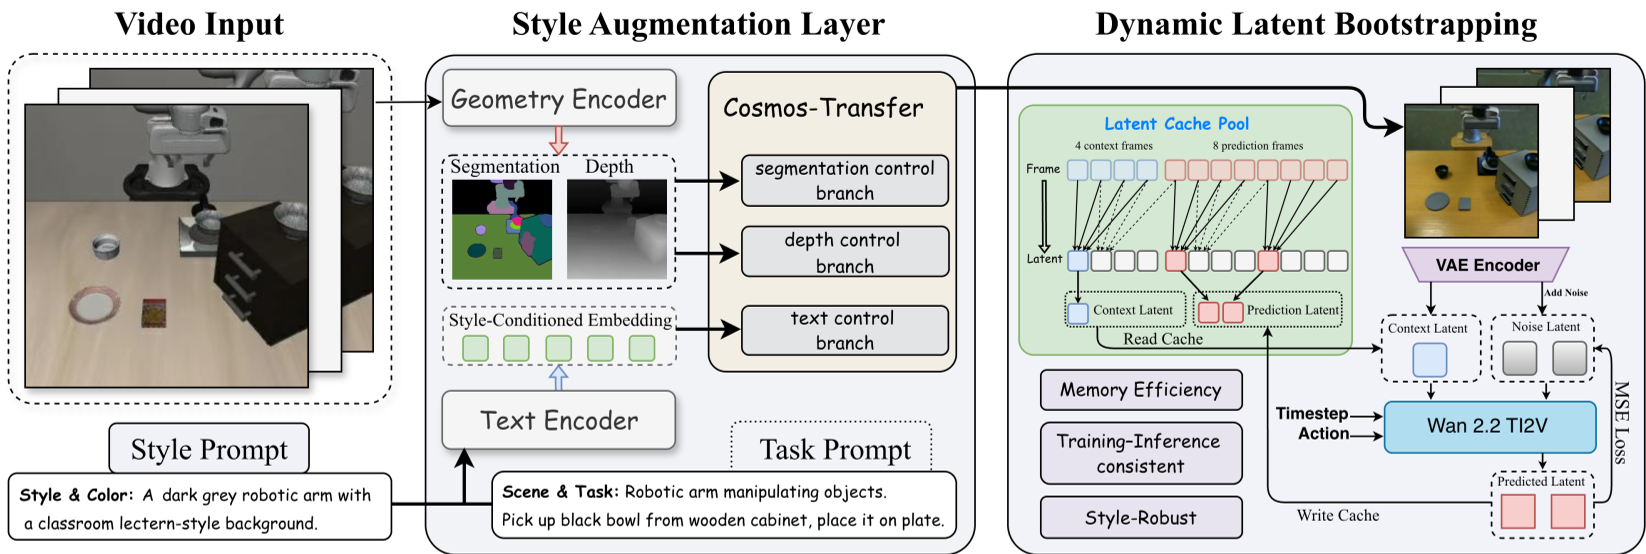
2. 动态潜空间引导(Dynamic Latent Bootstrapping, DLB)
这是解决曝光偏差的神来之笔。传统的 Self-forcing 训练极其耗费内存(需存储大量像素序列)。
- 潜空间缓存:Sword 在 VAE 的 Latent Space 进行操作,将存储开销降低了 60 倍。
- 平滑切换:训练初期使用真值,中后期逐渐提高从“预测缓存”中读取上下文的概率。这迫使模型在训练期就学会如何纠正自己之前产生的微小误差,实现了训练与推理的无缝衔接。
实验战绩:不仅仅是画质更好
实验在著名的 LIBERO 机器人基准测试上进行。
- 对抗幻觉:在下图的对比中可以清晰看到,WoVR 在第 30 帧左右就开始出现结构塌陷和严重模糊,而 Sword 在 50 帧后依然保持了锐利且物理准确的抓取动作。
- 下游训练价值:最硬核的指标是 VLA 策略在世界模型里练完后,真正在环境里的成功率。Sword 支撑的 GRPO 训练在各个阶段均领先 WoVR。
深度洞察:迈向“可交互的视频基础模型”
Sword 的成功证明了一个重要的学术直觉:世界模型不应该只是一个“视频生成器”,而应该是一个“受约束的物理方程”。通过 DLB 机制,模型实际上是在学习一种“自纠错能力(Self-Correction)”。
局限性与展望: 尽管 Sword 表现优异,但其目前的显存开销依然可观(1.5 A100 GPU 年的算力需求)。未来的突破口可能在于更轻量级的扩散架构,以及如何将这种鲁棒性扩展到更复杂、动态变化的开放世界场景中。
总结
Sword 重新定义了如何训练一个“听话”且“稳健”的世界模型。它不仅解决了视觉上的美观问题,更通过潜空间引导解决了时序一致性的核心难题,为 VLA 模型的自进化(Self-evolving)提供了坚实的模拟基石。