
Syn4D:开启 4D 视觉新纪元,大规模稠密几何标注数据集的突破
Syn4D: A Multiview Synthetic 4D Dataset
本文推出了 Syn4D,这是一个大规模多视图合成 4D 动态场景数据集。它包含 4.7K 个剪辑、1.4M 帧图像,并提供包括位相机运动、深度图、稠密 3D 追踪及参数化人体姿态在内的精确几何标注,旨在突破动态场景 4D 重建与追踪的数据瓶颈。
TL;DR
牛津大学 VGG 团队推出了 Syn4D,这是一个划时代的合成 4D 多视图数据集。它解决了长久以来困扰动态场景研究的“数据荒”问题,不仅提供了 140 万帧的高质量渲染,还通过创新的重心坐标映射技术实现了全像素级别的 3D 轨迹追踪标注。
核心速览
在计算机视觉领域,3D 重建正从“静态”向“动态(4D)”跨越。然而,现有的数据要么太假(Kubric),要么太稀疏(PointOdyssey)。Syn4D 的出现填补了这一空白:
- 规模巨大:4,700 个剪辑,涵盖人、动物、机器人等复杂动态主体。
- 标注全能:含相机参数、深度、稠密追踪、人体 SMPL-X 姿态。
- 技术示范:展示了如何利用该数据集训练强力的 4D 重建模型及几何感知扩散模型。
1. 痛点深挖:为什么 4D 追踪标注这么难?
在 4D 任务中,我们不仅要看当前帧的深度,还要知道“这一帧的某个像素,在上一帧或下一帧的 3D 位置在哪里”。 按照传统存储方式,存储一个 512x512 分辨率、300 帧、8 个相机的视频的稠密轨迹,需要 2.1 TiB 的空间。这种巨大的存储成本导致之前的 SOTA 方法往往只能提供稀疏的轨迹点标注,严重限制了模型学习精细运动的能力。
2. 核心机制:重心坐标的神来之笔
Syn4D 的作者提出了一种极为聪明的压缩方案。由于模型本质上是由三角形网格(Mesh)驱动的,作者不再存储每个像素的 3D 坐标,而是存储:
- Face Index:像素对应网格上的哪个三角面。
- Barycentric Coordinates:像素在该三角面内的重心坐标。
- Vertex Trajectories:网格顶点的随时间变化的轨迹。
通过公式 ,可以在读取数据时实时还原任意像素在任意时间的 3D 位置。这直接将存储需求从 2.1 TiB 降至 9.3 GiB,使得大规模稠密 4D 学习成为可能。
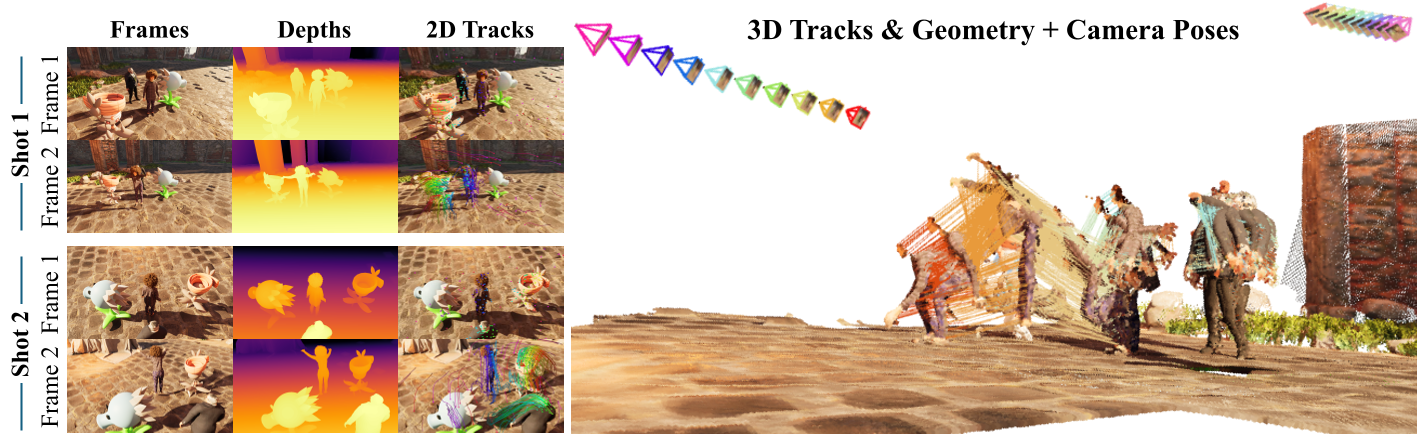 图 1: Syn4D 支持的任务涵盖了从相机估计到稠密追踪的所有 4D 维度。
3. 几何感知的多视图扩散模型
本文不仅仅是一个数据集论文。作者基于该数据开发了一个几何感知扩散模型。 以往的扩散模型(如 SVD)只能生成像素,而 Syn4D 训练的模型在生成新视角的视频时,能同时输出一致的 Dynamic Point Maps (DPM)。这意味着生成的视频不仅看着真实,其背后的 3D 几何结构在物理上也是连贯的。
 图 2: 几何感知多视图生成架构。
4. 实验战绩:全线 SOTA 的基石
作者将 Syn4D 加入到现有的 4D 重建基准(如 4RC)中进行联合训练,结果在多个下游任务上起到了“点石成金”的效果:
- 3D 轨迹追踪:在真实场景数据集 ADT 和 PStudio 上,追踪误差(EPE)相比原模型大幅下降。
- 视频深度估计:在 Sintel 等测试集上,Sharper 的边缘和更准确的运动连续性尤为显著。
- 人体姿态估计:利用 Syn4D 中高度多样化的遮挡和人体动作,MA-HMR 模型在 Hi4D 等真实人体交互测试中精度提升显著。
 图 3: 使用 Syn4D 训练后(右三),预测出的深度图(Depth)相比原基线(左三)更加锐利且准确。
5. 深度洞察与总结
Syn4D 的价值在于它重新定义了“大规模 4D 监督”的标准。在 Transformer 主宰 CV 的今天,数据的质量和规模直接决定了模型的 Prior 是否足够鲁棒。
局限性:虽然合成场景非常真实,但与真实世界的物体材质(如半透明、复杂反射)仍有微小 Gap,且目前的场景仍主要局限于单一或少量动态主体的交互。
未来展望:Syn4D 将会是开发下一代“世界模型(World Models)”的重要燃料。通过这种高质量的几何对齐数据,AI 或许能真正开始理解物体运动的物理常识。
关键词:Synthetic Dataset, 4D Reconstruction, Multiview Diffusion, Dense Tracking.