
综合征重采样:无需硬件升级,四个数量级抑制量子逻辑错误
Syndrome resampling enhances quantum error correction thresholds
本文提出了一种名为“综合征重采样”(Syndrome Resampling, SR)的普适性量子纠错提升方法。该方法通过将综合征概率分布(SPD)进行幂次重采样,显著提高了任何解码器的逻辑阈值并降低了逻辑错误率,在表面码(Surface Codes)模拟中实现了高达四个数量级的错误抑制。
TL;DR
本文介绍了一种名为综合征重采样 (Syndrome Resampling, SR) 的黑科技。通过对纠错过程中的综合征数据进行数学上的“重加权”,它能让现有的解码器(如 MWPM)爆发出接近甚至超越 MLD 的性能。不需要更多的物理量子比特,也不需要改写复杂的解码算法,只需对数据分布进行幂次变换,即可将逻辑错误率降低至多 10,000 倍。
背景定位:这是量子纠错(QEC)领域的一项重要理论与实证进展,成功将**统计物理中的相干信息(RCI)**理论转化为可落地的量子纠错优化协议。
痛点深挖:为何纠错阈值难以突破?
在量子纠错中,我们通过测量综合征(Syndrome)来识别错误。现有的瓶颈在于:
- 解码器的局限:目前常用的解码算法(如 MWPM)是次优的,而最优的 Maximum Likelihood Decoding (MLD) 是 NP-hard 问题。
- 后选择(Post-selection)的浪费:虽然只保留无错运行(Trivial Syndrome)能极大提升保真度,但随着量子比特数增加,有效样本量会呈指数级消失。
作者的 Insight 非常直观:如果我们能通过数学手段,让那些看起来“很像正确”的综合征权重变大,而压低那些“极度混乱”的综合征权重,是否能人为地提高系统的容错阈值?
方法论详解:RCI 与幂次分布的交响乐
核心方法是基于 Rényi Coherent Information (RCI) 的数学特性。作者证明了:通过将原始综合征分布 提升到 次幂,即 ,可以诱导出纠错能力的相变。
架构解析
- 数据收集:从 QEC 实验中获取真实的综合征统计分布。
- 重采样逻辑:对于一个测得的综合征 , 越小(通常代表高权重、难以修复的错误),在重采样分布 中被保留的概率就越低。
- 软后选择:相比于直接丢弃(Hard PS),这种方法在 时保留了更多的“非平凡综合征”,从而在统计意义上改善了逻辑保真度。
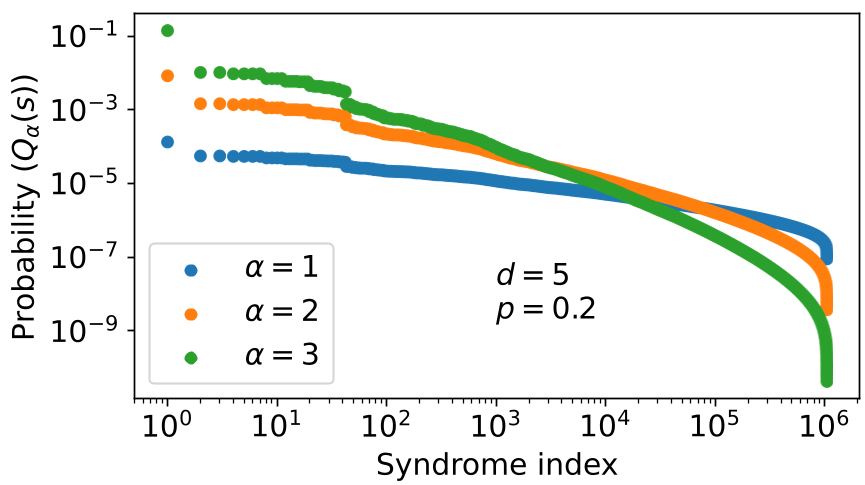 图注:随着 增加,综合征分布更加向“零错误”(Trivial Syndrome)塌缩,有效提高了阈值。
实验与结果:化腐朽为神奇
作者在未旋转表面码(Unrotated Surface Code)上进行了详尽测试,并与统计物理中的 Ising 模型映射进行了对比验证。
核心战绩
- 阈值飞跃:在 MLD 解码下, 时阈值为 10.9%,而通过重采样, 提升至 17.8%, 甚至达到了 21.1%。
- 兼容性验证:该方法对 suboptimal 的 MWPM 同样有效,使其表现逼近甚至在重采样后超越了原本的 MLD 极限。
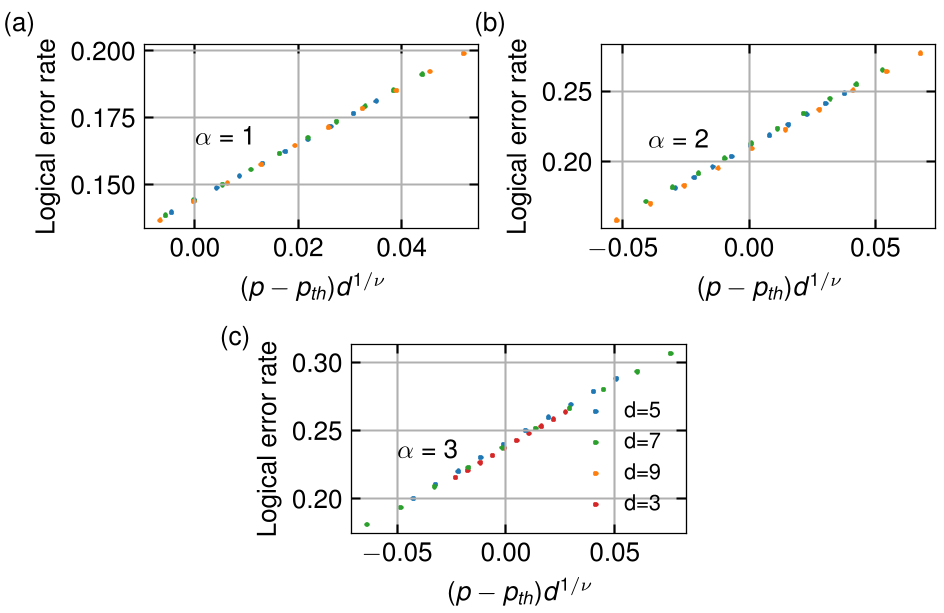 图注:重采样后的逻辑错误率(蓝色与红线)显著低于原始解码(黑线),呈现出明显的性能跨越。
实验室数据实测
作者将 SR 应用于 Google 或苏黎世联邦理工学院等团队的真实晶格手术实验数据。结果令人振奋:在不增加任何额外逻辑测量的前提下,逻辑错误率降低了近 100 倍,且保留的样本数比传统后选择多出整整一个数量级。
深度洞察与总结
Takeaway
综合征重采样不仅是一个数学游戏,它揭示了量子相干信息在受噪声信道中的相变行为。对于目前仍处于“嘈杂中型量子(NISQ)”时代的研究者来说,这提供了一种**极其廉价(仅需离线数据处理)**的提升逻辑保真度的方法。
局限性 (Limitations)
- 采样开销:在高错误率区域,为了精确估计特征分布 ,所需的样本量仍然会随量子比特数 增加而呈指数级上升。
- 计算依赖:由于需要评估 ,在复杂码下可能需要借助近似表征技术(如神经网络估计分布)。
未来展望
未来该方法有望与 Machine Learning Decoders 结合,利用神经网络预估综合征概率,从而在大规模逻辑量子比特阵列中实现实时的效率提升。正如作者所言,这是通往实用化断层扫描纠错的一条“普适且解码器无关”的捷径。