
AgentFlow:重构智能体拓扑,在大模型“漏洞挖掘”战场实现 SOTA 进化
Synthesizing Multi-Agent Harnesses for Vulnerability Discovery
本文推出了 AgentFlow,一个用于自动合成多智能体“后置框架”(Harness)的系统。它通过一种类型化的图域特定语言(DSL)和反馈驱动的优化循环,在 TerminalBench-2 榜单上取得了 84.3% 的 SOTA 战绩,并成功在 Google Chrome 中挖掘出 10 个 0-day 漏洞。
TL;DR
在 AI 辅助安全领域,仅仅给 LLM 几个工具(Tools)和一段 Prompt 已经不够用了。本文介绍的 AgentFlow 提出了一种全新的范式:自动合成智能体团队的架构(Harness)。它不只是在调优提示词,而是在自动编写一套涵盖“角色分配、通信拓扑、协作协议”的复杂程序。凭借这一升维打击,AgentFlow 在终端任务榜单 TerminalBench-2 登顶,并拿下了 10 个 Google Chrome 的 0-day CVE。
痛点深挖:为什么“单兵作战”和“固定架构”会失效?
传统的 LLM 漏洞发现面临三个瓶颈:
- Context 爆炸:由于 Chrome 等软件的 Sanitizer 数据和覆盖率报告动辄数 MB,单 Agent 根本读不完。
- Lost-in-the-Middle:当一个智能体同时负责审计代码、构造输入、分析崩溃(Crash)时,它会丢三落四。
- 反馈匮乏:现有的框架优化器只知道“成功”或“失败”,就像是在黑盒里摸索,无法根据“为什么失败”来调整策略。
核心方案:AgentFlow 的 DSL 与反馈闭环
AgentFlow 的核心贡献在于将智能体架构形式化为一个可搜索、可编译的 Typed Graph DSL。
1. 五位一体的架构定义
作者定义了一个五元组 ,这意味着系统可以同时重写:
- A (Agents):增加或删除专家(如新设一个专门读编码器的专家)。
- G (Topology):改变谁给谁发消息。
- (Schemas):修改传递的具体字段。
- (Tools):重新分配工具权限。
- (Protocol):把串行流改成并行 Fan-out 模式。
2. 运行时诊断(Runtime Diagnostics)
这是 AgentFlow 能够实现高效进化的“眼睛”。系统不仅看结果,还会读取目标程序的运行时信号:
- Stderr/Stdout:判断输入是否在格式校验阶段就被拒。
- Coverage:判断 Agent 生成的 Payload 有没有触达漏洞所在的深层函数。
- Sanitizer:精准捕捉内存违规,而不仅仅是看程序有没有 Crash。
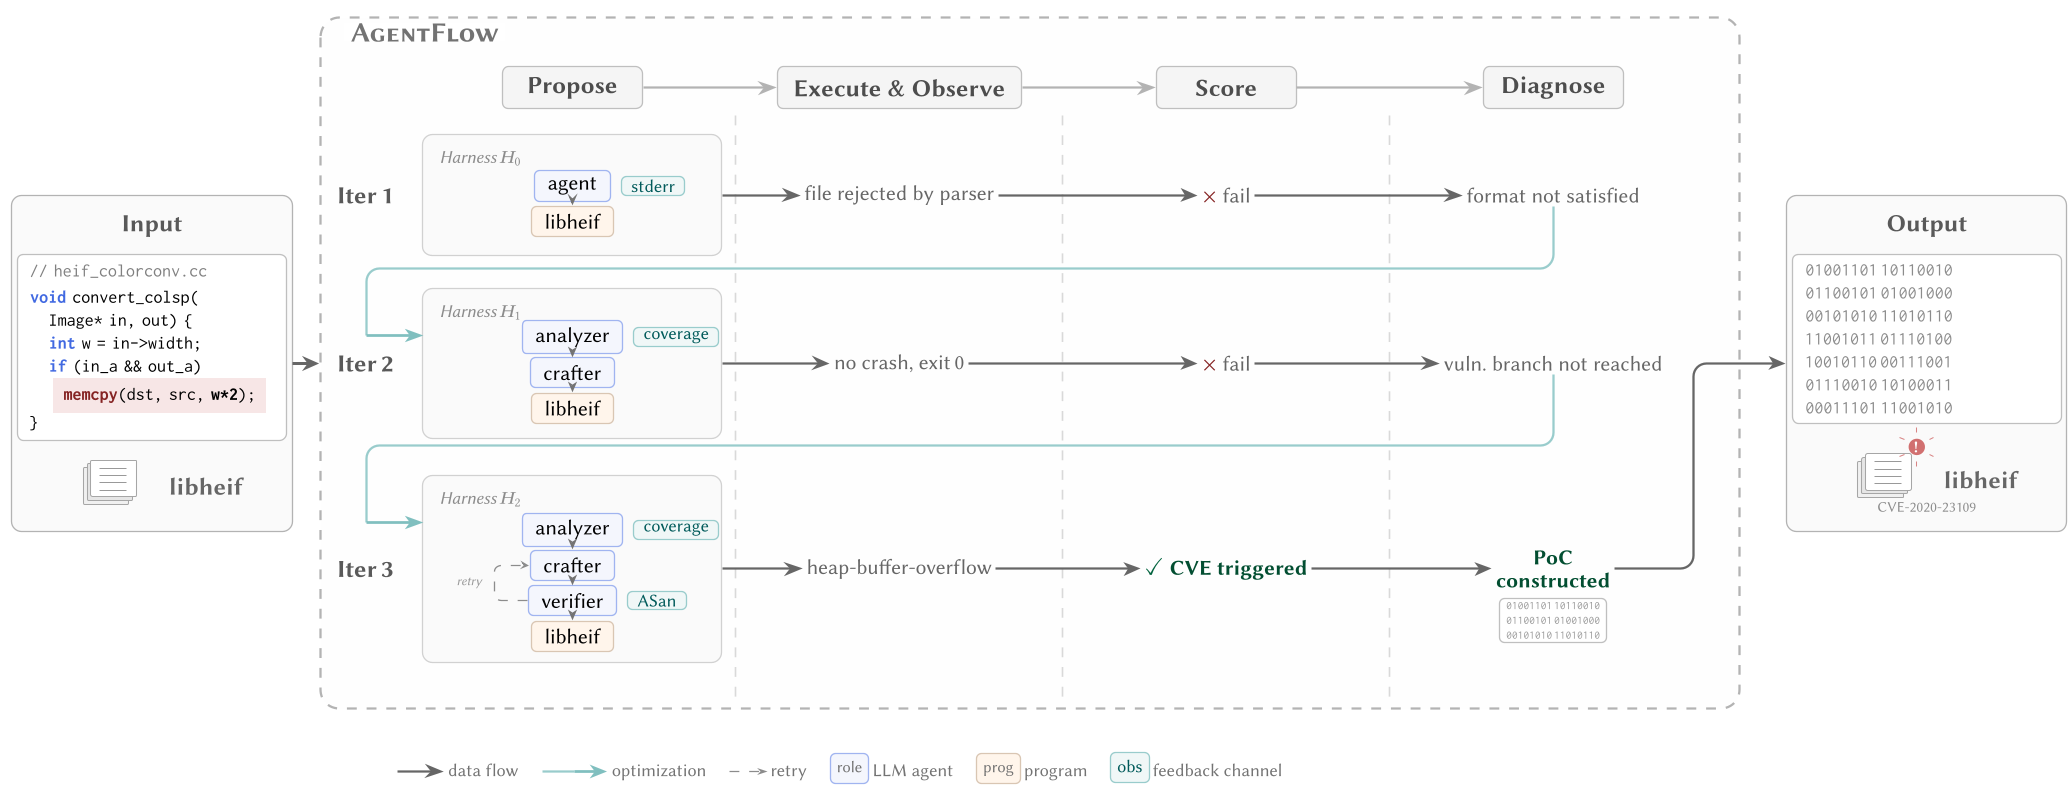 图 1:AgentFlow 在 libheif 漏洞挖掘中的三次进化:从单 Agent 到引入代码覆盖率引导的“分析器-构造器”双星架构,再到加入 Sanitizer 反馈的闭环。
实验与结果:统治榜单与真实攻防
TerminalBench-2 战绩
在相同的 Claude Opus 4.6 模型下,AgentFlow 通过优化 Harness,将胜率从基线的 60.9% 提升至 84.3%,位列全球第一。
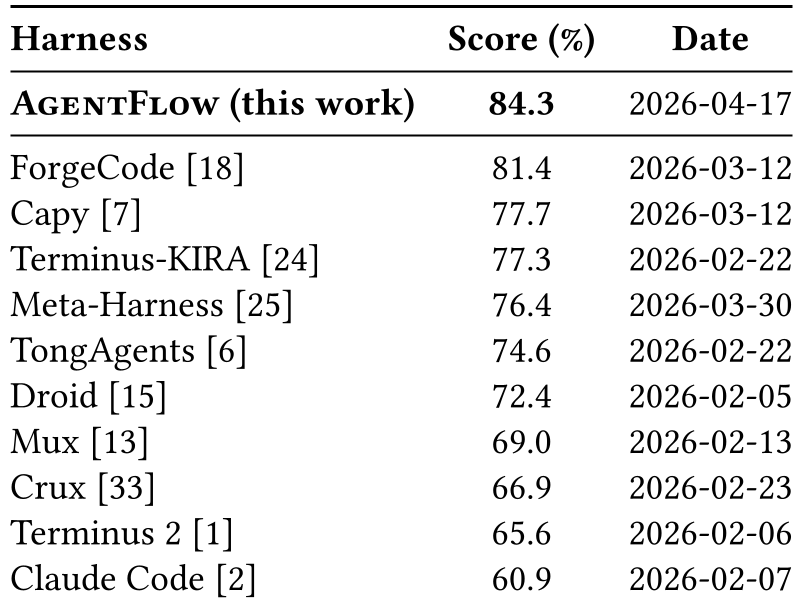 表 1:AgentFlow 在公认榜单上全面超越 ForgeCode 等强力竞争对手。
Chrome 实战:10 个 0-day 的含金量
在 3500 万行代码的 Chrome 森林里,AgentFlow 驱动中端模型 Kimi K2.5 发现了 10 个 0-day。其中 CVE-2026-5280 和 CVE-2026-6297 属于最危险的“沙箱逃逸”类别,意味着攻击者可以从网页端直接控制宿主机。
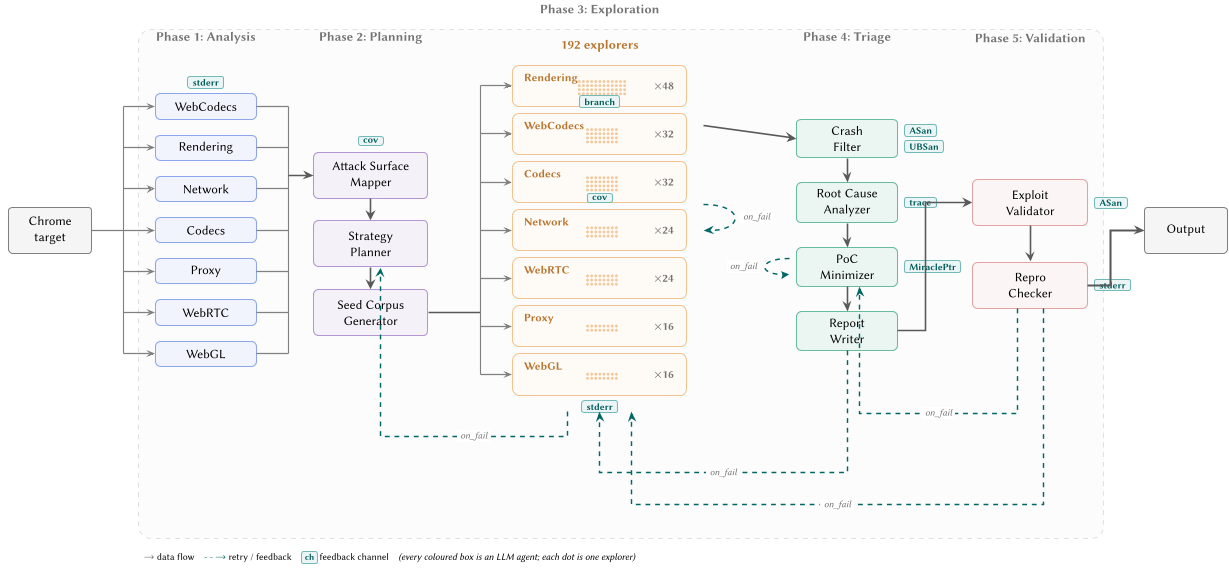 图 2:针对 Chrome 任务自动合成的超大规模架构:包含 18 个角色和 192 个并行探测器。
深度洞察:为什么有效?
- 由于“类型系统的筛选”:AgentFlow 在派发昂贵的 API 调用前,会先用 DSL 校验拓扑是否连通、变量是否引用正确。实验显示这拦截了 20% 的无效尝试,极大节省了成本。
- 责任归因(Attribution):Diagnoser(诊断器)会分析“是因为分析器没说明白,还是构造器没写对”,这种细粒度的定位使得下一步的 Prompt 改写有的放矢。
总结与未来展望
AgentFlow 证明了:Agent 系统的瓶颈不仅仅是模型层,更是架构层。 通过一套能够自我演进的类型化 DSL,我们可以让 LLM 智能体团队像一支正规军一样协作,在极高复杂度的任务中超越人类专家的手工设计。
未来的研究方向可能在于如何将这种“拓扑自动合成”的思想引入到多模态设计或其他开放域决策任务中。