
[arXiv 2503] Synthetic Mixed Training:突破 RAG 天花板,开启参数化知识获取的新缩放法则
Synthetic Mixed Training: Scaling Parametric Knowledge Acquisition Beyond RAG
本文提出了 Synthetic Mixed Training(合成混合训练)框架,通过结合合成问答对(Synthetic QAs)与合成文档,显著提升了语言模型在受限领域获取参数化知识的能力。该方法在多项长文档阅读理解基准测试中超越了 RAG,其最终方案在 QuaLITY 任务上比 RAG 相对提升了 4.4%。
TL;DR
长期以来,检索增强生成(RAG)被认为是处理特定领域知识的“金标准”,而通过 fine-tuning 让模型记住新知识往往被认为效率低下且容易触碰天花板。来自斯坦福、MIT 和华盛顿大学的学者通过 Synthetic Mixed Training 证明:只要混合配比得当并引入 Focal Rewriting 提升多样性,合成数据训练后的模型不仅能突破 RAG 的性能上限,还能展现出极佳的对数线性扩展(Scaling)特性。
痛点深挖:为什么简单的合成数据 scaling 会失效?
在工业界和学术界,针对特定领域(如医疗、金融)进行持续预训练(Continued Pre-training)时,通常会遇到两个尴尬的现实:
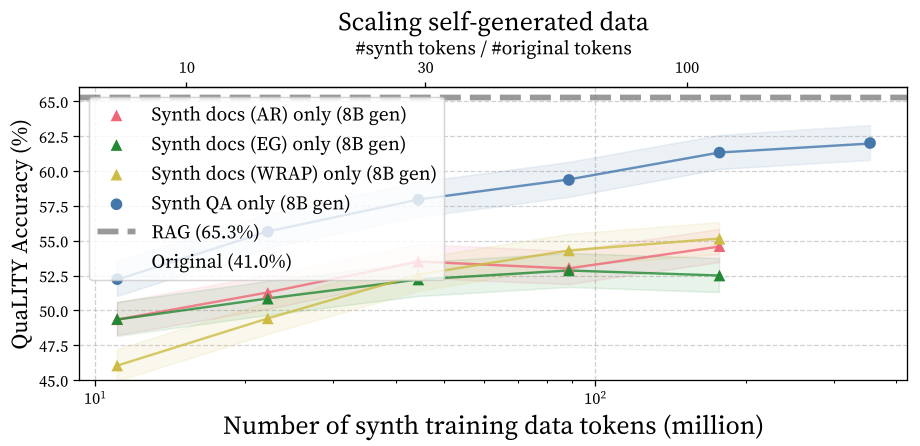
- 收益递减:单纯增加合成 Token 的数量,性能提升很快就会进入平台期,甚至远不如直接挂载一个 RAG 系统。
- 生成器悖论:即使使用更强的模型(如用 Llama-70B 产生数据给 8B 训练),收益也并不总是线性增加。
作者发现,现有的合成文档(如重排、实体图构建)虽然风格多变,但主题(Topic)极其重复。模型在训练过程中反复见到相似的事实,导致了严重的过拟合和获取新知识的效率低下。
核心方法论:Synthetic Mixed Training & Focal Rewriting
1. 混合训练的直觉:行为知识 vs. 事实知识
论文提出了一个深刻的洞见:
- 合成 QA(问答):教会模型“如何思考”和“如何提取”,这是一种跨领域的行为知识(Behavioral Knowledge)。
- 合成文档:由于包含了大量原始语料的细节,它们主要提供事实知识(Factual Knowledge)。
通过将两者以 1:1 的比例混合,模型能够同时学会“知识本身”以及“如何检索并利用这些知识”。这种协同效应让 Scaling 曲线从停滞转变为持续上升。
2. Focal Rewriting:注入问题的“焦点”
为了解决文档多样性不足的问题,作者引入了 Focal Rewriting(焦点重写)。在生成合成文档时,不再只是盲目地命令“重写这段话”,而是加上一句指令:“请专注于回答这个问题:{{Query}} 来重写文档”。
这种方式强制生成器从不同的视角切入同一份原始材料,从而在语义空间中产生了更广泛的覆盖。
实验与结果:参数化知识的胜利
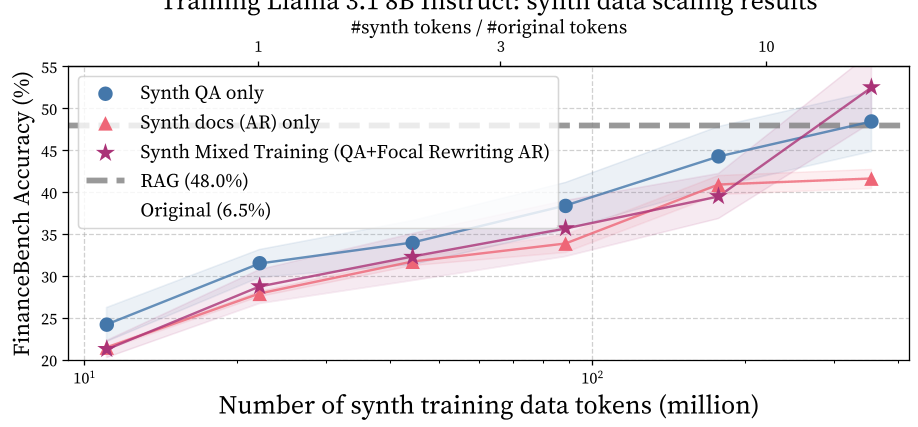
作者在 QuaLITY(虚构故事)、LongHealth(医疗教育)和 FinanceBench(金融)三大基准上进行了验证,结果令人振奋:
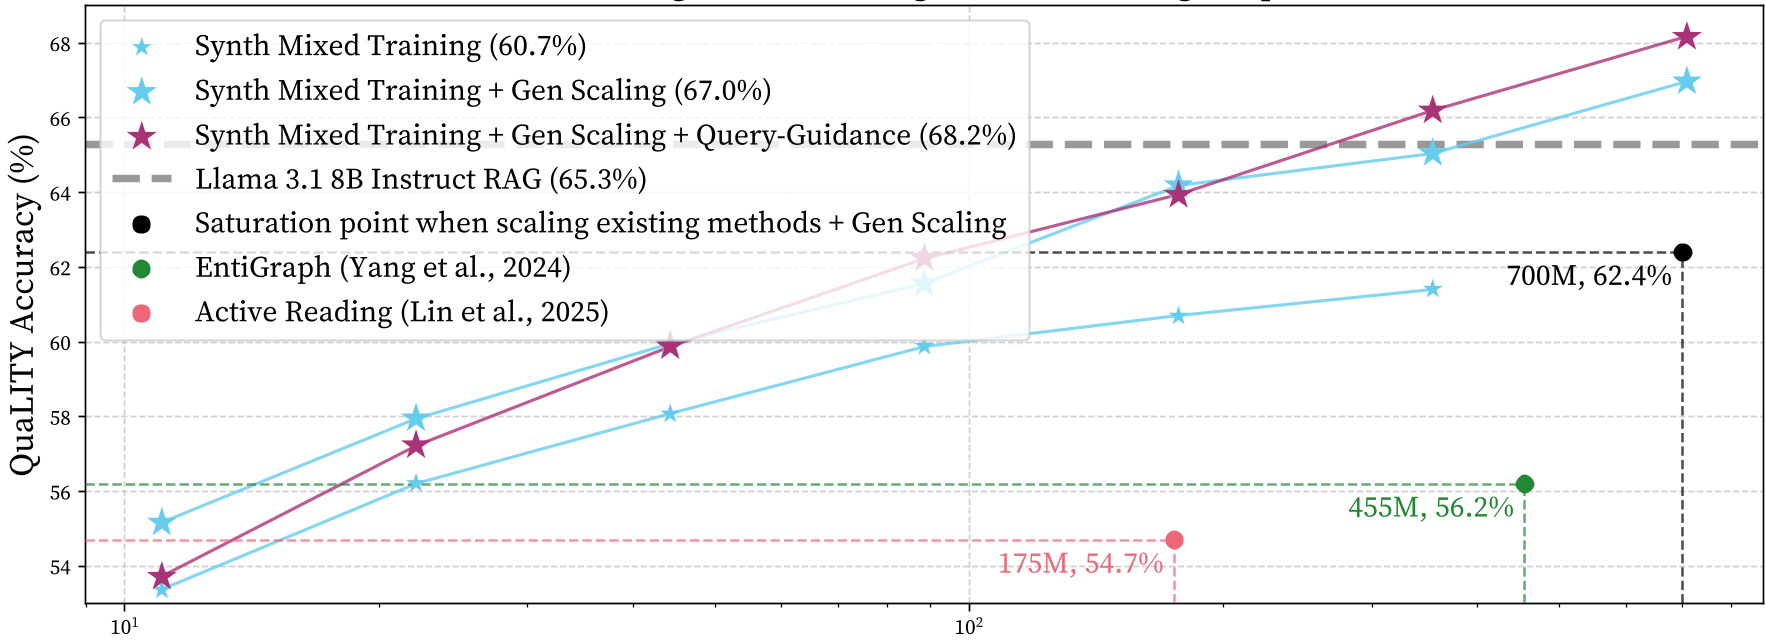
- 超越 RAG:在同等条件下,经过 700M 合成 Token 训练的 8B 模型在 5 个设置中击败了 RAG。
- Scaling Law 验证:如图所示,混合训练后的模型性能随 Token 数量呈完美的对数线性增长。
- 大模型的优势:模型越大,获取知识的效率越高。14B 模型比 1.7B 模型达到相同 RAG 水平所需的合成 Token 减少了近 8 倍。
关键发现:即使有 RAG,训练依然必要
最值得关注的结果是,当模型通过这种方法“内化”了知识后,再结合外部 RAG,性能会再次大幅度提升(+9.1%)。这说明参数化存储和外部检索并不矛盾,而是 1+1>2 的关系。
深度洞察与总结
Takeaway
- 不要只喂文档或只喂 QA:混合配比是解锁扩展性的钥匙。
- 多样性高于质量:与其追求极高质量的单条数据,不如通过 Focal Rewriting 追求事实覆盖的广度。
局限性
研究目前集中在 1.7B 到 14B 的中小规模模型,更大规模模型(如 70B+)的参数化效率是否依然遵循同样的斜率仍需验证。此外,如何在这种密集的知识注入过程中防止模型“灾难性遗忘”旧知识,依然是一个需要配合 Replay 策略的挑战。
结论
这项研究为我们指明了方向:未来的行业垂直模型不应仅仅依赖一个外挂数据库,通过高效的合成混合训练让模型“满腹经纶”,才是走向 SOTA 的必经之路。