
THINC:让代码成为语言模型的灵魂推理器,而非辅助工具
Teaching Language Models to Think in Code
本文提出了 THINC (Thinking in Code) 框架,让语言模型将代码作为核心推理器而非简单的 NL 驱动工具。通过 SFT 与 GRPO 强化学习,THINC-4B 在多项竞赛级数学基准测试(如 AIME)中达到 SOTA,平均准确率达 78.1%。
TL;DR
在解决复杂的数学竞赛问题时,LLM 常常在 Chain of Thought (CoT) 中产生微小的计算偏差,这种“蝴蝶效应”会导致最终结果的崩溃。本文提出的 THINC (Thinking in Code) 框架打破了传统的“自然语言规划+代码验证”模式,强制模型在简短规划后完全进入“代码思维”模式。THINC-4B 模型凭借 4B 的参数规模,在 AIME 等硬核数学竞赛中的表现超越了 235B 的巨型模型,证明了推理结构的效率远比模型规模更重要。
痛点深挖:交织式推理的“虚假繁荣”
当前的工具集成推理(Tool-integrated Reasoning, TIR)虽然引入了代码执行,但存在三个致命伤:
- 后置验证 (Post-hoc Verification):模型先用 NL 算出答案,再写代码验证。此时代码是“跑龙套”的,没参与真正的逻辑推导。
- 错误传播 (Unreliable Computation):NL 推导中的算术错误会作为常量被硬编码(Hard-coded)进代码块,Interpreter 根本无法纠正这种逻辑外的错误。
- 角色重叠 (Misallocated Roles):NL 做了代码该做的事(算法实现),代码只是 NL 的转录,两者没有形成真正的互补。
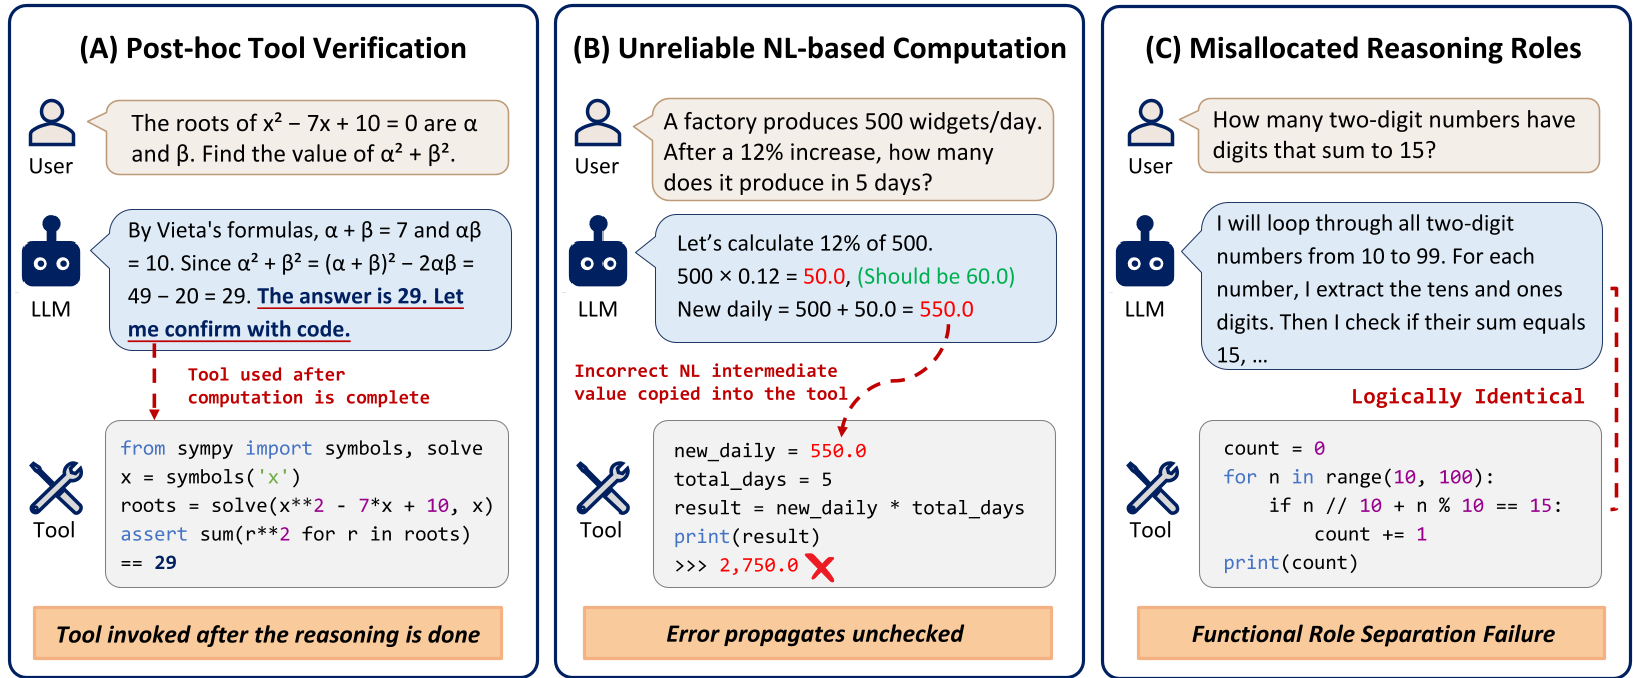 图 1:展示了传统 TIR 模式(A, B, C)如何因为 NL 与代码的耦合导致推理失败。
方法论详解:Thinking in Code 的核心逻辑
THINC 的核心理念是:代码即推理 (Code as Reasoner)。
1. 轨迹重构 (The THINC Trajectory)
不同于传统的 NL -> Code -> NL -> Code,THINC 遵循以下范式:
其中 仅仅是高层的策略规划(Strategy),严禁包含具体计算。从 开始,所有的推理步进都在代码块中完成,每一块代码的输入都依赖于前一块的执行结果 。
2. 三阶段训练流程
- 蒸馏与 SFT:从 Qwen3.5-27B 中蒸馏出 1.22万条高质量的“中心化代码轨迹”。
- 强化学习 (RL):使用 GRPO (Group Relative Policy Optimization) 算法,配合可验证的奖励(Verifiable Rewards),在 DAPO-Math 数据集上进行三阶段课程学习。
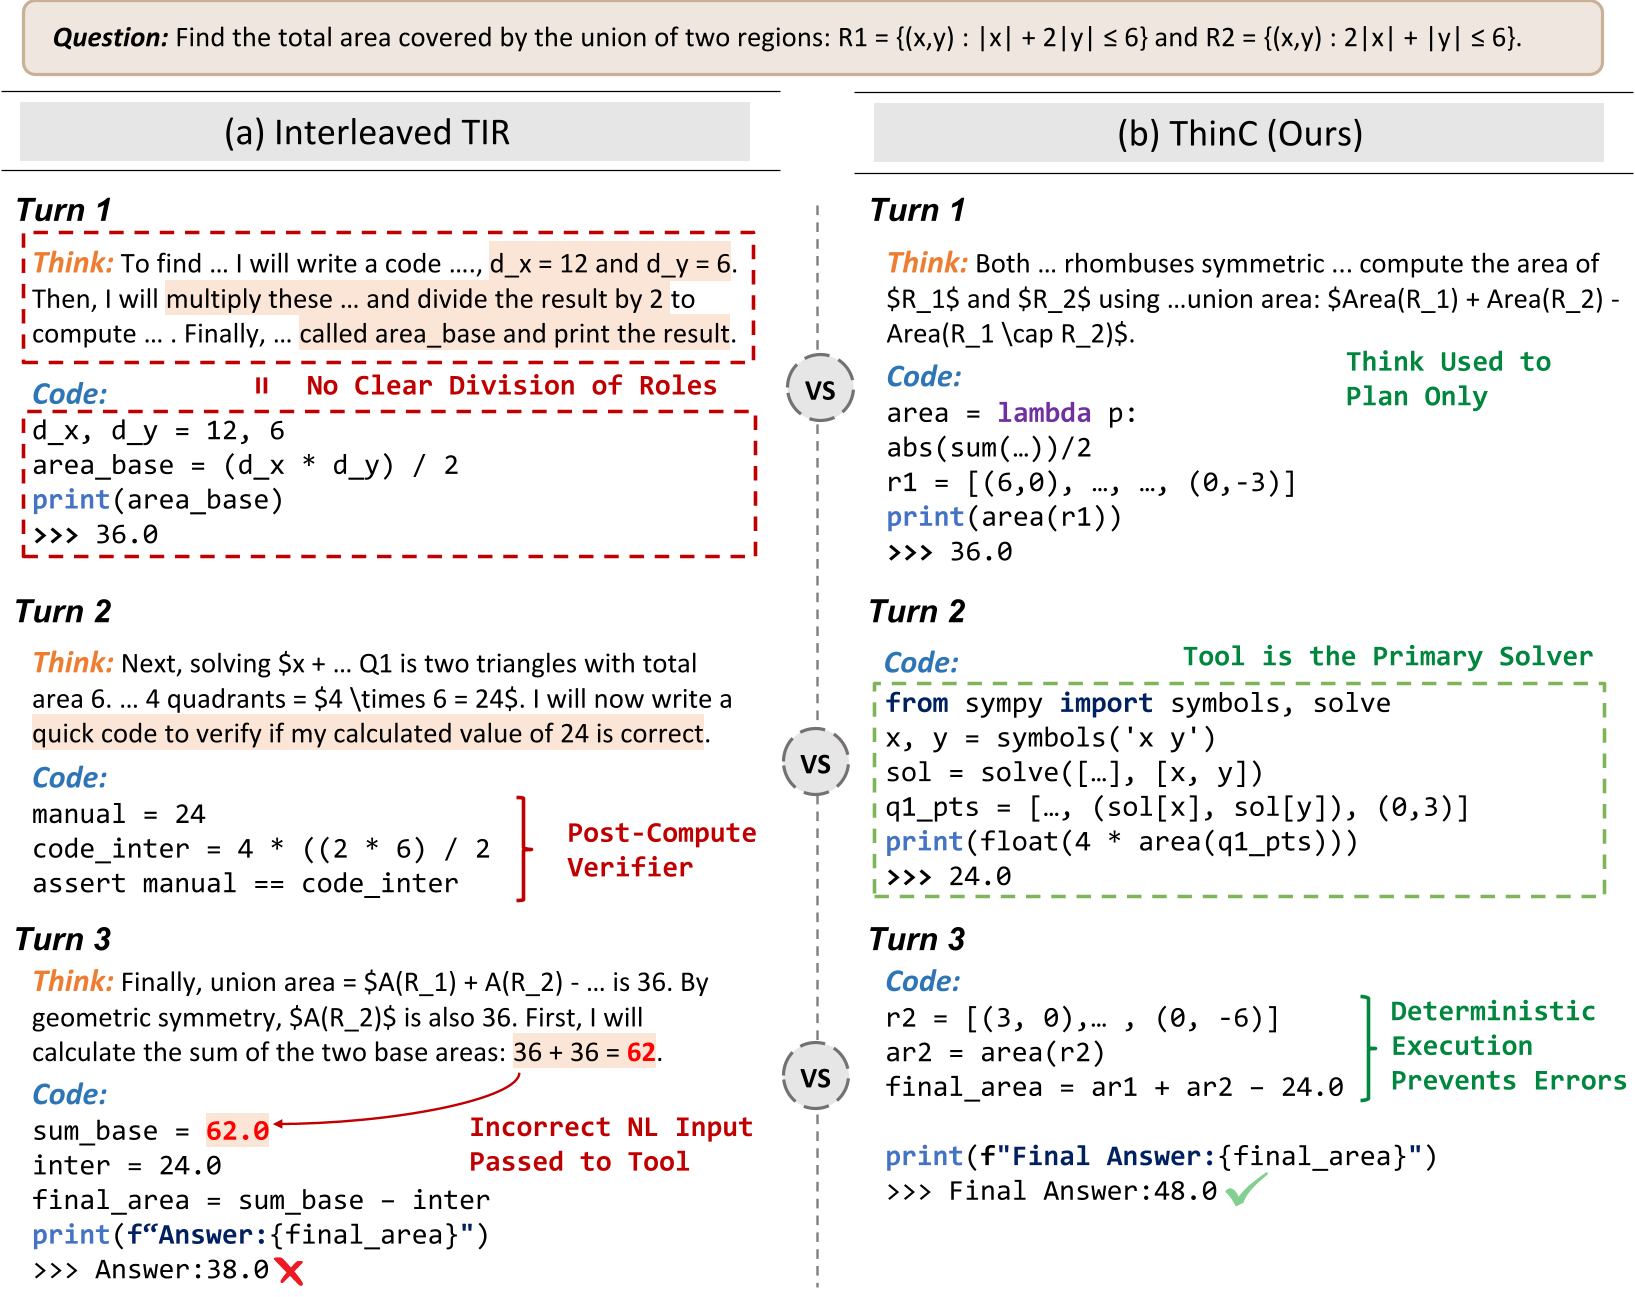 图 2:THINC 结构确保了所有的中间变量都由 Python 解释器验证。
实验与结果:小模型逆袭大模型的典范
在 AIME 2024–2026 和 BeyondAIME 等五个 benchmark 上的评估结果显示:
- THINC-4B 均分达 78.1%,超越了基线模型 ASTER 以及超大规模的 Qwen3-235B。
- 推理鲁棒性:实验中故意让前几轮代码执行报错,THINC 展示了惊人的恢复能力(Recovery@k)。即使连续 3 轮报错,它依然能通过代码自我修正(Self-correction),而传统 TIR 模型的表现则呈断崖式下跌。
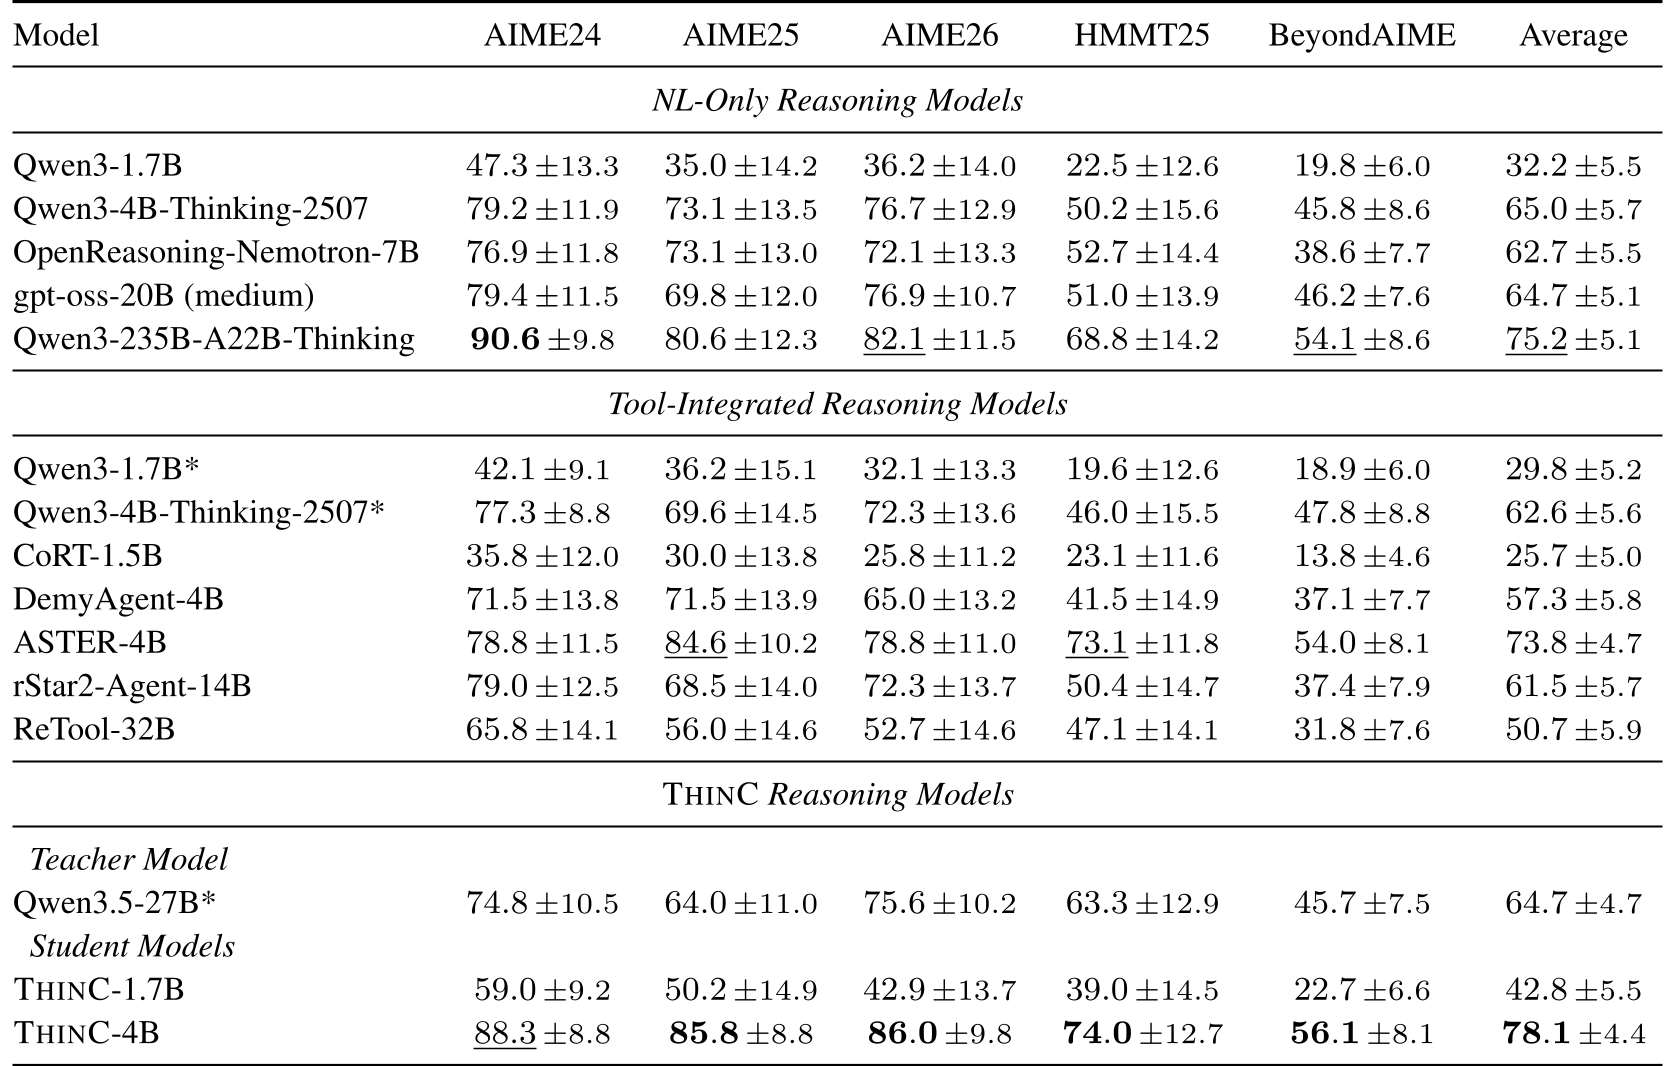 表 1:THINC 模型在各大竞赛基准上的全面领先。
深度洞察:为什么 THINC 算得准?
THINC 的成功并非因为它的“记忆力”更强,而是因为它实现了真正的 Inductive Bias(归纳偏置)。
- 99.2% 的代码锚定率:意味着几乎所有的最终答案都“长”在解释器的输出里。
- 摆脱 NL 幻觉:将容易出错的符号推导移交给具备确定性的 Python 运行环境。
- 自我修正能力:由于模型强制在代码块中进行思考,它在面临报错时,更倾向于通过修改算法逻辑来“走出困境”,而不是在 NL 中寻找借口。
局限性与展望
尽管 THINC 在数学领域表现卓越,但其对于不适合代码量化的推理任务(如纯文学创作或模糊逻辑判断)可能存在局限。未来的研究方向在于如何将这种“代码中心化”的确定性思维扩展到更广泛的 Agent 系统中,使 AI 在面对复杂现实问题时,不仅能“说得好听”,更能“做得精准”。