
[EuroSys 2025] TensorHub:彻底终结 LLM 强化学习中的权重传输瓶颈
TensorHub: Scalable and Elastic Weight Transfer for LLM RL Training
本文推出了 TensorHub,这是一个专为大语言模型(LLM)强化学习(RL)训练设计的可扩展且富有弹性的权重传输系统。该系统基于一种名为引用导向存储(Reference-Oriented Storage, ROS)的新型抽象机制,通过复用 GPU 显存中已有的模型副本作为数据源,实现了在无需额外存储空间和数据所有权开销的情况下的高效权重同步。
TL;DR
在 LLM 的强化学习(RL)训练中,数千个 Rollout 工作负载需要频繁地从 Trainer 处“抢夺”最新的模型权重。传统的通信库(NCCL)不够灵活,而传统的存储系统(Ray/PS)又太慢。ByteDance Seed 团队提出的 TensorHub 引入了引用导向存储 (Reference-Oriented Storage, ROS) 概念:它不存数据,只存“谁手里有数据”。通过复用 GPU 显存中的副本,TensorHub 在 1024 卡规模下实现了近乎物理极限的传输性能。
痛点深挖:为什么 LLM RL 需要新的“存储”?
强化学习训练是一个高频循环:训练器更新权重 -> 传输权重 -> 采样器进行推理。目前的生产环境面临三大挑战:
- 拓扑复杂:算力分布在不同的 Data Center,跨区带宽极贵且慢。
- 弹性算力:为了省钱,RL 常使用“竞价实例(Spot Instances)”,这些机器随时可能下线,NCCL 这种静态通信组一旦死掉一个节点就会导致全局崩溃。
- 数据爆炸:TB 级的权重如果先存入 CPU 内存再下发,Pipeline 耗时将统治整个训练周期。
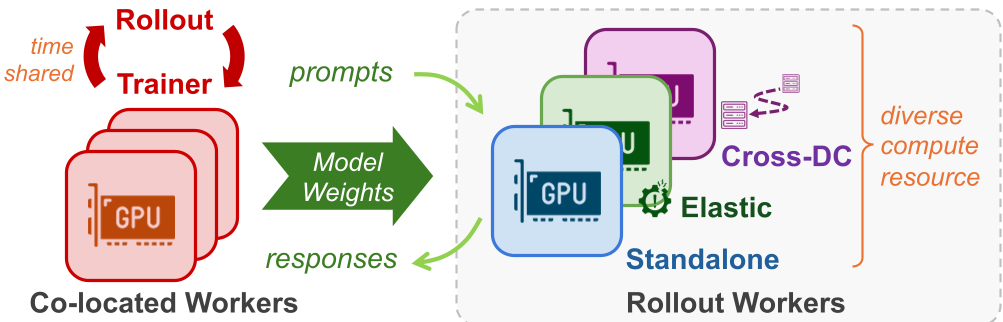
核心直觉:Reference-Oriented Storage (ROS)
作者发现了一个关键点:既然每个正在推理的 Worker 显存里已经有了模型副本,为什么我们还要找一个中心化的服务器去存一份备份?
ROS 的核心思想是放弃所有权:
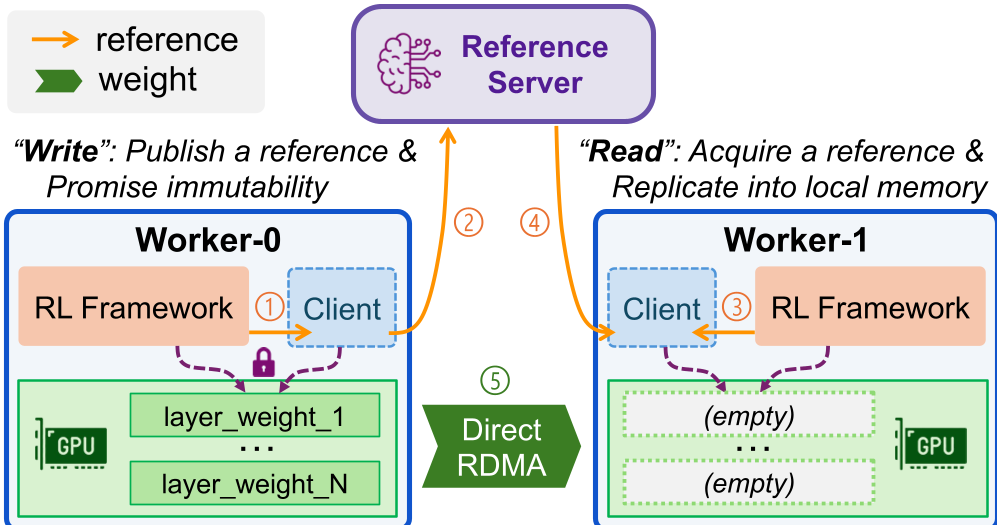
- Publish:Worker 告诉服务器:“我这儿有版本 V12 的模型分片,我承诺在下一次 Unpublish 前不改动它。”
- Replicate:新来的 Worker 询问服务器哪儿有 V12,服务器直接指派一个最近的(如同数据中心的)在线 Worker,两者通过 RDMA 直接进行 Peer-to-Peer 传输。
这种设计消除了冗余的内存拷贝,带宽利用率达到了 RDMA 理论极限的 88%。
关键技术:如何在大规模下不崩盘?
1. 流水线复制 (Pipeline Replication)
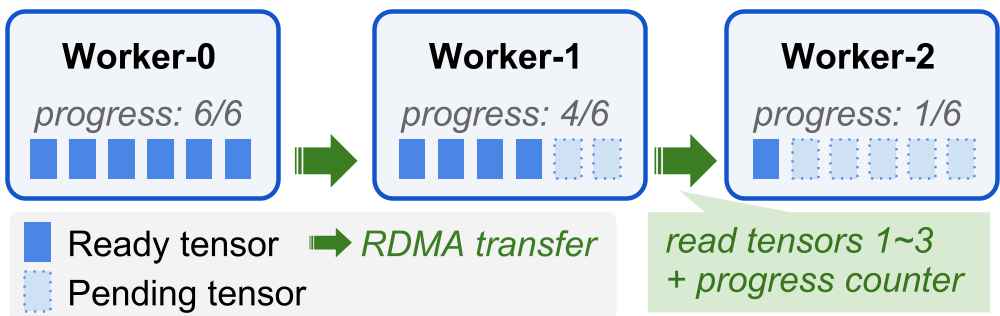
当 100 台机器同时找 1 台机器要权重时,单机的上行带宽会爆掉。TensorHub 采用了类似 BitTorrent 的思路:Worker A 在从 Trainer 下载的同时,Worker B 就可以开始从 Worker A 已下载的部分中进行读取。这种 DAG 拓扑 让集群总带宽随节点数线性增长。
2. 模型并行一致性 (Model-Parallel Consistency)
由于 LLM 是分片存储的,同一模型并行组内的所有 Worker 必须看到同一个“最新版本”。TensorHub 引入了事务性语义,确保组内步调一致,防止有的 Worker 拿到了 V12,有的却拿到了 V13 导致计算逻辑 divergence。
3. 跨数据中心优化 (Offload Seeding)
对于跨 DC 场景,TensorHub 会自动选举一个“种子节点”。该节点通过 TCP 慢速拉取,一旦拉取完成,该 DC 内部的所有其他机器立即可过 RDMA 内部“内卷”式高速同步,避免了多次占用昂贵的跨区带宽。
实验战绩
在真实的大规模 RL 任务中,TensorHub 展现了统治级的优势:
- 单机效率:50GB 权重传输仅需 2.2 秒,性能远超 Ray Plasma(甚至 Ray 在 TB 级数据下经常 OOM)。
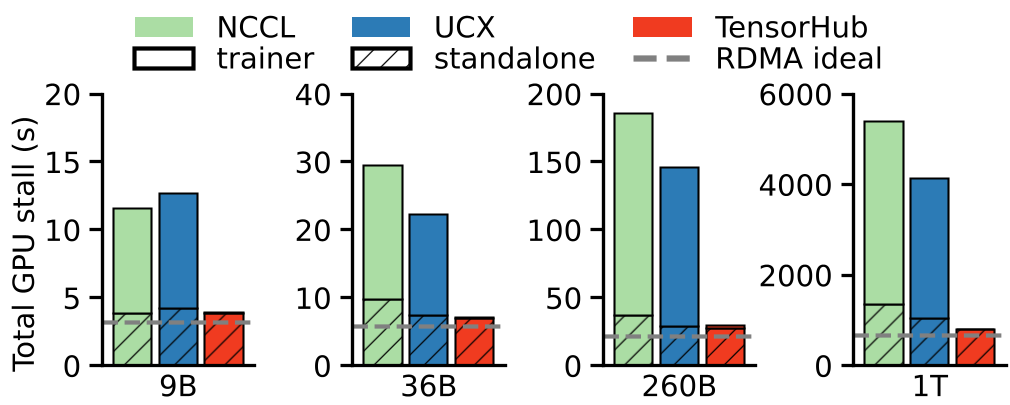
- 万亿模型 (1T):在 1024 卡实验中,TensorHub 消除绝大部分 Trainer 等待时间,相比 NCCL 减少了 6.7 倍 的 GPU 停工。
- 跨 DC 表现:在跨 DC 场景下,由于避免了冗余的 TCP 流量,表现提升了 19 倍。
深度洞察与总结
TensorHub 的成功在于其深刻理解了 “算力即存储” 的现代 AI 特点。在传统的分布式系统中,存储和计算是解耦的;但在超大规模 AI 训练中,显存昂贵且稀缺,数据本身就在计算节点上高度冗余。
Takeaway: TensorHub 不仅仅是一个性能工具,它为构建超大规模异步强化学习系统铺平了道路。它允许研究者在混合了 H100, A100 以及各类 Spot 实例的复杂环境中,依然能维持极高的训练吞吐量。目前该系统已在字节跳动生产环境上线,支持其最前沿的 RL 训练任务。
局限性: 该系统依赖于版本化的不可变假设。如果未来的 RL 算法需要超高频(例如每秒多次)的亚毫秒级权重更新,ROS 的元数据管理可能会成为新的瓶颈。