
TC-JEPA:当文本成为视觉预测的“导航灯”,破解特征学习的不确定性
Text-Conditional JEPA for Learning Semantically Rich Visual Representations
本文提出了 TC-JEPA,一种基于文本引导的联合嵌入预测架构(JEPA)。该方法通过引入图像字幕(Captions)作为 Predictor 的条件输入,显著降低了掩码特征预测任务中的视觉不确定性,在 ImageNet-21k 等数据集上实现了语义丰富的视觉表征学习。
TL;DR
TC-JEPA(Text-Conditional JEPA)是一项突破性的自监督学习工作。它在经典的 I-JEPA 架构基础上,通过引入 Fine-grained Text Conditioner,利用文本字幕(Captions)显著降低了 Predictor 在重建掩码特征时的视觉不确定性。实验证明,TC-JEPA 不仅在分类任务上追平了 DINOv2 等强基线,在语义分割和物体检测等细粒度视觉理解任务上更是展现出远超对比学习方法(如 CLIP/SigLIP)的性能。
视觉预测的瓶颈:迷失在掩码之后
自监督视觉学习一直有两大流派:不变性学习(Invariance-based)(如 DINO)擅长高层语义但依赖人工增强;掩码建模(MIM/JEPA)(如 MAE, I-JEPA)擅长局部结构但在预测被遮挡区域时面临极高的视觉歧义。
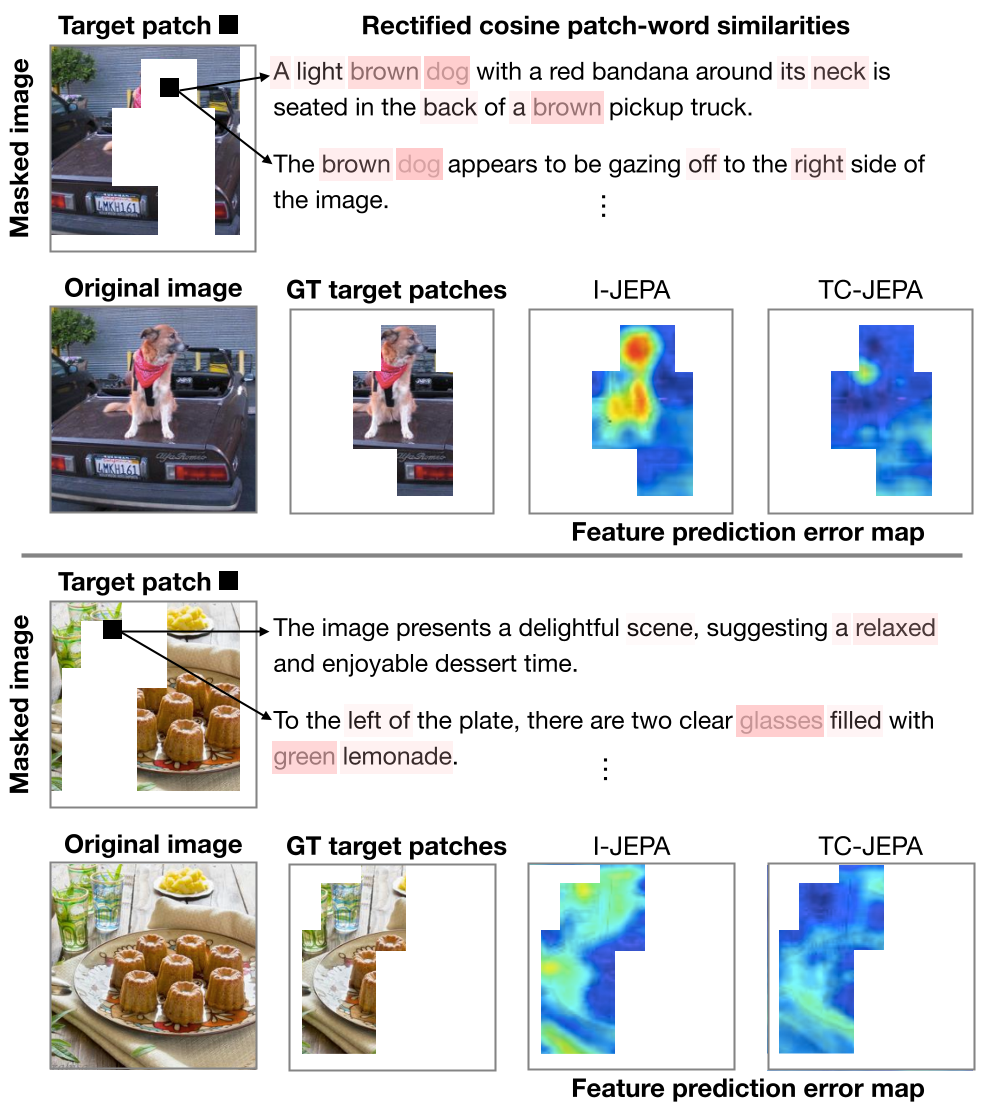
设想一张照片:一只狗坐在书架旁,书架的大部分被遮盖了。Predictor 仅仅根据狗的边缘,很难判断遮盖位置是书架、墙壁还是沙发。这种“瞎猜”导致模型学习到的表征缺乏明确的语义指向。
核心机理:文本作为语义先验
TC-JEPA 的核心直觉非常直观:如果 Predictors 能“读到”相关的文字描述,预测就会变得简单且准确。
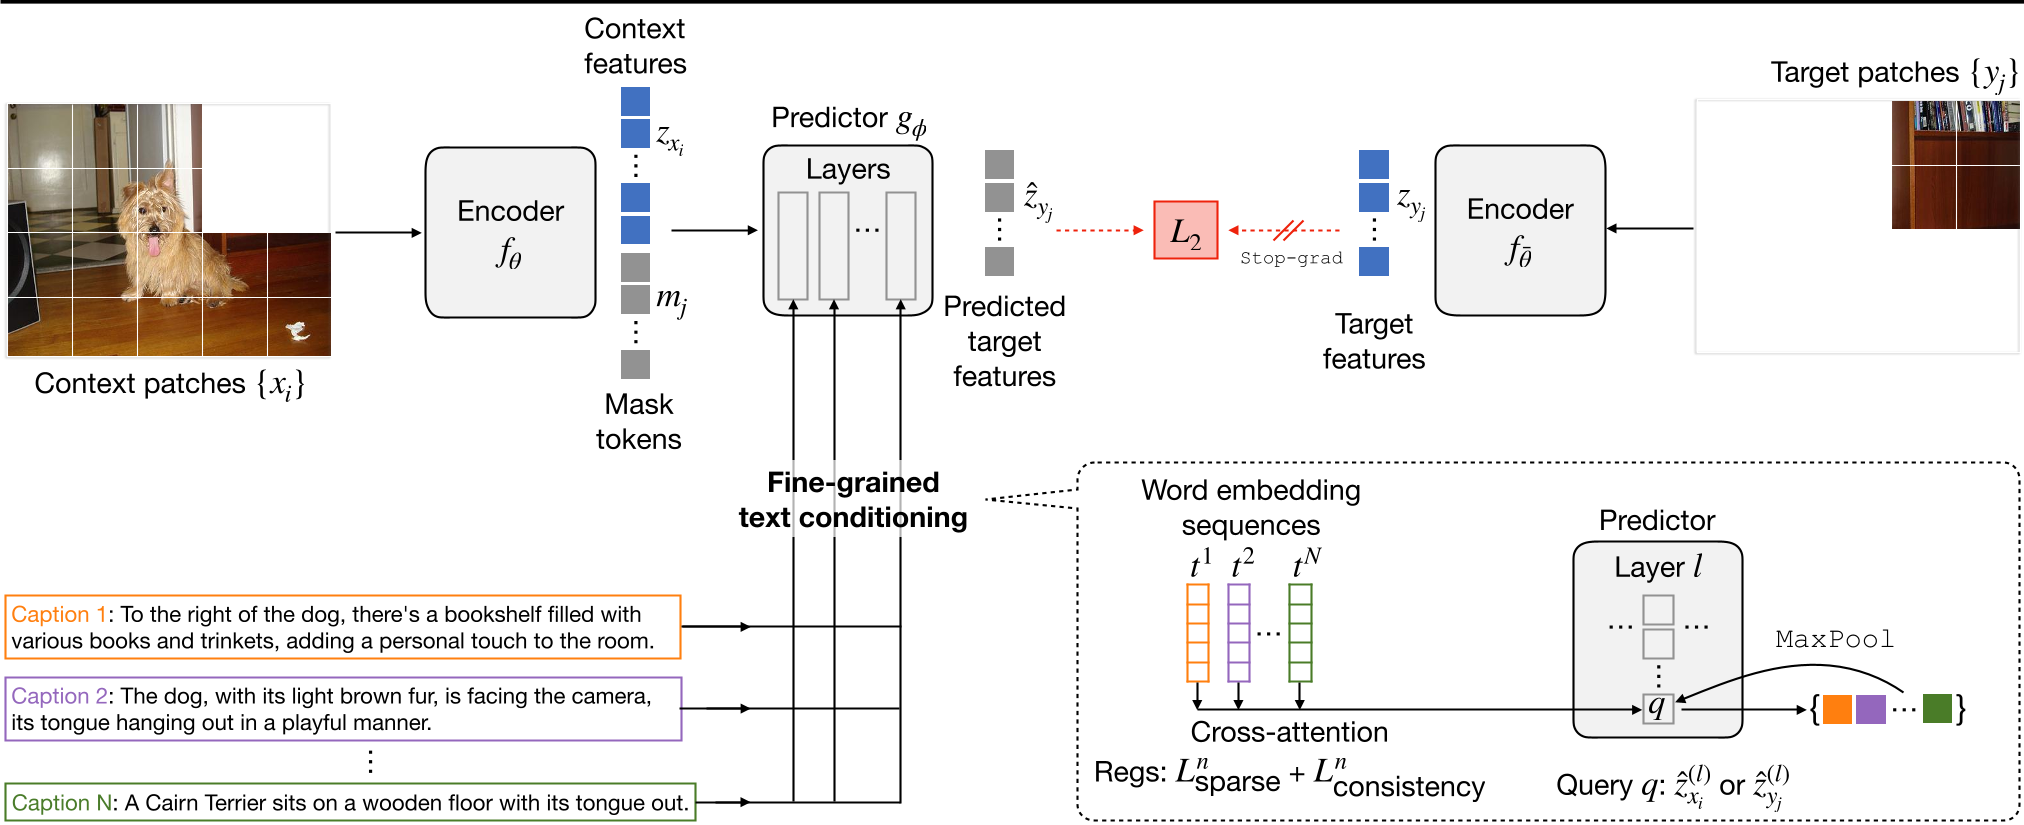
1. 细粒度文本调节器 (The Conditioner)
作者没有简单地把文本向量拼接到输入端,而是设计了一个精巧的交叉注意力机制。
- Cross-Attention Over Atoms: 每个图像 Patch 特征作为 Query,去寻找文本中对应的 Token。
- Multi-layer Modulation: 这种调节发生在 Predictor 的多个层级,确保文本信息能深度渗透到特征生成的过程中。
- 无监督视觉对齐: 虽然利用了文本,但 Patch 和单词之间的对应关系是完全自发学习的,无需任何 Grounding 标注。
2. 约束的力量:稀疏性与一致性
为了防止注意力机制产生冗余或噪声,作者引入了两条关键规则:
- Lsparse (稀疏约束):强迫 Patch 只关注最相关的几个单词,提高语义的“纯度”。
- Lconsistency (一致性约束):要求模型在不同层级对同一个 Patch 的关注点保持逻辑上的一致。
实验战绩:以小博大的典型
TC-JEPA 在各类视觉任务中展现了极其恐怖的“缩放效率”(Scaling Efficiency):
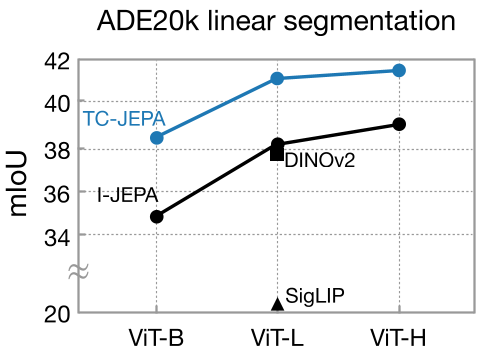
- 语义分割 SOTA: 在 ADE20k 线性预测任务中,TC-JEPA (ViT-L) 使用 30M 数据达到了 42.1 mIoU,超越了使用 2B 数据的 Web-DINO。
- 破解对比学习难题: 相比经典的 CLIP 架构,TC-JEPA 在需要精确位置信息的任务(检测/分割)中大幅领先(ADE20k 提升了 16.6% 以上),证明了在 latent space 进行预测式学习比全局对比学习更能保留空间细节。
深度洞察:为何它比 CLIP 强?
对比学习(CLIP)本质上是一种“判别式”任务,它倾向于忽略图像中的细节,只保留能和文本匹配的全局特征(如:看到“狗”就够了,不管狗在哪)。
而 TC-JEPA 是一种“生成式预测”任务。Predictor 必须利用文本作为线索,精确地复原出被遮盖区域的 latent 特征。这就逼迫 Encoder 必须学会:
- 识别物体(由文本引导)。
- 理解空间分布(由位置特征引导)。
- 学习特征之间的因果变换。
总结与局限
TC-JEPA 成功将 LLM 生成的合成数据能力反哺给传统视觉 SSL。它最大的意义在于:证明了 Predictor 的“不确定性”是可以通过多模态信息来对冲的。
局限性:
- 合成数据依赖:目前高度依赖 ShareGPT4V 生成的高质量长字幕,若模型产生“幻觉”,可能会干扰视觉表征。
- 训练成本:虽然推理速度快,但预训练阶段需要额外的 T5 Text Encoder 和带 Cross-Attention 的 Predictor,算力开销略高于 I-JEPA。
这一技术路径预示着未来视觉大模型的方向:不再是单一的“看图说话”,而是通过文本条件下的世界模型模拟,去建立更深层的物理与语义理解。