
TextLDM:打破范式隔阂,用视觉扩散的配方重塑语言建模
TextLDM: Language Modeling with Continuous Latent Diffusion
本文提出了 TextLDM,一种基于连续隐空间扩散(Continuous Latent Diffusion)的语言模型。该方法通过 TextVAE 将离散 Token 映射为连续向量,并利用以 Flow Matching 为目标的 Diffusion Transformer (DiT) 进行预训练,在文本续写任务上达到了与 GPT-2 相当的水平。
TL;DR
长期以来,视觉生成(Diffusion/Flow Matching)与语言建模(Autoregressive)分属于两条平行的技术路线。TextLDM 成功地证明了:只要隐空间(Latent Space)训练得足够好,视觉领域的 DiT 成功算法——包括 VAE、Flow Matching、Logit-normal 调度和 CFG——可以直接应用于文本生成,并取得媲美 GPT-2 的效果。
背景定位
在学术坐标系中,TextLDM 是一项试图统一生成范式的桥梁式工作。它挑战了“文本必须自回归”的思维定式,将语言建模看作是连续空间内的轨迹 ODE 求解。
动机:为什么以前的扩散语言模型不行?
过去的研究发现,即使 VAE 的 Token 重构准确度接近 100%,其生成的隐向量在下游扩散任务中表现依然糟糕。作者敏锐地察觉到:重构精度(Fidelity)并不等于表示的有效性(Effectiveness)。对于扩散模型而言,隐空间不仅要能“还原”,还要有“语义几何结构”,以便模型在去噪轨迹上进行插值。
核心方法论:TextLDM 的两大支柱
1. 强化版的 TextVAE 与 REPA 对齐
为了解决隐空间质量问题,TextLDM 引入了 Representation Alignment (REPA)。在训练 VAE 时,模型不仅要学习如何重构 Token,还要强迫编码器的中间特征去“模仿”一个冻结的强大语言模型(如 Qwen3)的隐藏状态。
- 直觉:借用预训练 LLM 的语义地图来约束 VAE 的隐空间分布。
- 层级选择:实验发现对齐倒数第 3 层比对齐最后一层效果更好,因为最后一层往往过于关注 Token 预测,而忽略了丰富的局部语义。
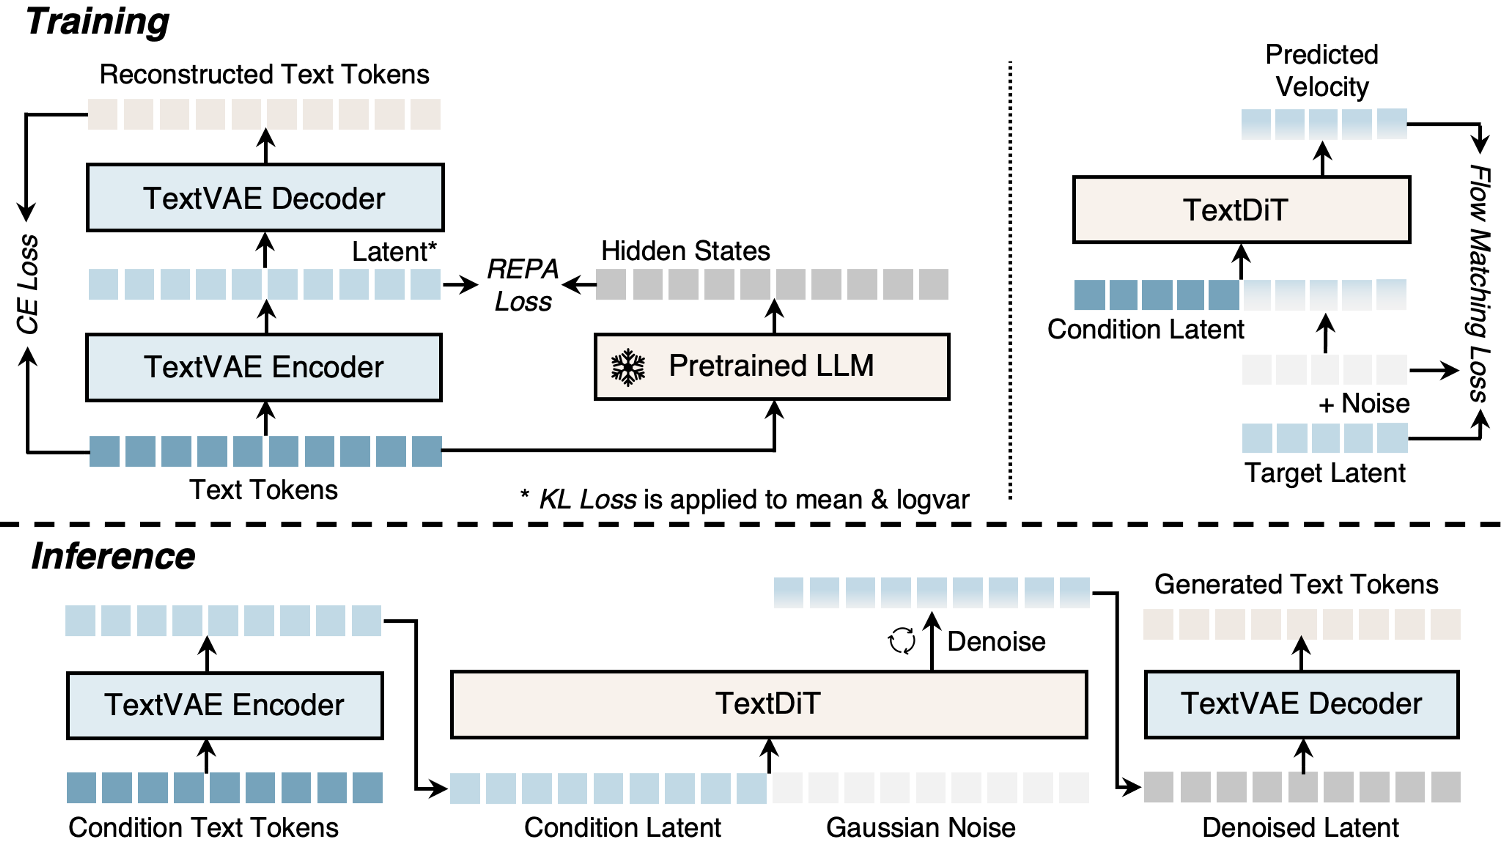 图 1: TextLDM 整体架构,包含基于对齐的 TextVAE 和采用 Flow Matching 的 DiT。
2. 标准化的 DiT 与 Flow Matching
在获得高质量隐空间后,TextLDM 采用了与视觉模型(如 Stable Diffusion 3)完全一致的 Flow Matching 训练配方。通过预测连接噪声与真实数据的“速度场”,模型可以一次性生成整段文本,而不需要像传统 AR 模型那样逐字扫一遍 KV Cache。
实验结果与性能对比
TextLDM 在多个数据集上展现了极强的竞争力,特别是在 768M 参数规模下,其在 ROUGE 和 MAUVE 等指标上全面超越了 GPT-2。
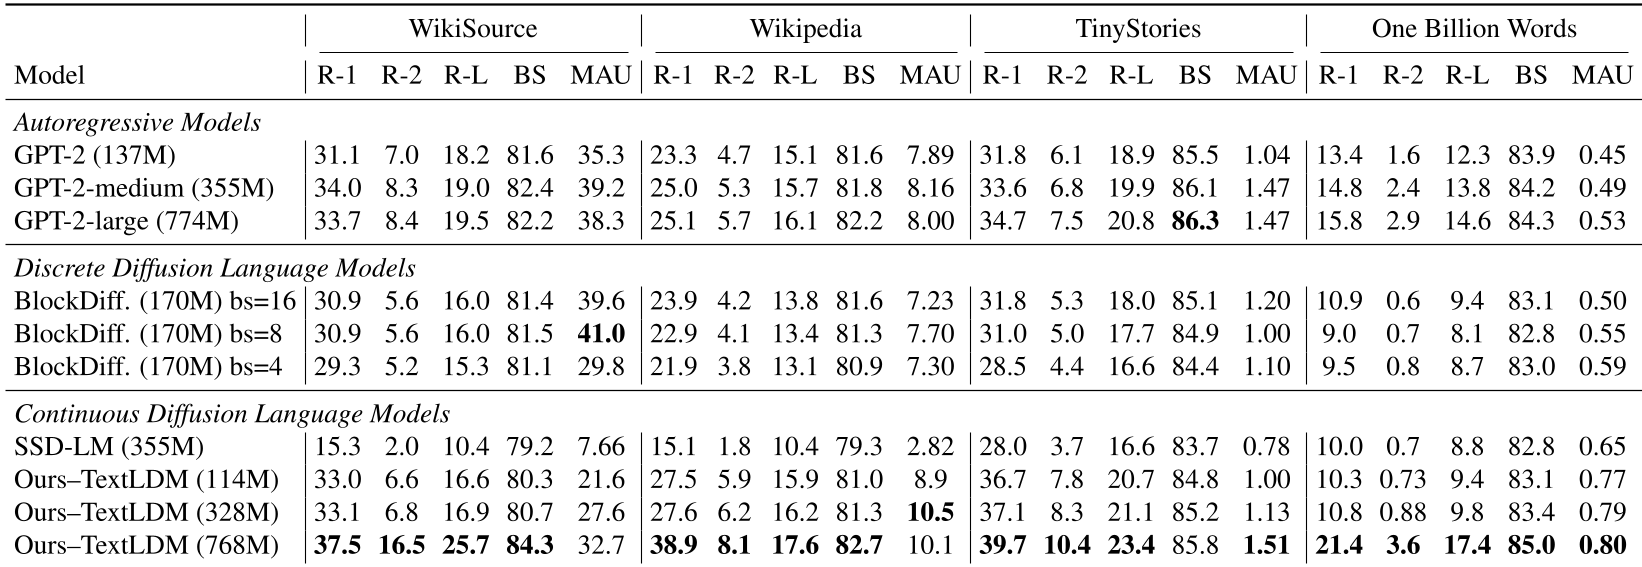 表 1: TextLDM 与 GPT-2、其他扩散模型的性能对比,展现了其在各基准上的领先地位。
此外,TextLDM 在推理效率上具有显著优势。如图 2 所示,AR 模型的计算量随序列长度线性增长,而 TextLDM 的推理步数(NFE)在很大范围内是恒定的。
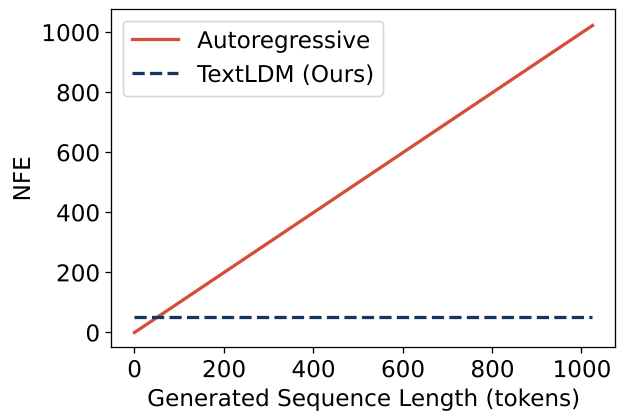 图 2: TextLDM 实现更高效的并行生成。
深度洞察与总结
TextLDM 的成功揭示了一个重要的学术信号:生成模型的底层架构正在收敛。
- Inductive Bias 的通用性:过去我们认为文本的离散性是扩散模型难以逾越的障碍,但实验证明,只要通过对齐手段将离散性掩盖在连续隐空间之下,DiT 依然是“全能王”。
- 局限性:尽管实验出色,但 TextLDM 仍是一个二阶段框架,TextVAE 的重构精度在分布偏移(OOD)时会下降,且目前尚未在大规模指令微调上验证。
结论:TextLDM 并不是简单的“把扩散模型用在文本上”,而是通过 REPA 机制解决了扩散路径在文本语义空间难以定义的难点。它让我们看到了未来在一个单一 DiT 骨干下,同时完成图像理解、视频生成和文本对话的可能性。