
深度非线性网络的鞍点逃逸理论:揭秘“平台期”背后的幂律
A Theory of Saddle Escape in Deep Nonlinear Networks
本文提出了一套描述深层非线性神经网络训练动力学的数学理论,重点研究了模型从鞍点(Saddle)逃逸并进入特征学习阶段的过程。核心贡献是推导出了一个适用于任何平滑激活函数的层平衡恒等式,并证明了逃逸时间 τ* 遵循 κ* = Θ(ε^-(r-2)) 的幂律,该规律由瓶颈层数 r 而非总深度 L 决定。
TL;DR
在神经网络训练中,我们经常观察到损失函数长时间停留在某个“平台”,然后突然下降。本文揭示了这一现象背后的物理机制:逃逸鞍点的时间并不直接取决于总层数,而是取决于初始化在极小尺度的瓶颈层数 。研究给出了一套全新的数学框架,精准预测了逃逸时间服从 这一幂律,不仅适用于线性模型,更完美涵盖了包括 Tanh, GELU 在内的各种非线性模型。
1. 痛点:为什么我们的深度学习理论跟不上实验?
在深度神经网络中,由于参数众多且高度非线性,梯度下降的轨迹往往非常复杂。前人的研究大多集中在两个极端:
- 深层线性网络:虽然有精确解,但缺乏非线性表达能力,无法解释真正的特征获取过程。
- 浅层非线性网络:无法体现“深度”带来的层次化动态。
以往的鞍点逃逸研究往往给出极其保守的“最坏情况”下界,但在实际的深度学习实验中(小初始化尺度 下),我们看到的是极具规律性的“长平台”与“突发转折”。作者认为,这背后必然存在某种被忽视的对称性。
2. 核心数学武器:非线性层平衡恒等式
作者发现,无论损失函数和激活函数如何,权重矩阵 Frobenius 范数的差值演化遵循一个精确的恒等式。这里的核心变量是 。
这个函数本质上衡量了激活函数偏离“线性”的程度:
- 如果 是线性函数,则 ,这就是著名的深层线性网络权重平衡守恒律。
- 如果 是非线性函数,作者将其分为四类(Class A-D),涵盖了目前所有的主流设计(如 Tanh 属于 Class ,GELU 属于 Class )。
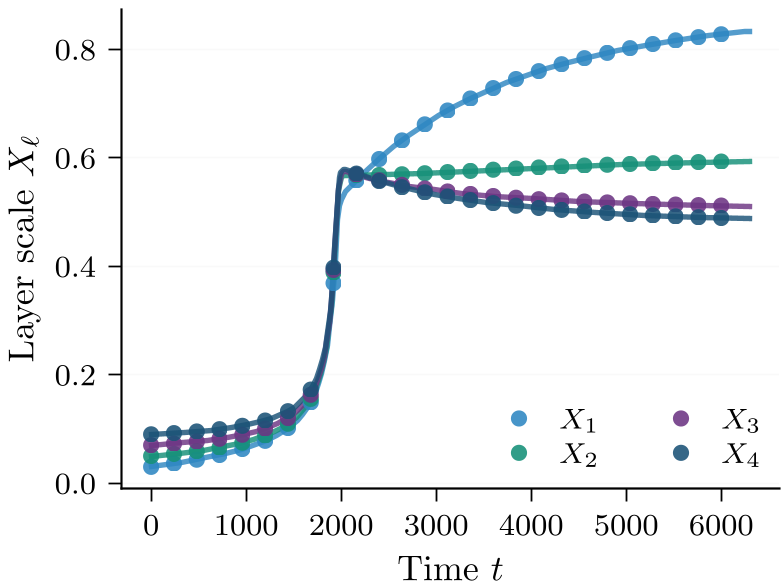 图 1:理论约简的实证确认。实线(标量 ODE 理论值)与圆点(全参数实验值)在损失曲线和权重尺度演化上几乎完全重合。
3. 临界深度定律:逃逸究竟需要多久?
这是本文最令人兴奋的发现。如果一个 层的网络中,有 层初始化在极小尺度 ,而其余层在正常尺度,那么:
- 当 :特征学习几乎是瞬间发生的。
- 当 :逃逸时间呈对数增长 。
- 当 :逃逸时间呈幂律增长 。
这意味着,增加网络的总深度不一定会显著延长平台期,除非你同时减小了更多层的初始化尺度。 这一结论挑战了“更深的网络必然更难优化”的直觉,转而强调了“瓶颈层”决定速度的本质。
4. 实验验证:跨激活函数的普适性
理论不仅给出了幂律指数,还通过一个常数 建立了一个“万能曲线”。 作者测试了 Tanh, Erf, Sin, GELU, Swish 等多种激活函数,发现只要根据 进行对齐,所有模型的逃逸轨迹都会坍缩到同一条主曲线上(图 3)。
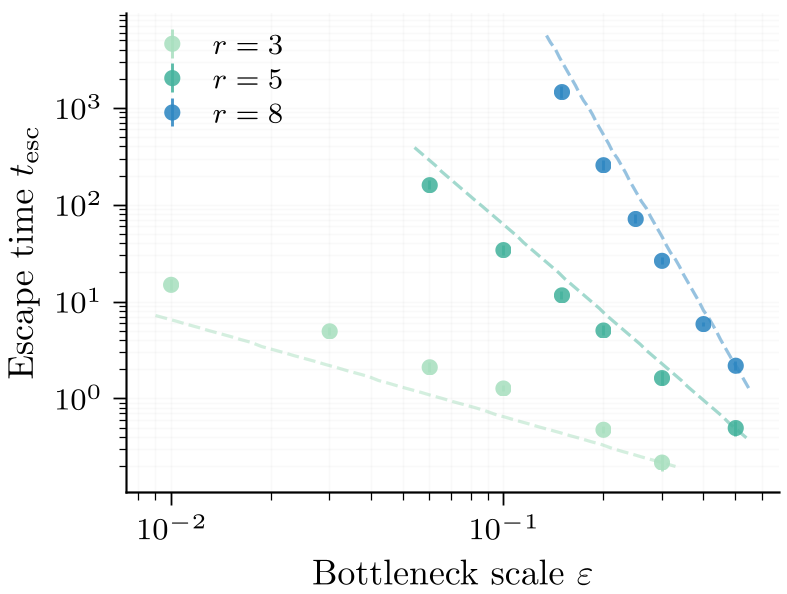 图 2:非流形下的临界深度指数。即使在 He-normal 初始化下(随机性极强),逃逸时间的斜率依然严格遵循理论预测的 。
5. 深度洞察与总结
关键启示 (Takeaways):
- 瓶颈决定速度:如果你想让模型学习更快,检查那些梯度流过的“窄路”(瓶颈层)比盲目调整全局深度更有效。
- 结构化初始化:本文的理论暗示,我们可以通过非对称的初始化层尺度来操纵特征学习的顺序。
局限性:
该理论目前主要针对单模式(Single-mode)教师模型,即处理单一方向产生的特征。在处理复杂的多模态数据时,不同特征之间的耦合(如多模态干扰)会引发更复杂的“结构不稳定”现象,这需要进一步研究。
总的来说,这篇论文通过严谨的数学推导,成功地为一个长期困扰研究者的非线性动态现象找到了简洁的解释范式,是深度学习理论领域的一项重要突破。