
DeScore:先思考后评分,突破视频生成奖励模型的训练瓶颈
Think, then Score: Decoupled Reasoning and Scoring for Video Reward Modeling
本文提出了 DeScore,一种采用“先思考,后评分”(Think-then-Score)解耦架构的视频奖励模型。该方法通过将 Chain-of-Thought (CoT) 推理与判别式评分模块分离,在保持生成式模型高泛化性的同时,解决了传统模型在强化学习阶段训练不稳定的痛点,在多个 OOD 基准测试中达到 SOTA。
TL;DR
在视频生成领域,如何精准评价一段视频的好坏是提升模型质量的核心。最新的研究 DeScore 提出了一种“解耦推理与评分”的全新范式。它让模型先进行详细的 Chain-of-Thought (CoT) 逻辑分析,再通过一个独立的鉴别器给视频打分。通过这种“先想后做”的设计,DeScore 不仅在泛化能力上大幅领先,还解决了大模型强化学习(RL)中普遍存在的训练不稳定问题。
背景:奖励模型的“生成”与“判别”之争
在视频奖励模型(Video Reward Modeling)领域,一直存在两派路线:
- 判别式 (Discriminative):直接对视频特征进行回归得出分数。优点是训练稳健,缺点是像“黑盒”,容易学到伪相关性(Shortcut Learning)。
- 生成式 (Generative):让模型一边解释视频好在哪里,一边吐出分数 token。优点是泛化性强,有解释性;缺点是推理逻辑和最终分数值耦合在一起,导致 RL 训练时梯度方差极大,极不稳定。
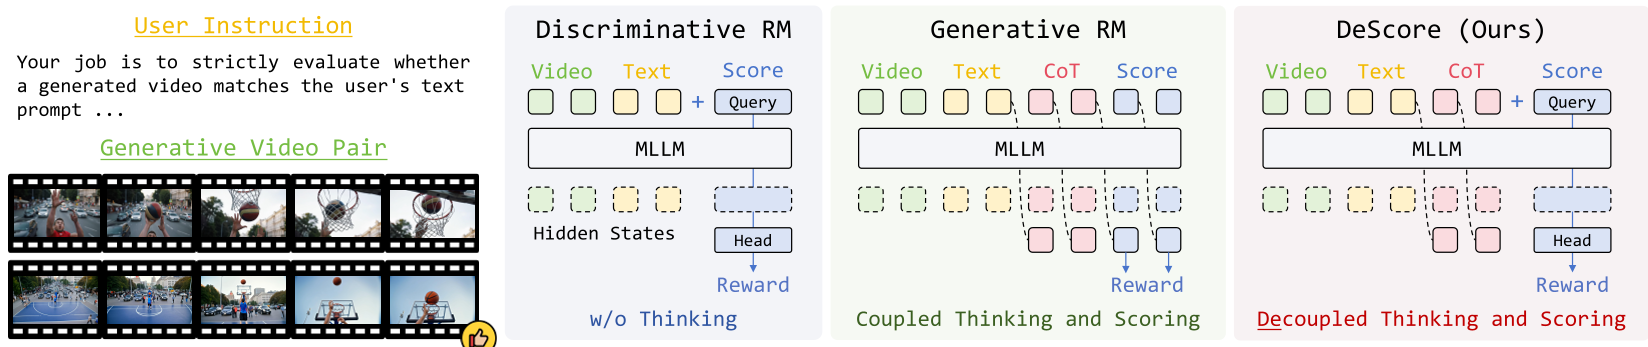
核心动机:解决耦合困境
作者指出,现有的生成式模型在 RL 阶段(如使用 GRPO 算法)会遇到**信用分配(Credit Assignment)**难题:如果最终分数给低了,是因为前面的推理逻辑错了,还是最后的打分 token 没写好?这种耦合导致梯度方差随着序列长度 呈指数级或线性增长(),让模型收敛变得异常困难。
Methodology:解耦的“Think-then-Score”范式
DeScore 的精妙之处在于将 Qwen3-VL 作为主干,但打破了它原有的自回归打分逻辑:
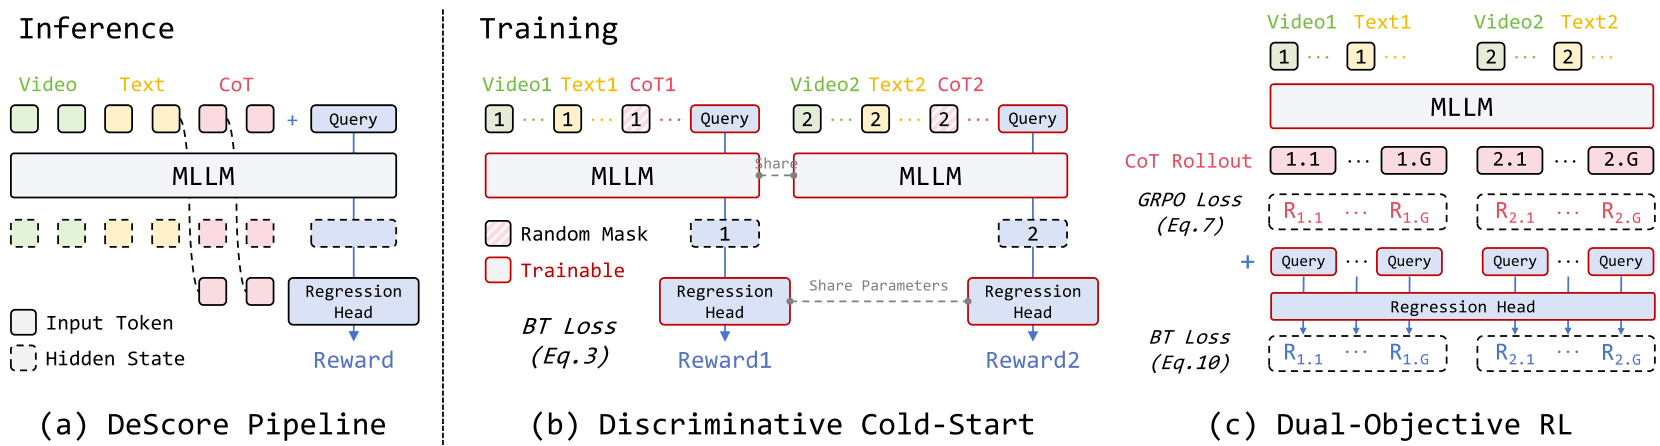
- 解耦架构:模型先产生一段文本推理(CoT),随后在序列末尾插入一个特殊的
[Reward]标记。这个标记的 Hidden State 会被输入到一个专门的回归头(Regression Head)中产出标量分数。 - 两阶段训练:
- 阶段 1:判别式冷启动。引入 Random Masking 机制。训练时以一定概率随机遮盖 CoT 文本,强迫模型不能只看文字解释,还得看原始视频特征,从而确保模型在推理跑偏时依然能给出合理的奖励。
- 阶段 2:双目标强化学习。使用 GRPO 优化推理质量,同时利用 Bradley-Terry (BT) Loss 直接校准评分模块。这种“双规制”优化确保了推理的提升能直接转化为评分的精准度。
实验与结果:用更少的数据,刷更高的榜
实验结果证明,DeScore 在处理分布外(OOD)视频时展现了惊人的韧性。
1. 卓越的泛化表现
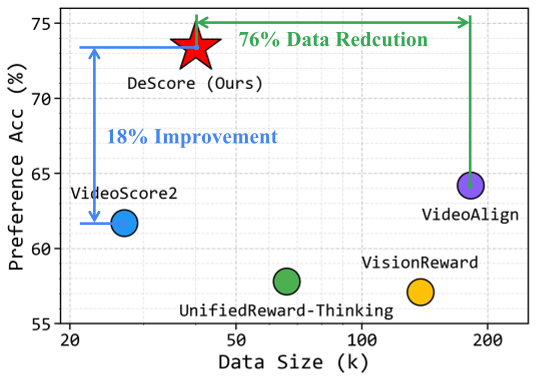
在 VideoGen-Bench 这一当前最难的视频基准测试中,DeScore 相比于之前的 SOTA 判别式模型 VideoAlign 提升了近 4.6%,相比于生成式模型 UnifiedReward-Thinking 则有着跨代级的领先(0.768 对比 0.582)。
2. 极高的训练效率
如下图所示,DeScore 表现出了极佳的“数据功价比”。在仅使用约 24% 的训练数据时,其性能就已经超越了全量数据训练的其他模型。
3. 可视化分析
通过注意力图观察可以发现,加入了 Random Masking 后,[Reward] token 不再仅仅关注 CoT 文本,而是将注意力均匀分配到了视频帧和文本指令上,这解释了其强大的鲁棒性。
深度洞察
DeScore 的成功揭示了一个重要的技术方向:逻辑推理(Reasoning)可以作为特征提取的“催化剂”,但不应直接作为决策的“输出口”。在视频这种信息密度极高的数据模态下,直接将预测值与自回归序列分离,不仅平衡了可解释性与稳健性,也为未来多模态奖励模型的缩放(Scaling)提供了更高效的工程方案。
结论
DeScore 通过解耦设计,不仅在学术榜单上取得了优异成绩,更在实际的视频生成模型(如 Wan-2.1)后训练中证明了其价值。尽管它在检测微小视觉伪影(Artifacts)方面仍有提升空间,但其“先思考后评分”的逻辑无疑为下一代视频大模型的对齐算法指明了方向。