
TIDE:让每一层 Transformer 重新认识“你”是谁
TIDE: Every Layer Knows the Token Beneath the Context
本文提出了 TIDE (Token Identity Delivered Everywhere),这是一种针对标准 Transformer 架构的改进方案。通过引入多路径 EmbeddingMemory 机制,TIDE 将 Token 原始身份信息在每一层进行重新注入,在 350M 至 3B 参数规模下,显著提升了语言建模的 Perplexity 并增强了罕见 Token 的表征能力。
TL;DR
在现代大语言模型(LLM)的各种变体中,有一个被长期忽视的设计惯例:Token 的身份 ID 在输入层变成向量(Embedding)后,就再也没有直接露出过。苹果公司的研究团队通过新论文证明,这种“单次注入”是模型认知能力的瓶颈。他们提出的 TIDE (Token Identity Delivered Everywhere) 架构,通过在每一层重新注入 Token 身份信号,成功解决了罕见词训练不足和深层语义塌陷的顽疾。
痛点深挖:消失的身份与失效的表征
作者指出,目前的 Transformer 架构存在两个隐形的致命伤:
- 梯度饥饿 (Gradient Starvation):受 Zipf 定律影响,1% 的高频词占据了 80% 的语料。低频词(罕见实体、术语)能分到的梯度更新极少。如图 1 所示,罕见词的向量模长在训练过程中甚至会趋向噪声。
- 上下文塌陷 (Contextual Collapse):当两个语义不同但语法功能相似的词(如 "their" 和 "there",或者特定的年份数字)出现在相似上下文中时,深层网络的 FFN 模块受 Lipschitz 连续性限制,很难强行拉开这两个 hidden states 的距离,导致模型产生“老花眼”。
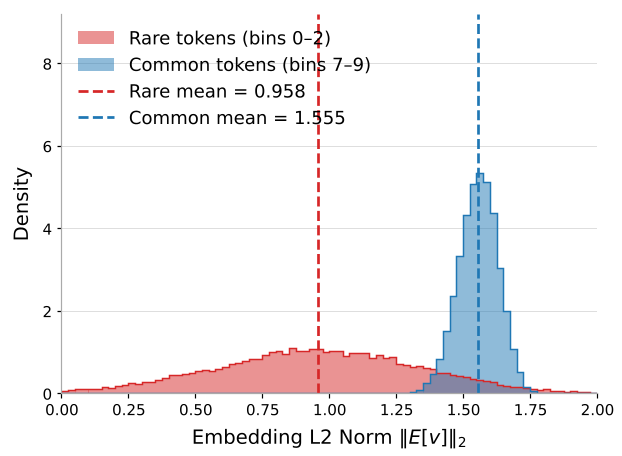 图 1:(a) 向量模长随词频增加而递增;(b) 罕见词分布呈噪声状;(c) 随训练进行,罕见词的更新率持续走低。
Methodology:TIDE 的“多路径存储”机制
针对上述问题,TIDE 在标准 Transformer 层旁边架设了一条专门的“高速通道”——EmbeddingMemory。
核心组件:
- MemoryBlocks (K个):独立的不共享参数的嵌入表,负责捕捉 token 的静态语义。
- 深度条件路由 (Depth-conditioned Router):每一层有一个轻量级的线性分类器,决定这一层该从哪个 MemoryBlock 取经,或者选择“NULL bank”(即不引入额外信息,保持标准架构行为)。
- 加性融合:计算出的身份向量直接加进残差流(Residual Stream)。
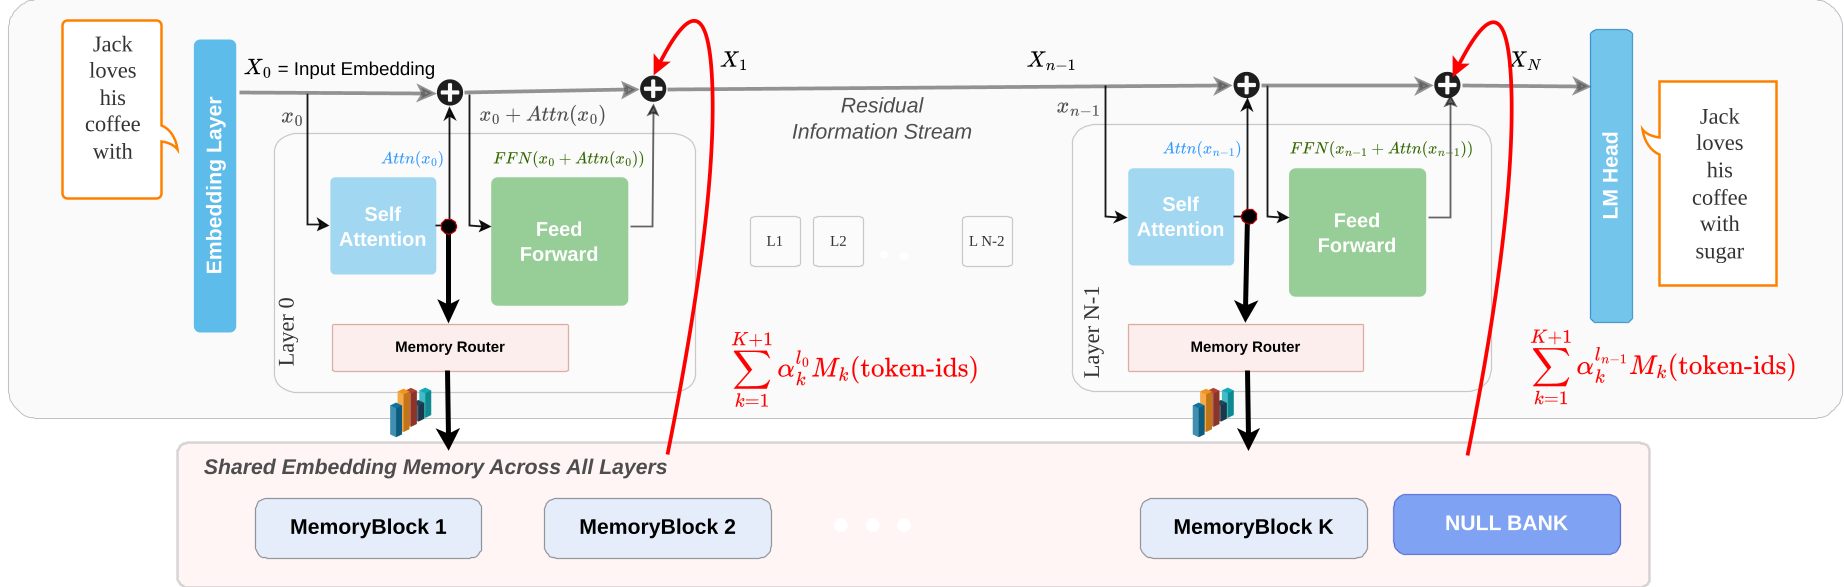 图 3:TIDE 架构概览。红框部分为全新的 EmbeddingMemory 模块,它与 Context-based 残差流并行。
为什么这能解决塌陷? 数学证明(Proposition 3.3)显示,由于 MemoryBlock 是直接通过离散 Index 寻址的,它不依赖于上一层的 hidden state。即使上下文完全相同导致 距离极小,TIDE 也能强行注入一个区分度极高的 向量。
实验与结果:罕见词的降维打击
TIDE 在不同规模的模型上展示了单调递增的性能提升:
- 各领域全面领先:在 Wikitext、PubMed 和 DCLM 上,TIDE (K=2 到 24) 的 Perplexity 曲线显著低于 Llama-Base。
- 罕见词获益最大:如图 5 所示,TIDE 的增益主要集中在词频最低的 10% 区域,这印证了 K 路径梯度放大(K-Pathway Gradient Amplification)的有效性。
- 下游任务:在 HellaSwag、ARC 等 Zero-shot 测试中,1B 模型的平均准确率从 61.4% 提升至 63.7%。
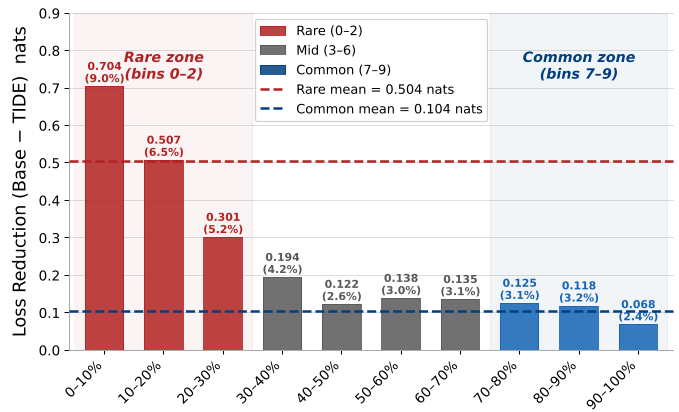 图 5:TIDE 在罕见分箱(Rare tokens)中的损失下降最为剧烈。
推理开销优化
虽然增加了嵌入表,但作者提出这些静态表可以在训练后进行 4-bit 量化 甚至 SVD 低秩压缩(如图 12),并存储在 SSD 中进行异步预取。这使得 VRAM 占用平稳,同时解码速度仅下降约 10-20ms/token,在可接受范围内。
深度洞察:NULL Bank 的奥秘
有趣的是,研究发现路由器的 NULL bank 分配率与词频成正比(图 10):对于高频词,模型更倾向于关闭 TIDE(因为原本的 Embedding 已经够用了);而对于罕见词,路由器会“大开闸门”,充分利用 MemoryBlock 的信息。
总结与局限
TIDE 的贡献在于挑战并修复了 LLM 对 Token 身份“阅后即焚”的短视行为。它通过简单的加性结构,补齐了模型在处理复杂实体和低频知识时的短板。
局限性:尽管可以量化,但 K 增大导致的硬盘占用仍随词表线性增长。此外,该方法在 RLHF 阶段是否能保持同等增益,仍需后续工程验证。
本文由资深学术技术主编基于 arXiv 2026 最新论文重构。