
拓扑增强对齐:利用持久同调重塑 LLM 的隐藏空间轨迹
Topology-Enhanced Alignment for Large Language Models: Trajectory Topology Loss and Topological Preference Optimization
本文提出了一个拓扑增强的 LLM 对齐框架,引入了轨迹拓扑损失 (TTL) 和拓扑偏好优化 (TPO),通过 0 维持久同调 (Persistent Homology) 约束隐藏空间中的语义轨迹。在 Qwen2.5-7B 和 Llama-3-8B 上的实验表明,该方法在 UltraChat 和 HH-RLHF 数据集上显著提升了奖励模型 (RM) 分数和胜率(Win-rate +3-4%)。
TL;DR
大模型对齐不仅是概率的竞争,更是隐藏空间中语义轨迹的塑造。本文提出了一套基于拓扑数据分析(TDA)的对齐框架,通过 0 维持久同调 (0D Persistent Homology) 提取表征间的“拓扑桥”,显式约束模型从输入到输出的演化路径,在不改变架构的前提下显著提升了 Qwen2.5 和 Llama-3 的指令遵循与安全表现。
1. 痛点深挖:被遗忘的“表征几何”
当前的对齐技术(SFT, DPO, RLHF)本质上是在概率空间中“拉拽” Token 分布。然而,隐藏层的表示空间实际上是一个高维流形。现有的对齐目标往往只关注结果(这个 Token 概率大不大?),而忽略了过程(模型是如何从 Prompt 的状态演变到 Answer 状态的?)。
作者认为,生成过程本质上是隐藏空间中的一条语义轨迹 (Semantic Trajectory)。如果缺乏对轨迹的几何约束,模型的对齐行为可能缺乏鲁棒性,甚至在微扰下产生偏离人类偏好的表达。
2. 核心机制:拓扑桥与语义对齐
为了捕捉隐藏空间的全局结构,作者引入了拓扑学中的核心概念——持久同调。
2.1 SFT 阶段:轨迹拓扑损失 (TTL)
在 SFT 微调中,TTL 将一个 Batch 内的 Prompt 嵌入和 Gold Answer 嵌入视为混合点云。
- 提取拓扑桥:利用 Union-Find 算法寻找连接 Prompt 簇和 Answer 簇的“死亡边”(Death Edges)。这些边构成了连接两者的骨干。
- 逻辑直觉:通过余弦相似度,强制要求模型生成的实际轨迹()与这些由全局几何结构定义的“拓扑桥”方向一致。
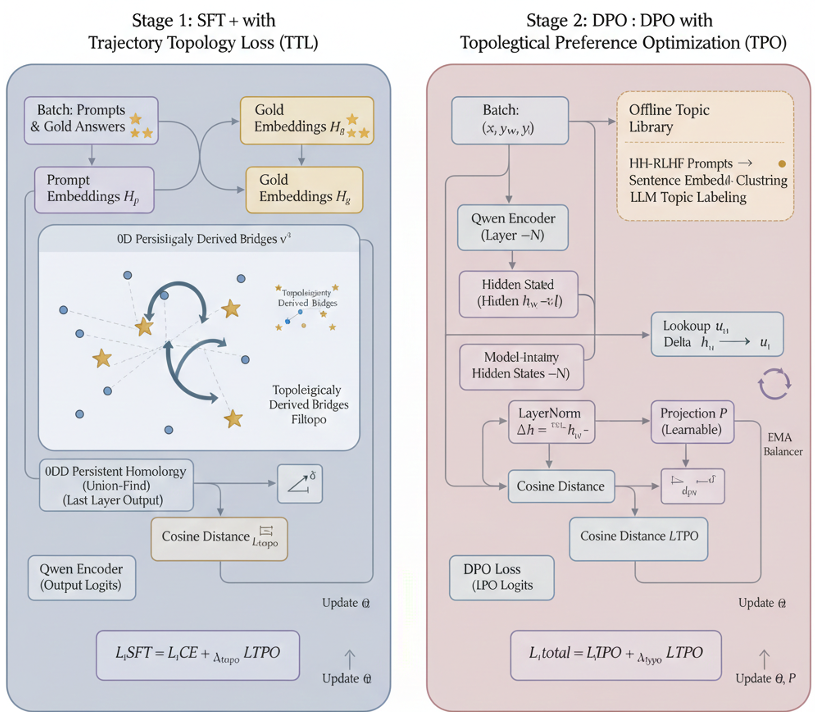 图 1:框架概览,左侧为 SFT 阶段的 TTL 机制,右侧为 DPO 阶段的 TPO 机制
2.2 DPO 阶段:拓扑偏好优化 (TPO)
在偏好学习阶段,单纯的标量奖励不足以指导模型改进方向。
- 话题敏感偏好:作者离线构建了一个话题库,为不同任务(如代码编写、医疗咨询)定义专题偏好向量。
- 改进方向对齐:TPO 约束模型,使其从“Rejected”到“Chosen”的向量差 与预定义的专题偏好方向对齐。
3. 实验战绩与 SOTA 对比
研究团队在 Qwen2.5-7B 和 Llama-3-8B 上进行了广泛验证。
- 性能跃升:在 UltraChat 任务中,TTL 将 RM 分数从 64.2 提升至 67.8,且在 IFEval(指令遵循)上表现优异。
- 更优的权衡:在 HH-RLHF 安全数据集中,TPO 不仅提升了胜率,还显著降低了毒性(Toxicity),实现了更好的 Helpful/Harmless 平衡。
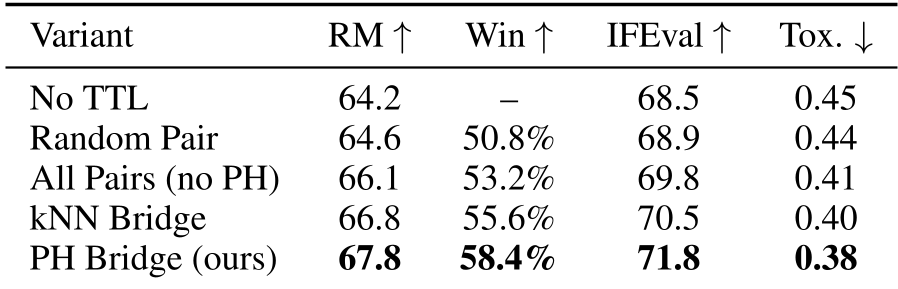 表 6:消融实验显示,相比随机对齐或简单的 kNN 邻居,拓扑桥(PH Bridge)能提供最稳定的正则化信号。
4. 深度洞察:为什么拓扑信息有效?
- 超越局部性:传统的 kNN 仅关注最近的邻居,而 0D 持久同调本质上构建了一个最小生成森林 (Minimum Spanning Forest)。它捕捉的是点云的全局骨架,能滤除局部噪声。
- 跨层一致性:实验发现,在模型的中间层(倒数第 2 至第 4 层)施加 TPO 效果最佳。这表明该层是语义改进最为集中的“加工区”。
- 低成本高回报:虽然涉及矩阵运算,但在对齐常用的 Micro-batch 下,计算开销可忽略不计(仅增加约 5% 的训练时长)。
5. 局限性与未来展望
目前该研究仅局限于 0 维拓扑(联通性)。在高维拓扑中,可能存在表示洞(Loops 或 Cavities),它们可能对应着模型对歧义问题的模糊表征。未来的研究若能引入更高维的 Betti 数或持久景观 (Persistence Landscapes),或许能进一步揭示 LLM 在复杂推理中的逻辑坍塌问题。
总结: 本文为 LLM 对齐开启了一个迷人的方向——将代数拓扑的严谨性与深度学习的表征能力相结合。在大模型日益追求极致性能的今天,从几何视角进行“精细手术”可能是解决幻觉与对齐漂移的关键。