
LENSEs:更平滑的表示,更完美的分子——突破 3D 分子生成的表示瓶颈
Toward Better Geometric Representations for Molecule Generative Models
本文提出了 LENSEs 框架,针对 3D 分子生成任务,通过优化预训练分子编码器的几何表示空间,实现了更平滑且语义丰富的生成条件。在 GEOM-DRUG 数据集上,该方法取得了 97.28% 的有效性和 98.51% 的稳定性,达到了 SOTA 水平。
TL;DR
在 AI 制药领域,直接生成稳定且符合物理规律的 3D 分子结构一直是核心挑战。本文提出了 LENSEs 框架,通过对预训练编码器的“表示空间”进行手术级精炼,解决了分子表示不平滑、层次化语义丢失等顽疾,在 GEOM-DRUG 数据集上刷新了 SOTA 记录,显著提升了分子生成的有效性和物理真实性。
痛点深挖:预训练编码器的“水土不服”
目前的分子生成主流范式(如 GeoRCG)采用两步走:先采样一个分子向量(Representation),再根据向量生成 3D 结构。然而,作者发现这种方法存在两大短板:
- 表示空间不平滑:预训练编码器(如 UniMol)生成的潜在空间 Lipschitz 常数极高。这意味着坐标的微小扰动会导致潜在向量的剧烈波动(Non-smooth Manifold),让扩散模型采样时极其痛苦。
- 语义利用率低:编码器中浅层提取的局部基团(如氨基、羟基)和深层提取的全局结构往往只有最后一遍被用作条件。生成器不得不“从头学习”这些本已存在的化学常识。
方法论详解:三位一体的潜在增强 (LENSEs)
LENSEs 并非简单地冻结编码器,而是通过三个核心模块对表示空间进行“活化”:
1. 变分表示头 (Representation Head)
作者引入了可学习的层级池化(Learnable Layer Pooling),将编码器 0-8 层的不同特征按权重融合。通过 KL 散度 正则化,强制潜在空间符合标准高斯分布,从而将 Lipschitz 常数降低了 4.6 倍。
2. 分子感知损失 (L_PERC)
借鉴 CV 领域的 Perceptual Loss,作者将生成的分子重新喂回编码器,要求生成分子的“特征向量”在语义上接近真实分子,而不仅仅是坐标对齐。
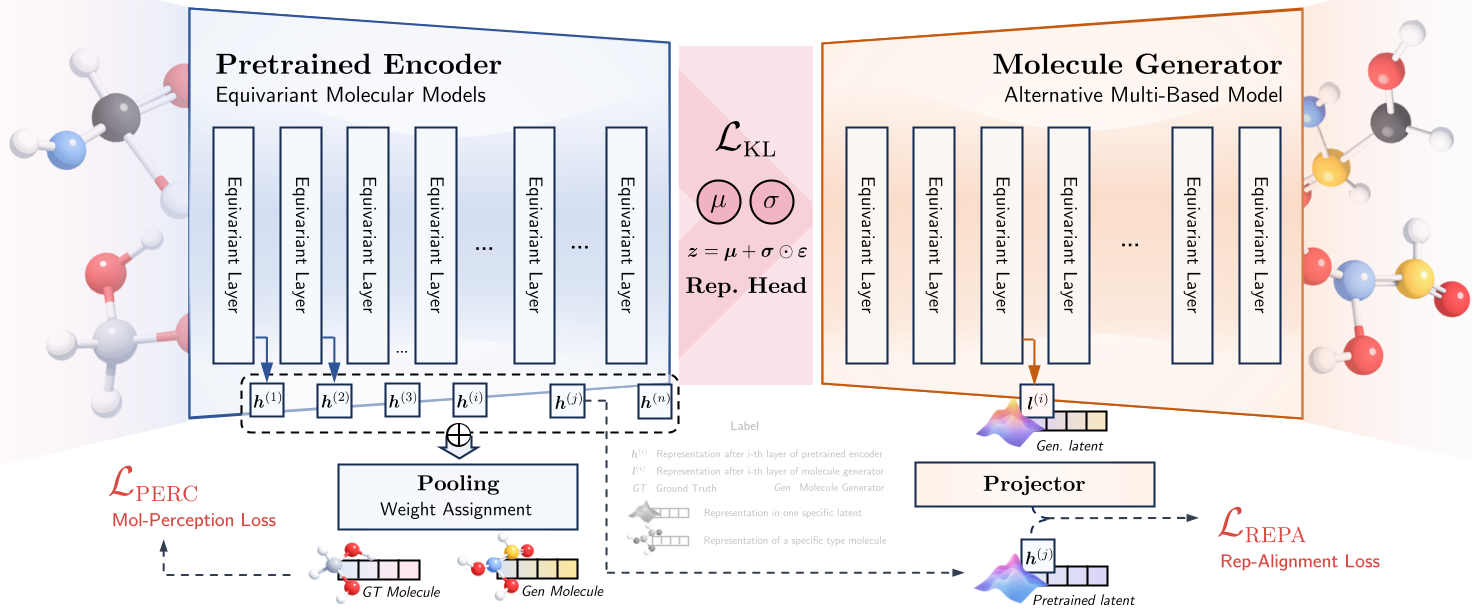
3. 表示对齐 (REPA)
通过一个 Projector,将生成器的内部隐藏状态与编码器的节点特征进行强行对齐。这像是在生成训练中加入了一个“导师”,让生成器实时参考编码器的知识,大大加速了收敛。
实验结果:全方位的跨越
1. 物理真实性的飞跃
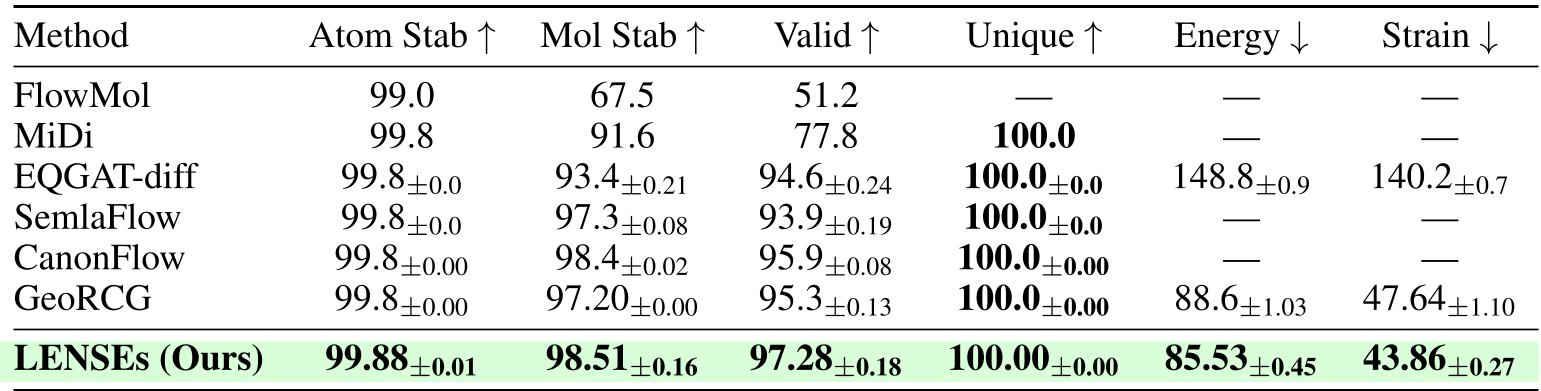
在 GEOM-DRUG 数据集上,LENSEs 的 Validity (有效性) 达到 97.28%,Molecule Stability (分子稳定性) 达到 98.51%。更重要的是,生成分子的能量(Energy)和应变(Strain)显著低于此前的模型。
2. 采样效率的代差优势
实验显示,LENSEs 展现出极强的 Few-step 生成能力。在仅使用 20 步 采样时,其生成的分子质量就已经超过了基线模型(SemlaFlow)运行 100 步 的效果。这意味着在实际推理应用中,LENSEs 能节省数倍的算力。
深度洞察:生成即是预训练
本文最具启发性的发现之一是:生成任务可以反哺编码器。 作者将 LENSEs 优化后的表示用于下游的 QM9 属性预测任务,发现其回归性能竟然优于原始的 UniMol/Frad 编码器。这证明了:
- 生成任务要求模型对分子结构有极高的“全局掌控力”。
- 带有对齐目标的生成训练,其本质上是一种极高质量的精调(Fine-tuning)过程。
总结与局限性
LENSEs 成功证明了:生成的质量上限,取决于表示空间的“平滑度”与“语义密度”。
局限性:虽然表现出众,但 LENSEs 在训练过程中需要额外的 forward hooks 来提取多层特征,这会增加约 1.0GB 的显存占用。此外,如何在超大规模库(如千万级分子)上保持这种对齐的高效性,仍是未来值得探索的方向。
Takeaway: 下一代分子基础模型,或许不应再区分布局属性预测与生成,两者在优质表示空间的指引下,正在加速合流。