
追踪时间之箭:诊断与修复 Video-LLM 的时间信息流瓶颈
Tracing the Arrow of Time: Diagnosing Temporal Information Flow in Video-LLMs
本文提出了名为 TAT-VQA 的诊断性研究,旨在解决 Video-LLM 在“时间之箭”(Arrow-of-Time, AoT)任务上表现疲软的问题。作者通过对比实验发现,显式建模时间的视频中心编码器(Video-centric encoder)能有效编码时间信号,但目前的架构在投影层(Projector)和语言对齐阶段存在严重的信息流瓶颈。
TL;DR
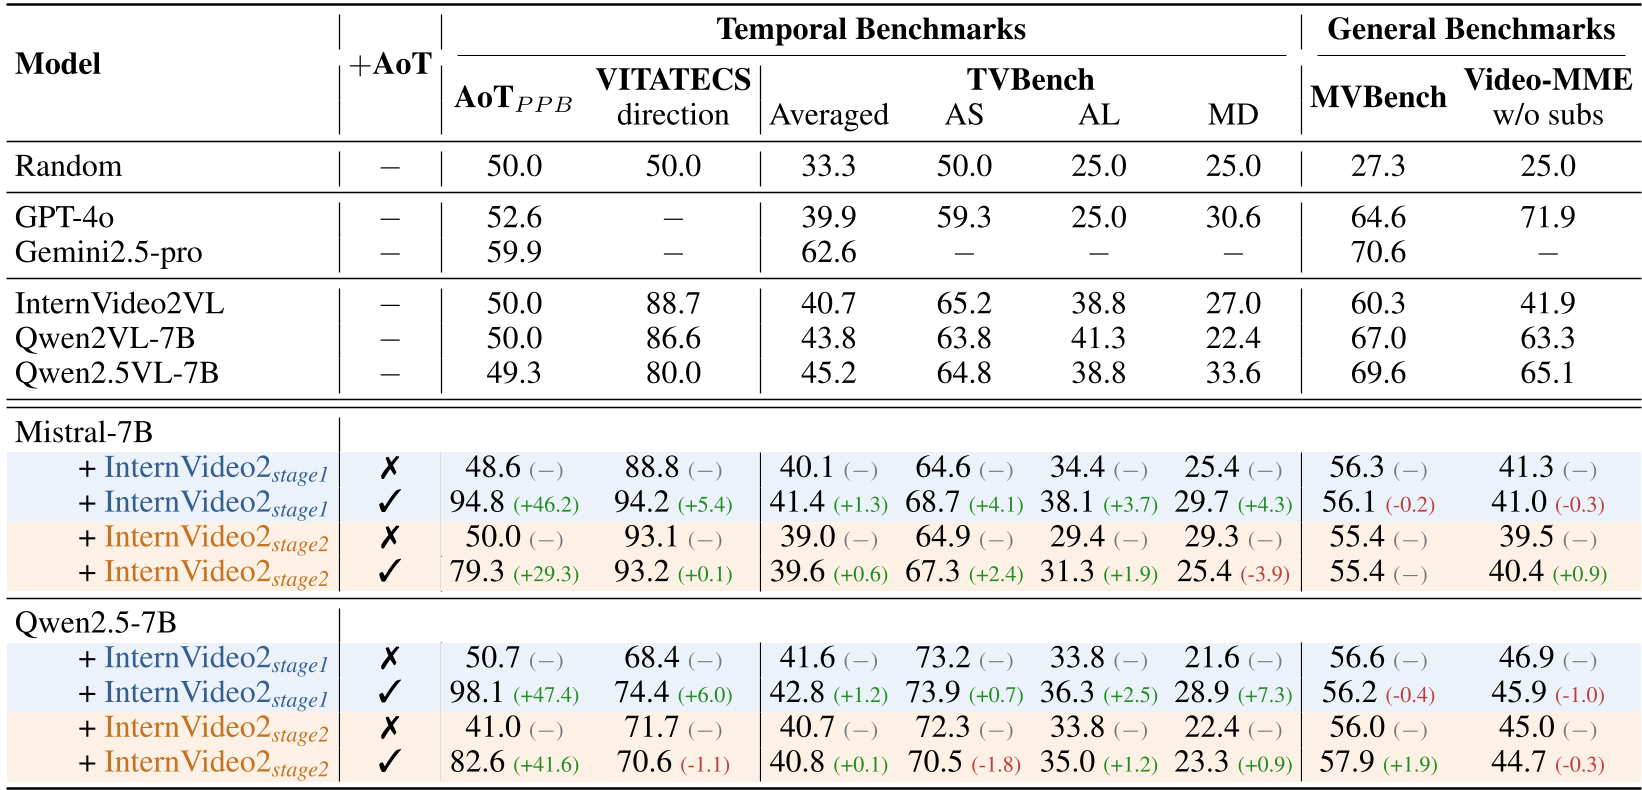
为什么最先进的视频大模型(Video-LLM)连简单的“正放还是倒放”都分不清?本文深入分析了 Video-LLM 的架构瓶颈,发现问题不在于模型不够大,而在于 时间信息在传输中被“弄丢”了。通过更换视频中心编码器与时间保留型投影层,研究人员将模型的 AoT 准确率从随机水平提升到了 98.1%,一举超越人类表现。
1. 痛点:被遗忘的“时间感知”
在视频理解领域,时间维度是区别于图像处理的核心。然而,目前的 SOTA 模型(如 GPT-4o、Qwen2-VL)在处理 时间之箭(Arrow-of-Time, AoT) 任务时表现极其糟糕。
- 什么是 AoT? 即给定一段视频,判断它是正常播放还是倒序播放。
- 为什么难? 这要求模型理解重力、熵减、因果逻辑等物理规律。
- 现状: 即使是 InternVideo2 这样强大的模型,其在该任务上的表现也仅仅徘徊在 50% 左右(随机猜)。
2. 溯源:时间信号在哪里丢失了?
作者通过一层层的“主动探针(Probing)”实验,定位了三个核心瓶颈:
2.1 编码器缺陷 (Encoder Level)
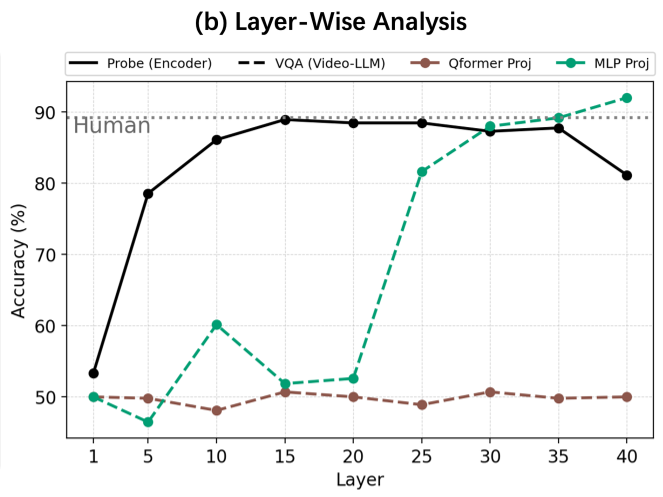
传统的 帧中心编码器(Frame-centric) 只是把视频当成一堆图片的集合。实验显示,这类编码器生成的特征完全不具备区分正倒放的能力。相比之下,视频中心编码器(Video-centric) 由于引入了 3D 卷积或时间 Attention,初步具备了编码时间特征的能力。
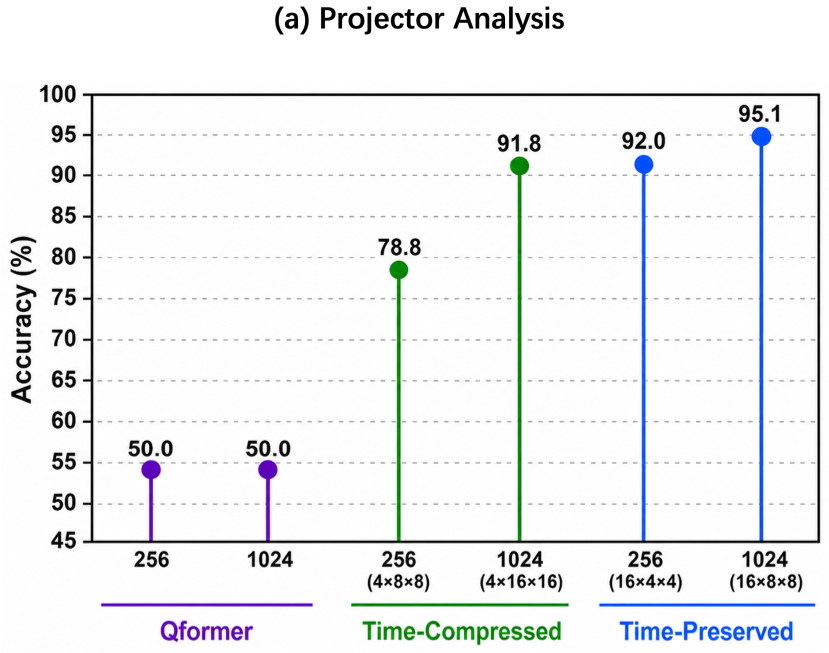
2.2 投影器瓶颈 (Projector Level) —— 最关键的发现
很多 Video-LLM 使用 Q-Former 结构来压缩视觉 token,以节省 LLM 的计算量。
- 发现: Q-Former 会彻底打乱时间顺序,导致即便编码器提取了信号,LLM 也接收不到。
- 物理直觉: 将 Q-Former 比作一个过滤器,它在压缩时把“先后顺序”这一维度给过滤掉了。
2.3 对齐陷阱 (Alignment Level)
研究发现,CLIP 风格的对比语言对齐(Stage 2) 实际上会削弱时间感。因为当前的文本说明通常只关注静态语义(“一个人在喝水”),而不关心动态过程,这导致模型在对齐过程中“牺牲”了对时间敏感的底层特征。
3. 解决方案:重建时间通道
为了修复上述问题,作者提出了三项关键改进:
- 采用 V-JEPA 或 InternVideo2-Stage1 为 Backbones:保留强大的原始时间感知力。
- 时间保留型 MLP(Time-preserved MLP):
- 策略:放弃会导致时序错乱的 Q-Former。
- 操作:保留时间维度的全部 T 个 token,仅对空间分辨率进行下采样。
- AoT 监督指令微调:通过百万量级的 AoT 问答数据,强迫模型从物理动力学角度去思考问题。
4. 实验结果:超越人类
在 AoTP 基准测试中,优化后的模型(Qwen2.5-7B + TAT 框架)表现惊人:
- 准确率:从 50% 暴涨至 98.1%。
- 人类对比:人类的平均水平为 89.2%,模型实现了实质性的反超。
- 泛化能力:这种对时间的“开悟”直接带动了其他时序任务的提升。在 TVBench 上的 Action Sequence (动作排序) 任务中,表现显著增强。
5. 深度洞察与总结
- 核心启示:不要盲目追求视觉 token 的极高压缩率。对于涉及动作、流程、物理逻辑的视频理解,时序结构的保真度高于语义压缩的效率。
- 局限性:由于计算资源限制,该模型目前仅使用 16 帧输入。对于需要更长时间跨度(如几分钟的剧情分析)的推理,稀疏采样可能会丢失关键瞬时证据。
- 未来展望:这项研究为构建具有“物理常识”的视频模型指明了方向。未来,像 AoT 这样能够提供天然方向性的训练信号,或许应该成为所有 Video-LLM 的标配预训练任务。
结论: 时间之箭不仅是物理学的基本命题,也是 AI 真正踏入现实动力学世界的门票。通过 TAT-VQA,我们第一次看清了模型在时序认知上的“漏水点”,并给出了最直接的封堵方案。