
TrafficClaw:基于统一物理建模,打造可进化的“城市交通大脑”
TrafficClaw: Generalizable Urban Traffic Control via Unified Physical Environment Modeling
本文提出了 TrafficClaw,这是一个专为通用城市交通控制设计的 LLM Agent 框架。通过构建统一的物理运行环境,该框架实现了交通信号、高速公路、公共交通和出租车服务等异构子系统的集成建模,在 Llama-3-8B 基础上通过强化学习达到了超越 Gemini-3.1-Pro 和 o4-mini 等大型模型的 SOTA 性能。
TL;DR
在城市交通这个精密的仪器中,信号灯的调节、公交的排班、高速口的启闭并非独立存在。本文介绍的 TrafficClaw 突破了传统单一任务控制的局限,首次将异构交通子系统放进同一个“物理运行时环境”进行协同建模。凭借 LLM 的代码执行能力、程序化时空记忆以及系统级强化学习,TrafficClaw 在仅 8B 的参数量下,展现出了超越闭源大模型的全网调度能力。
1. 痛点:被孤立的“交通孤岛”
长期以来,交通控制领域的研究被割裂在不同的子系统中:
- 信号灯控制 (TSC) 关注路口吞吐量。
- 公交调度 (Bus Scheduling) 关注乘客等待时间和运营成本。
- 高速匝道控制 (Ramp Metering) 关注主线车速。
这种任务孤立 (Task-Isolation) 带来了一个致命问题:在一个共享物理设施的城市中,公交班次的增加会直接改变路口的排队分布,而高速口的限流会把压力传导至地面道路。现有的 RL 方法往往通过繁琐的 Reward Engineering 来强行适配,但换一个城市(泛化性差)或换一种任务组合(灵活性差)就彻底失效。
2. 核心架构:像人类专家一样思考与记忆
TrafficClaw 的核心在于它不再只是一个“分类器”,而是一个拥有手、脑和记忆的 Runtime Agent。
2.1 统一物理环境 (Unified Physical Environment)
作者构建了一个集成了 20 种静态数据、98 种动态特征和 15 个可直接调用的执行 API 的环境。它模拟了真实的出行需求(基于重力模型和家庭出行调查),确保不同交通方式在同一个物理层面上竞争和补给。
2.2 可执行时空推理 (Executable Reasoning)
不同于传统的特征编码,TrafficClaw 通过生成 Python 代码 来分析数据。
- 空间分析 (Φspace):捕捉路网拓扑。
- 反馈闭环:生成的动作会先进行“模拟演练”,通过实时反馈修正策略。
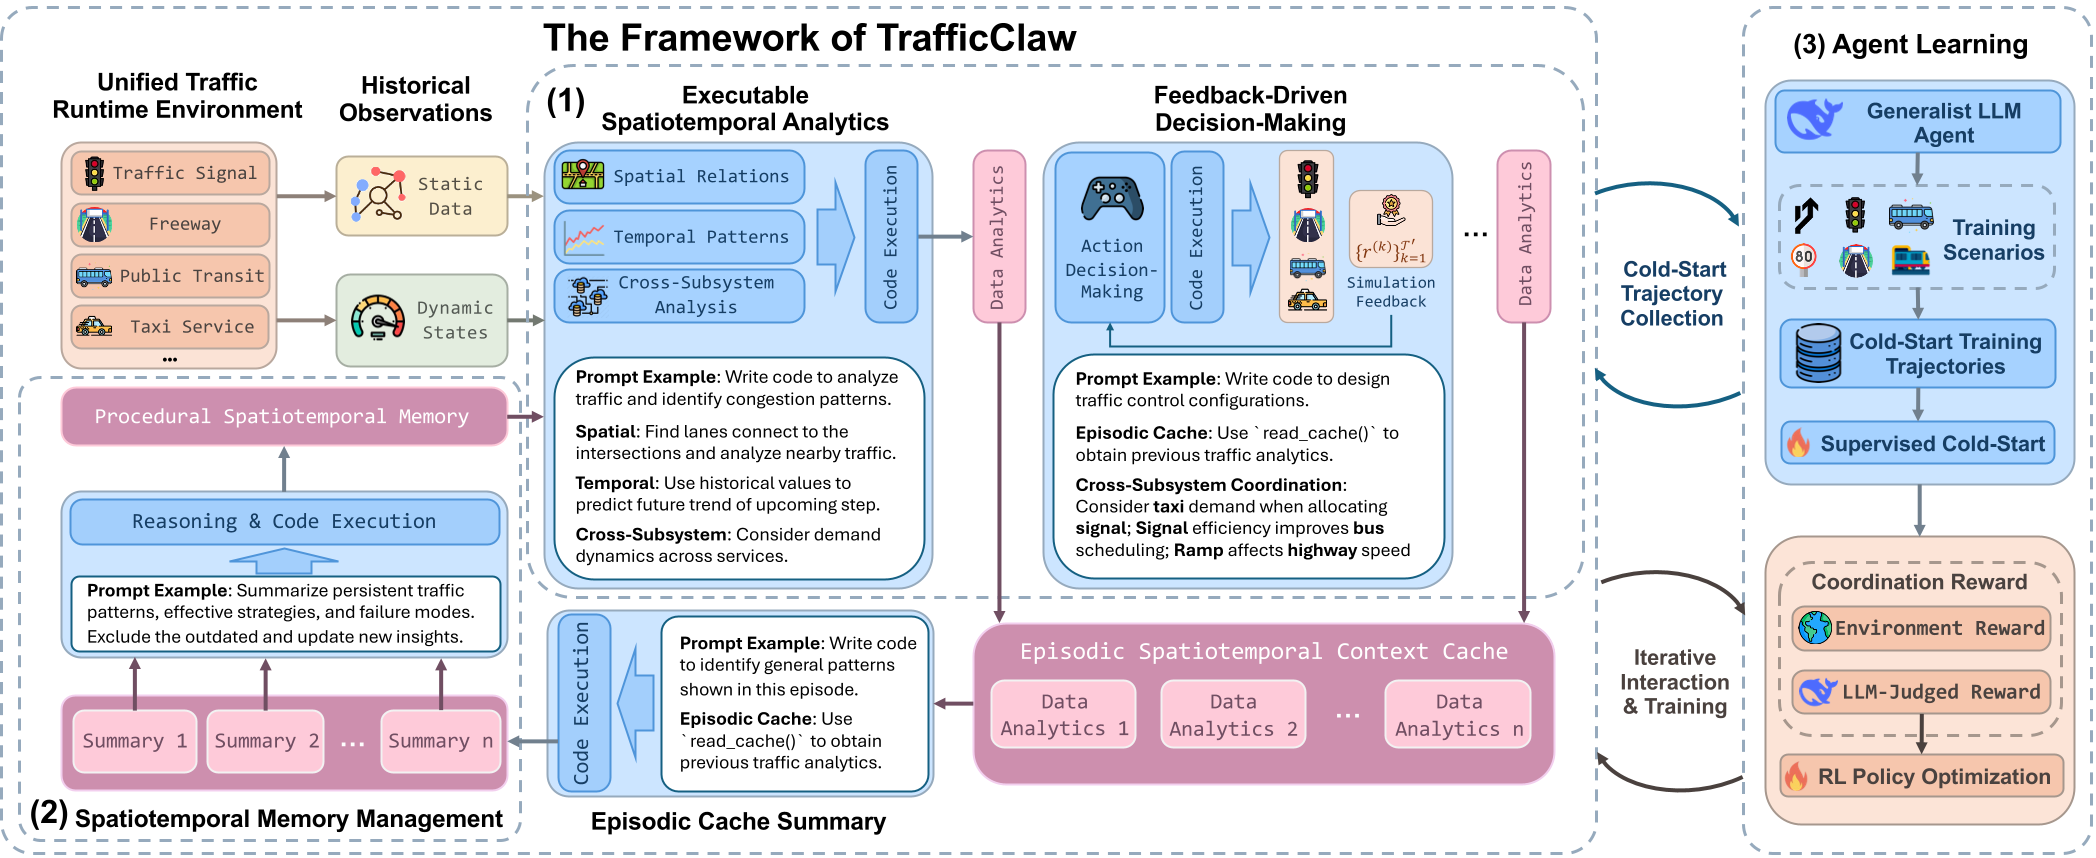 图 1: TrafficClaw 框架总览,展示了感知-分析-执行-反馈的闭环
2.3 时空记忆管理 (ST-Memory)
这是 TrafficClaw 能够“自进化”的关键。
- ESCC (情景缓存):在单次任务中存储中间分析结果,避免重复计算。
- PSM (程序化记忆):跨 Episode 沉淀知识(如:早高峰期间信号灯与公交排班的耦合规律)。通过“失败案例”和“成功模式”的自省,Agent 能在未见过的任务(如地铁调度)中快速迁移经验。
3. 实验战绩:以小博大的通用性
实验在纽约(曼哈顿与皇后区)进行,涵盖了 5 种在域和离域任务。
3.1 性能跨越
即便使用 Qwen3-8B 作为底座,TrafficClaw 的表现也显著优于专门设计的 TrafficGPT,并在多项指标上追平甚至超越了 o4-mini 和 Gemini-3.1-Pro。在 Out-of-domain (未见过) 的地铁调度任务中,TrafficClaw 展示了极强的适应性。
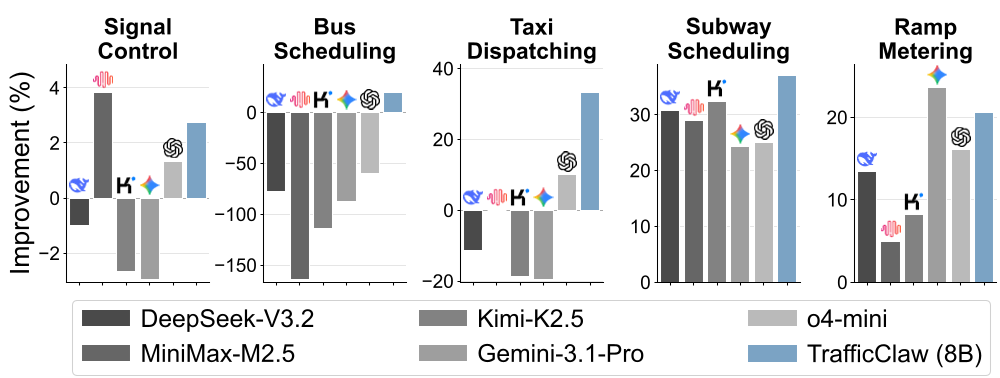 图 2: 不同场景下的相对性能提升,TrafficClaw 在各类任务中均保持稳定高位
3.2 协同的魔力:拒绝“按下葫芦浮起瓢”
在 Bus-Signal (公交-信号灯) 协同实验中,TrafficClaw 发现了深层逻辑:通过优化信号灯相位配合公交到站,可以在不增加乘客等待时间的前提下,显著降低公交的频繁启停,从而减少燃油消耗。
| 方法 | 全网平均旅行时间 (曼哈顿) |
|---|---|
| 经典方法 (Classic) | 486.65s |
| TrafficClaw (单一任务) | 465.95s |
| TrafficClaw (协同优化) | 459.87s |
4. 深度洞察:为什么这种范式有效?
- 代码即策略:LLM 强大的 Code-generation 能力让 Agent 可以根据具体路况动态构建逻辑,而非死记硬背权重。
- GRPO 强化学习的对齐作用:通过系统级的奖励函数(R_env + R_coord),Agent 学会了在冲突目标(如:公交服务质量 vs 燃油经济性)中取得帕累托最优平衡。
- 记忆的累积效应:随着交互迭代,Agent 的程序化记忆库越来越厚(见图 5),这使得它能够跳出“对即时状态的条件反射”,进入“基于模式的策略执行”。
5. 局限与未来
尽管 TrafficClaw 表现优异,但它对仿真器(如 SUMO)的调用频率较高,推理成本和响应延迟仍是实时部署的阻碍。未来的方向可能在于如何将这些复杂的交互经验,蒸馏到轻量级的专用模型中,实现微秒级的全网预测与控制。
总结: TrafficClaw 不仅仅是一个交通工具,它展示了 LLM 在处理具有强物理约束、多目标冲突的复杂动力系统时,通过“统一建模”所能爆发出的通用智能潜力。