
视野缩减:破解 LLM 长程任务训练崩溃的“银弹”
On Training Large Language Models for Long-Horizon Tasks: An Empirical Study of Horizon Length
本文对训练大语言模型(LLMs)处理长程任务(Long-Horizon Tasks)进行了系统的实证研究,提出了衡量任务难度的“目标距离(Goal Distance)”概念。研究发现,即使推理复杂度不变,交互步数的增加也会导致严重的训练不稳定,并据此提出了“视野缩减(Horizon Reduction)”原则,显著提升了长程任务的 SOTA 性能和训练稳定性。
TL;DR
为什么即便推理能力足够强,LLM Agent 在处理步骤较多的任务时依然容易“翻车”?最近的研究发现,交互步数(Horizon Length)本身就是模型训练的头号杀手。本文通过严谨的控制变量实验证明:简单的“视野缩减(Horizon Reduction)”——即减少模型达到目标所需的步数——能奇迹般地平复强化学习中的训练波动,并让模型具备“举一反三”处理更长任务的能力。
背景定位:长程任务中的“消失信号”
目前的 LLM 研究大多集中在单轮对话或思维链(CoT)推理上。但在真实的 Agent 场景(如代码调试、网页自动化)中,模型需要进行数十轮的交互。传统观点认为,长任务难是因为逻辑复杂;但本文提出了一个大胆的假设:即便逻辑极其简单,只要步数够多,训练就会崩。
痛点深挖:为什么 RL 搞不定长交互?
作者发现,当交互步数增加时,LLM 训练面临两大绝望:
- 探索困境:动作序列的组合爆炸让正确路径变成了“大海捞针”。
- 信用分配(Credit Assignment)灾难:在稀疏奖励下,如果模型在第 50 步失败了,强化学习会给前面 49 步所有动作打负分(负 Advantage)。这会导致梯度动力学中的“非对称性”——负向反馈会把概率推向词表中成千上万个无关 token,导致策略瞬间变“乱”。
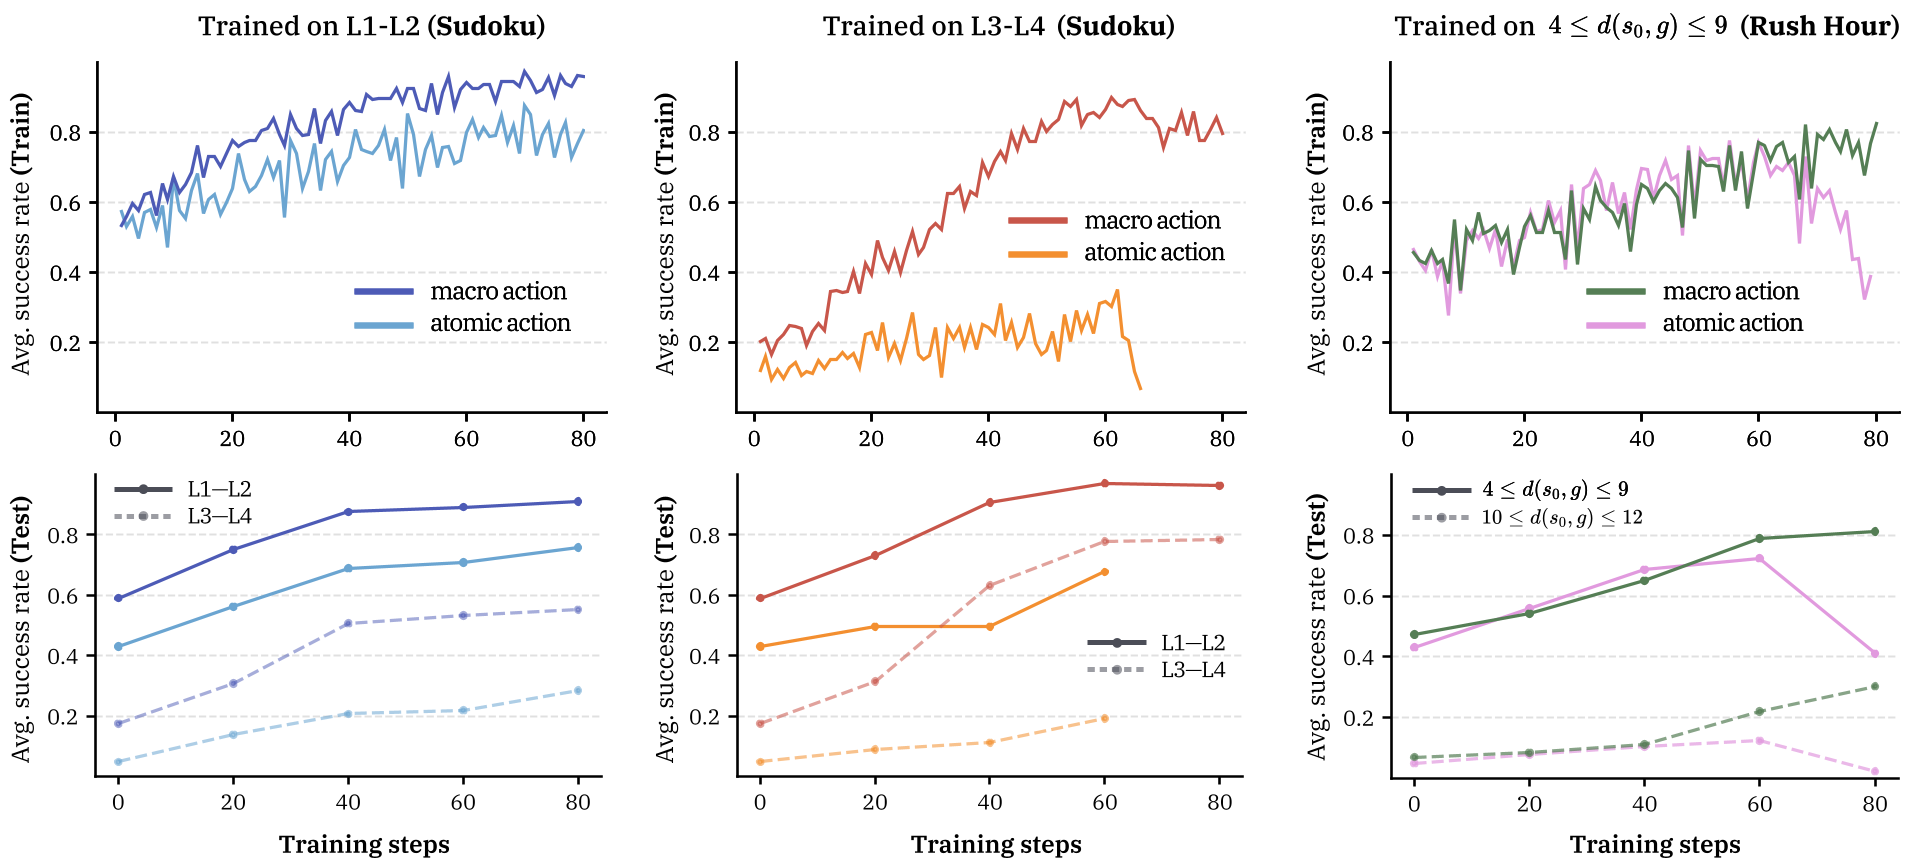 如上图所示,当目标距离增加时(L3-L4),使用原子动作的 RL(虚线)迅速发生性能崩塌,而视野缩减方法则稳步上升。
核心机制:视野缩减(Horizon Reduction)
既然长视野是毒药,那就“缩短”它。作者提出了两种简单粗暴但极其有效的方案:
1. 宏观动作 (Macro Actions)
不再要求模型一步一个脚印(原子动作)。例如在数独中,允许模型一次填入多个格子的值。这在本质上缩短了从起点到终点的有效视野(Effective Horizon)。
2. 子目标分解 (Subgoal Decomposition)
将大任务拆解。例如,只要填对一个九宫格就给一次奖励,而不是等 81 个格子全填完。通过局部反馈,将长程信用分配转化为短程。
实验见证:奇迹般的泛化能力
研究最令人兴奋的发现被称为 视野泛化(Horizon Generalization)。 传统的深度学习害怕“长度外推”,但本文发现:如果你在视野缩减后的任务上训练,模型不仅在短任务上表现更好,它在推理时处理以前从未见过的、更长距离的任务时,成功率也远超直接在长任务上硬练的模型(如下图)。
 可以看到,通过缩短训练视野,模型在超长视野(L5-L7)任务上的表现依然坚挺。
深度洞察:系统设计优于算法修补
作为资深技术主编,我认为这篇论文最大的价值在于纠正了研究方向的偏见。
- 不要过度迷信复杂的 RL 算法:哪怕是基础的 REINFORCE 或 GRPO,只要交互步数设计合理,都能发挥出惊人的潜力。
- 动作空间即生命线:Agent 开发者的第一要务不应该是微调模型,而是思考如何通过工具(如代码执行、API 组合)来压缩模型的决策路径长度。
总结与局限
虽然本文在数独和益智游戏中取得了显著成果,但在实时性极强、环境高度随机(Stochasticity)的任务中,“宏观动作”的稳定性仍有待验证。但毫无疑问,“视野缩减”为打造能够自主完成复杂工作流的下一代 AI 助手提供了最坚实的理论基础。
Takeaway: 交互深如海,缩短才是爱。