
TrajRAG:让 AI 拥有“路感”,检索几何-语义经验实现零样本导航
TrajRAG: Retrieving Geometric-Semantic Experience for Zero-Shot Object Navigation
本文提出了 TrajRAG,这是一个用于零样本目标导航(Zero-Shot ObjectNav)的检索增强生成框架。通过构建“拓扑-极坐标”(Topo-Polar)轨迹表示,该方法能够从海量历史经验中检索出几何-语义特征相似的路径,从而显著提升了大语言模型(LLM)在未知环境中的推理和决策能力。
TL;DR
在自动驾驶或室内导航中,人类不仅靠地图,更靠“经验”——比如看到类似的走廊布置,就知道尽头大概率是厨房。TrajRAG 赋予了 AI 这种能力。它通过将复杂的 3D 轨迹压缩为极其精简的 Topo-Polar(拓扑-极坐标) 格式,并利用 RAG(检索增强生成)技术,让机器人在进入完全陌生的房间时,能从过去几千次导航中瞬间找出“相似经历”,从而像“老司机”一样精准找到目标。
背景定位:常识不等于经验
当前的 Zero-shot ObjectNav(零样本目标导航)主要依赖像 GPT-4 这样的大模型进行常识推理。虽然大模型知道“马桶一般在卫生间”,但它不知道“这种特定结构的 L 型拐角后面通常连着卫生间”。
现有的痛点在于:
- 缺乏空间直觉:互联网文本数据缺乏真实的 3D 空间关系。
- “黑瞎子掰棒子”:机器人每跑完一次导航就清空记忆,无法实现终身学习(Lifelong Experience)。
- 记忆冗余:如果把所有视频帧存下来,检索压力极大且效率低下。
核心机制:Topo-Polar 轨迹表示法
为了将杂乱的 RGB-D 观测转化为可检索的知识,作者设计了一种极具物理直觉的表示法:
- 骨架化(Skeletonization):将语义地图压缩成一像素宽的拓扑骨架,提取出关键节点(如路口、转角)。
- 极坐标扇区(Polar Sectors):在每个节点上,将周围 360° 空间切分为 12 个扇区(每份 30°)。每个扇区记录看到的物体类别(如沙发、墙、未知区)。
- 循环位移不变性:这种表示法允许通过简单的向量循环位移来匹配不同朝向的场景,解决了机器人初始姿态不一导致的匹配难问题。
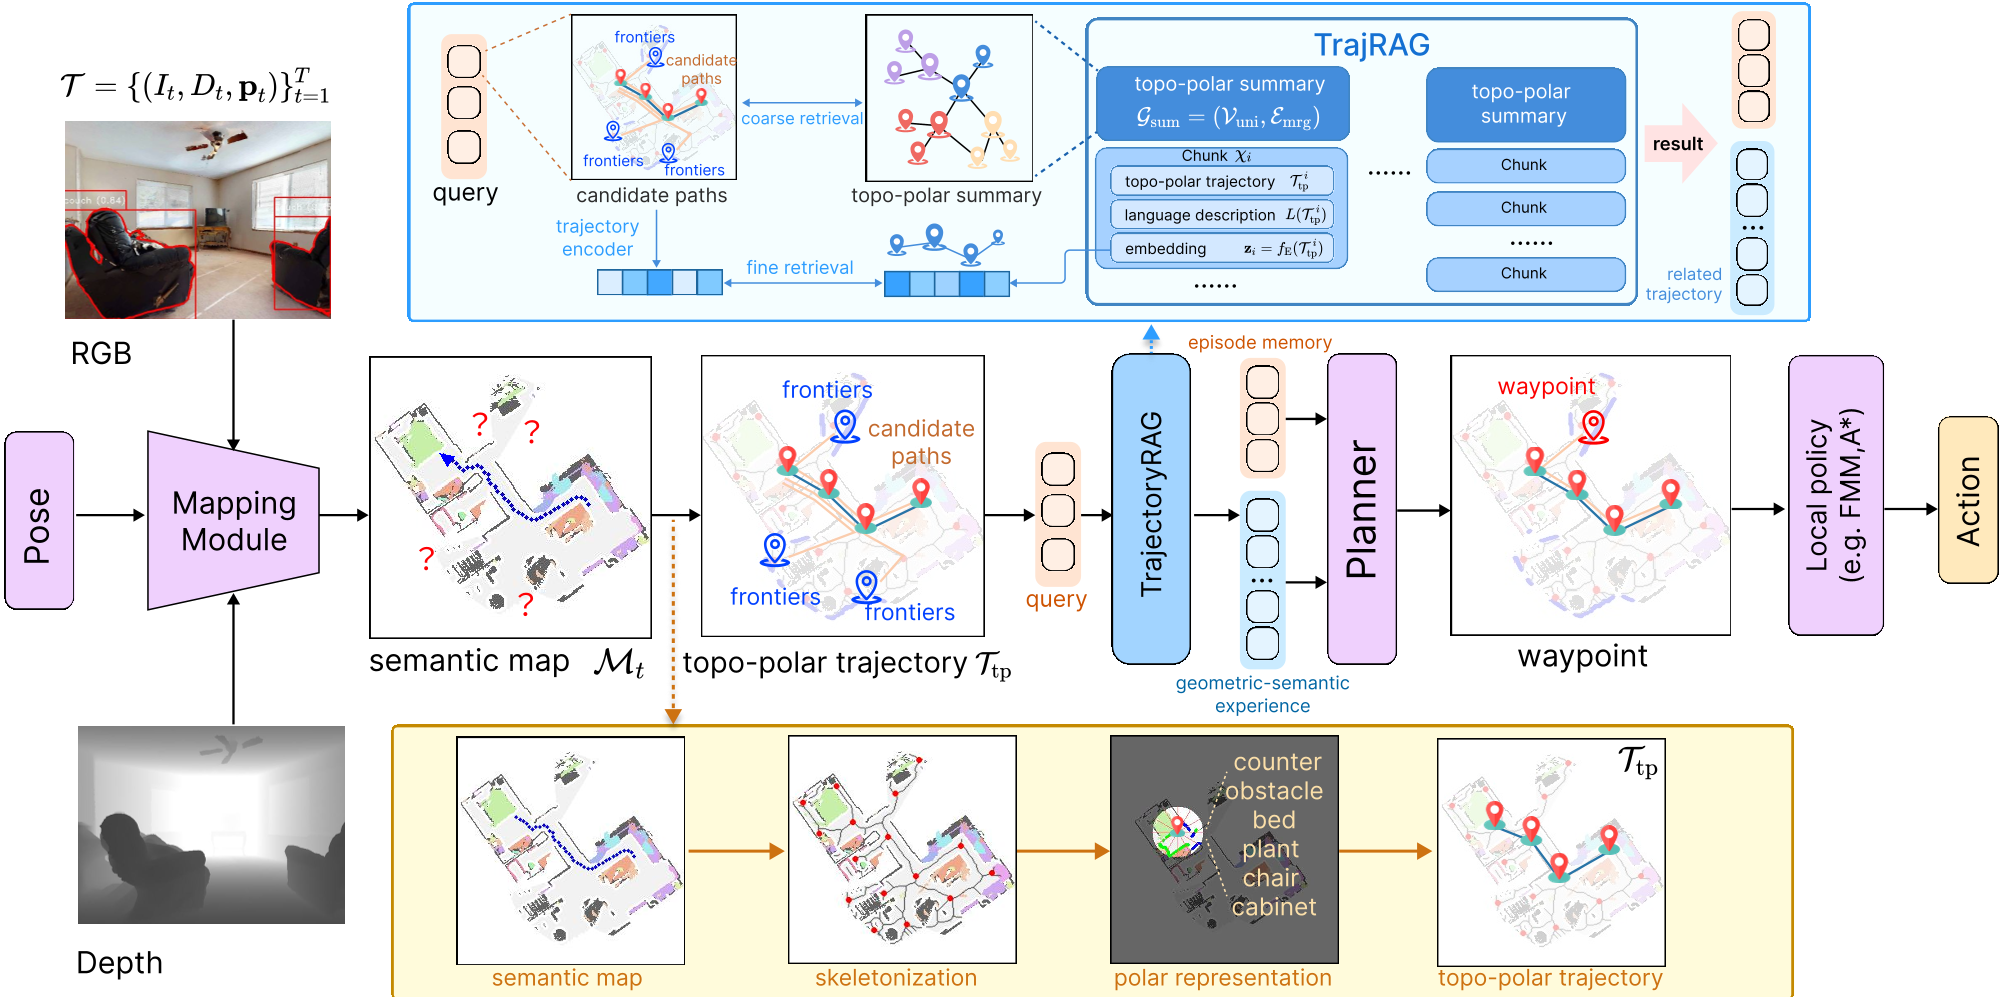 图 1:TrajRAG 导航框架。智能体动态维护语义图,生成候选轨迹并通过层次化检索获取历史经验。
检索流程:从“粗”到“细”
TrajRAG 并不盲目检索所有轨迹,而是采用了两阶段方案:
- 粗检索(Coarse Index):通过计算当前场景与数据库中“轨迹摘要”的几何-语义一致性,先锁定几个相似的房屋布局(场景级匹配)。
- 细检索(Fine Index):利用专门训练的 Trajectory Encoder,在候选集内进行向量相似度计算,找出路径最相近的经验片段。
最后,这些 retrieved experiences(检索到的经验)被转化为自然语言,输入给 LLM 决策者:“在类似环境下,走 A 路径在 5 米后找到了床”。
实验战绩与 SOTA
TrajRAG 在 MP3D 等主流数据集上全面超越了现有的 SOTA 方法(如 VLFM, UniGoal 等)。
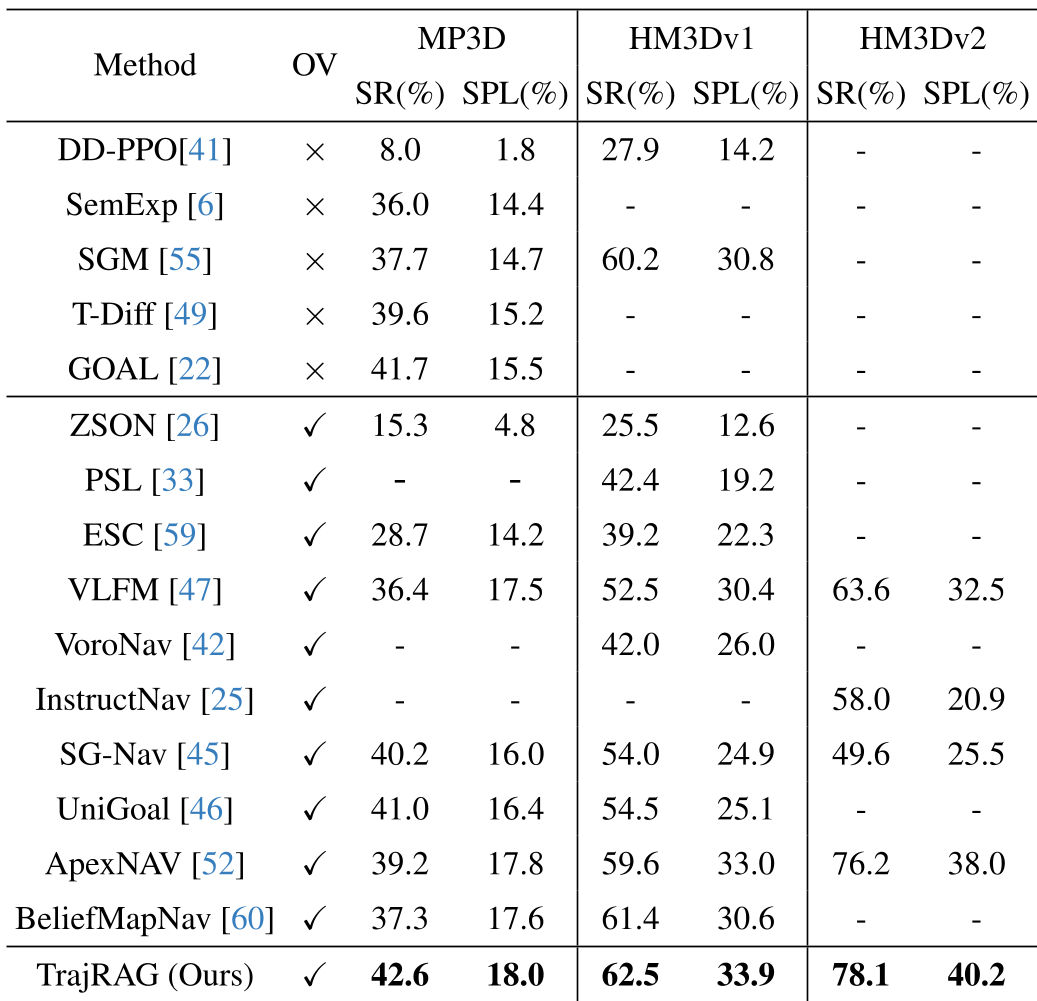 表 1:在 MP3D, HM3Dv1/v2 数据集上的性能对比。TrajRAG 均取得了领先。
关键洞察:
- 消融实验证明:单纯的文本描述(Table 1 中的 TNA)效果远不如 Topo-Polar 表示,说明空间结构关系才是导航的灵魂。
- 跨数据集泛化:在 HM3D 上训练的经验库,直接拿到 MP3D 环境下依然有效,这说明 Topo-Polar 抓住了室内环境布局的通用规律。
深度思考
TrajRAG 的价值在于它打破了“预训练知识”与“即时感知”之间的藩篱。它不仅是一种导航算法,更提出了一种具身数据资产化的思路:如何将机器人日常采集的、海量的冗余传感器数据,转化为高价值、可检索、可泛化的“具身知识库”。
局限性: 尽管能够处理几何和语义,但在动态环境(物体移动)或极度杂乱的环境下,拓扑骨架的提取稳定性仍有待观察。
总结
TrajRAG 为零样本导航提供了一个优雅的解法。它告诉我们,要让机器人变聪明,不仅要给它一个强大的大脑(LLM),还要给它一本记录了过去成千上万次探索的“私人笔记”。