
UniCorrn:首个跨 2D 与 3D 的统一几何匹配 Transformer
UniCorrn: Unified Correspondence Transformer Across 2D and 3D
本文提出了 UniCorrn,这是首个在 2D-2D、2D-3D 和 3D-3D 几何匹配任务中实现权重共享的统一 Transformer 模型。UniCorrn 通过一个独特的双流解码器架构,在 7Scenes (2D-3D) 和 3DLoMatch (3D-3D) 任务上分别超越此前 SOTA 达到 8% 和 10% 的注册召回率提升。
TL;DR
UniCorrn 推翻了“一种模态一个架构”的传统匹配范式。它通过一个巧妙的双流解码器 (Dual-stream Decoder) 架构,仅用一套共享权重的模型就同时横扫了图像间 (2D-2D)、像素与点云间 (2D-3D) 以及点云间 (3D-3D) 的所有对齐任务。在 3DLoMatch 榜单上,它的表现直接提升了 10%,同时内存占用比多个专用模型组合降低了 3.5 倍。
背景定位:几何匹配的“大统一”尝试
在 3D 视觉中,几何对齐(Correspondence)是 SLAM、三维重建和姿态估计的核心基石。然而由于 2D 图像(规则网格)与 3D 点云(稀疏、无序)在数据结构上的巨大鸿沟,研究界一直依赖于“各司其职”的专用模型。UniCorrn 的出现,试图在几何感知层面建立跨模态的通用架构。
痛点深挖:为什么 2D 的那一套在 3D 上玩不转?
现有的 2D 匹配方法通常有三种路线,但在面对 3D 时各有死穴:
- 成本体积 (Cost Volume):依赖固定分辨率的图像金字塔,面对跨度巨大的稀疏点云时效率极低。
- 最近邻搜索 (Nearest Neighbor):匹配是一次性的,无法放入神经网络层中进行多次迭代优化。
- 直接回归 (Direct Regression):缺乏显式的几何约束,在处理 3D 结构时精度糟糕。
核心算法:双流解码器 (Methodology)
作者的洞察非常深刻:Transformer 的注意力矩阵本质上就是一个可学习的匹配代价函数(Matching Cost)。
1. 架构解析
UniCorrn 由模态特定的 Backbones (ViT & PTv3) 提取特征,随后通过一个共享权重的 Feature Fusion Encoder 进行特征交换。最核心的创新在于其 Matching Decoder。
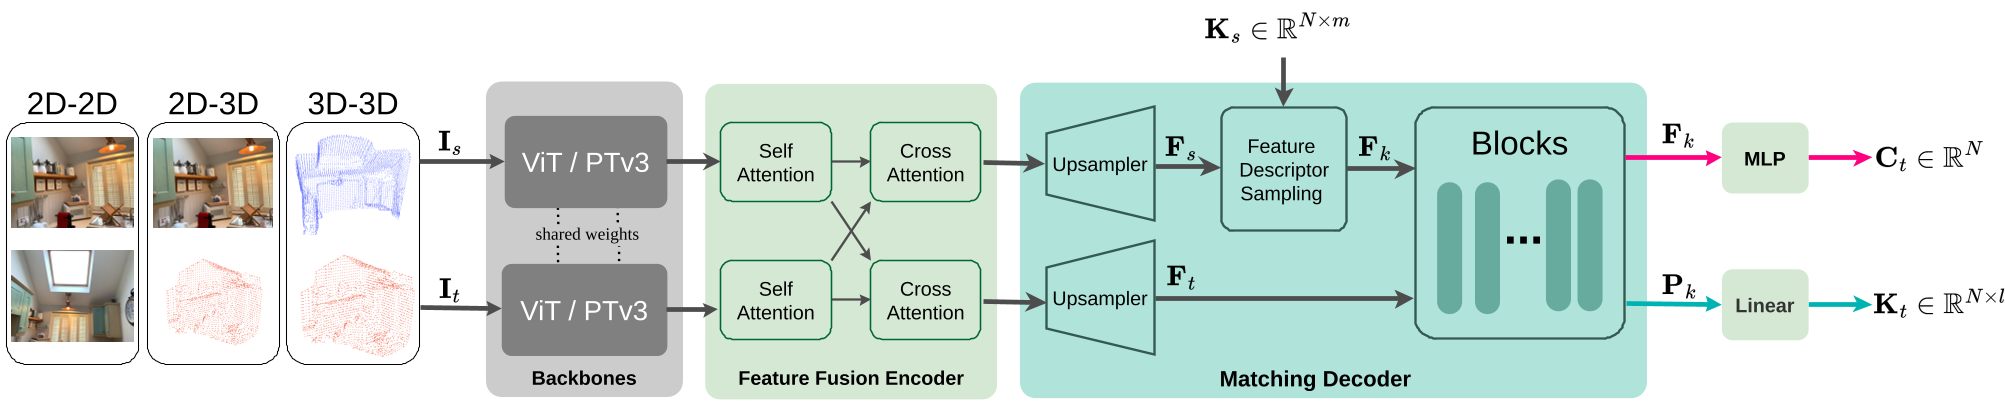 Figure 2: UniCorrn 总体架构,包含模态特定主干、共享编码器及双流解码器。
2. 双流设计 (Dual-stream Design)
为了能够“堆叠”层进行迭代精炼,UniCorrn 将信息分成了两个流:
- 外观流 (Appearance Stream):更新特征描述符,确保匹配的语义正确。
- 位置流 (Positional Stream):更新坐标预测,确保对齐的几何精度。
这两个流共享同一个注意力矩阵(即匹配代价),在每一层中互相促进,使得位置预测随着层数增加而愈发精准。相比传统自注意力,作者还引入了 Gaussian Attention 来处理非线性相关性,实验证明这比传统的点积注意力效果更好。
实验与结果:统治级的 3D 表现
UniCorrn 的强项在于 2D-3D 和 3D-3D。在 7Scenes 这种极难的图像-点云配准任务中,它的注册召回率(RR)从前人的 83% 左右跃升至 91.0%。而在点云对点云的 3DLoMatch 任务中,提升更是惊人。
 Table 6: 3DMatch 与 3DLoMatch 结果。注意在低重叠度场景下 RR 提升了近 10%。
此外,消融实验(Ablation Study)验证了辅助监督 (Auxiliary Supervision) 的关键性:通过在每一层解码器都输出预测并计算 Loss,注意力图会从随机状态快速收敛到精准的匹配点上(见下图)。
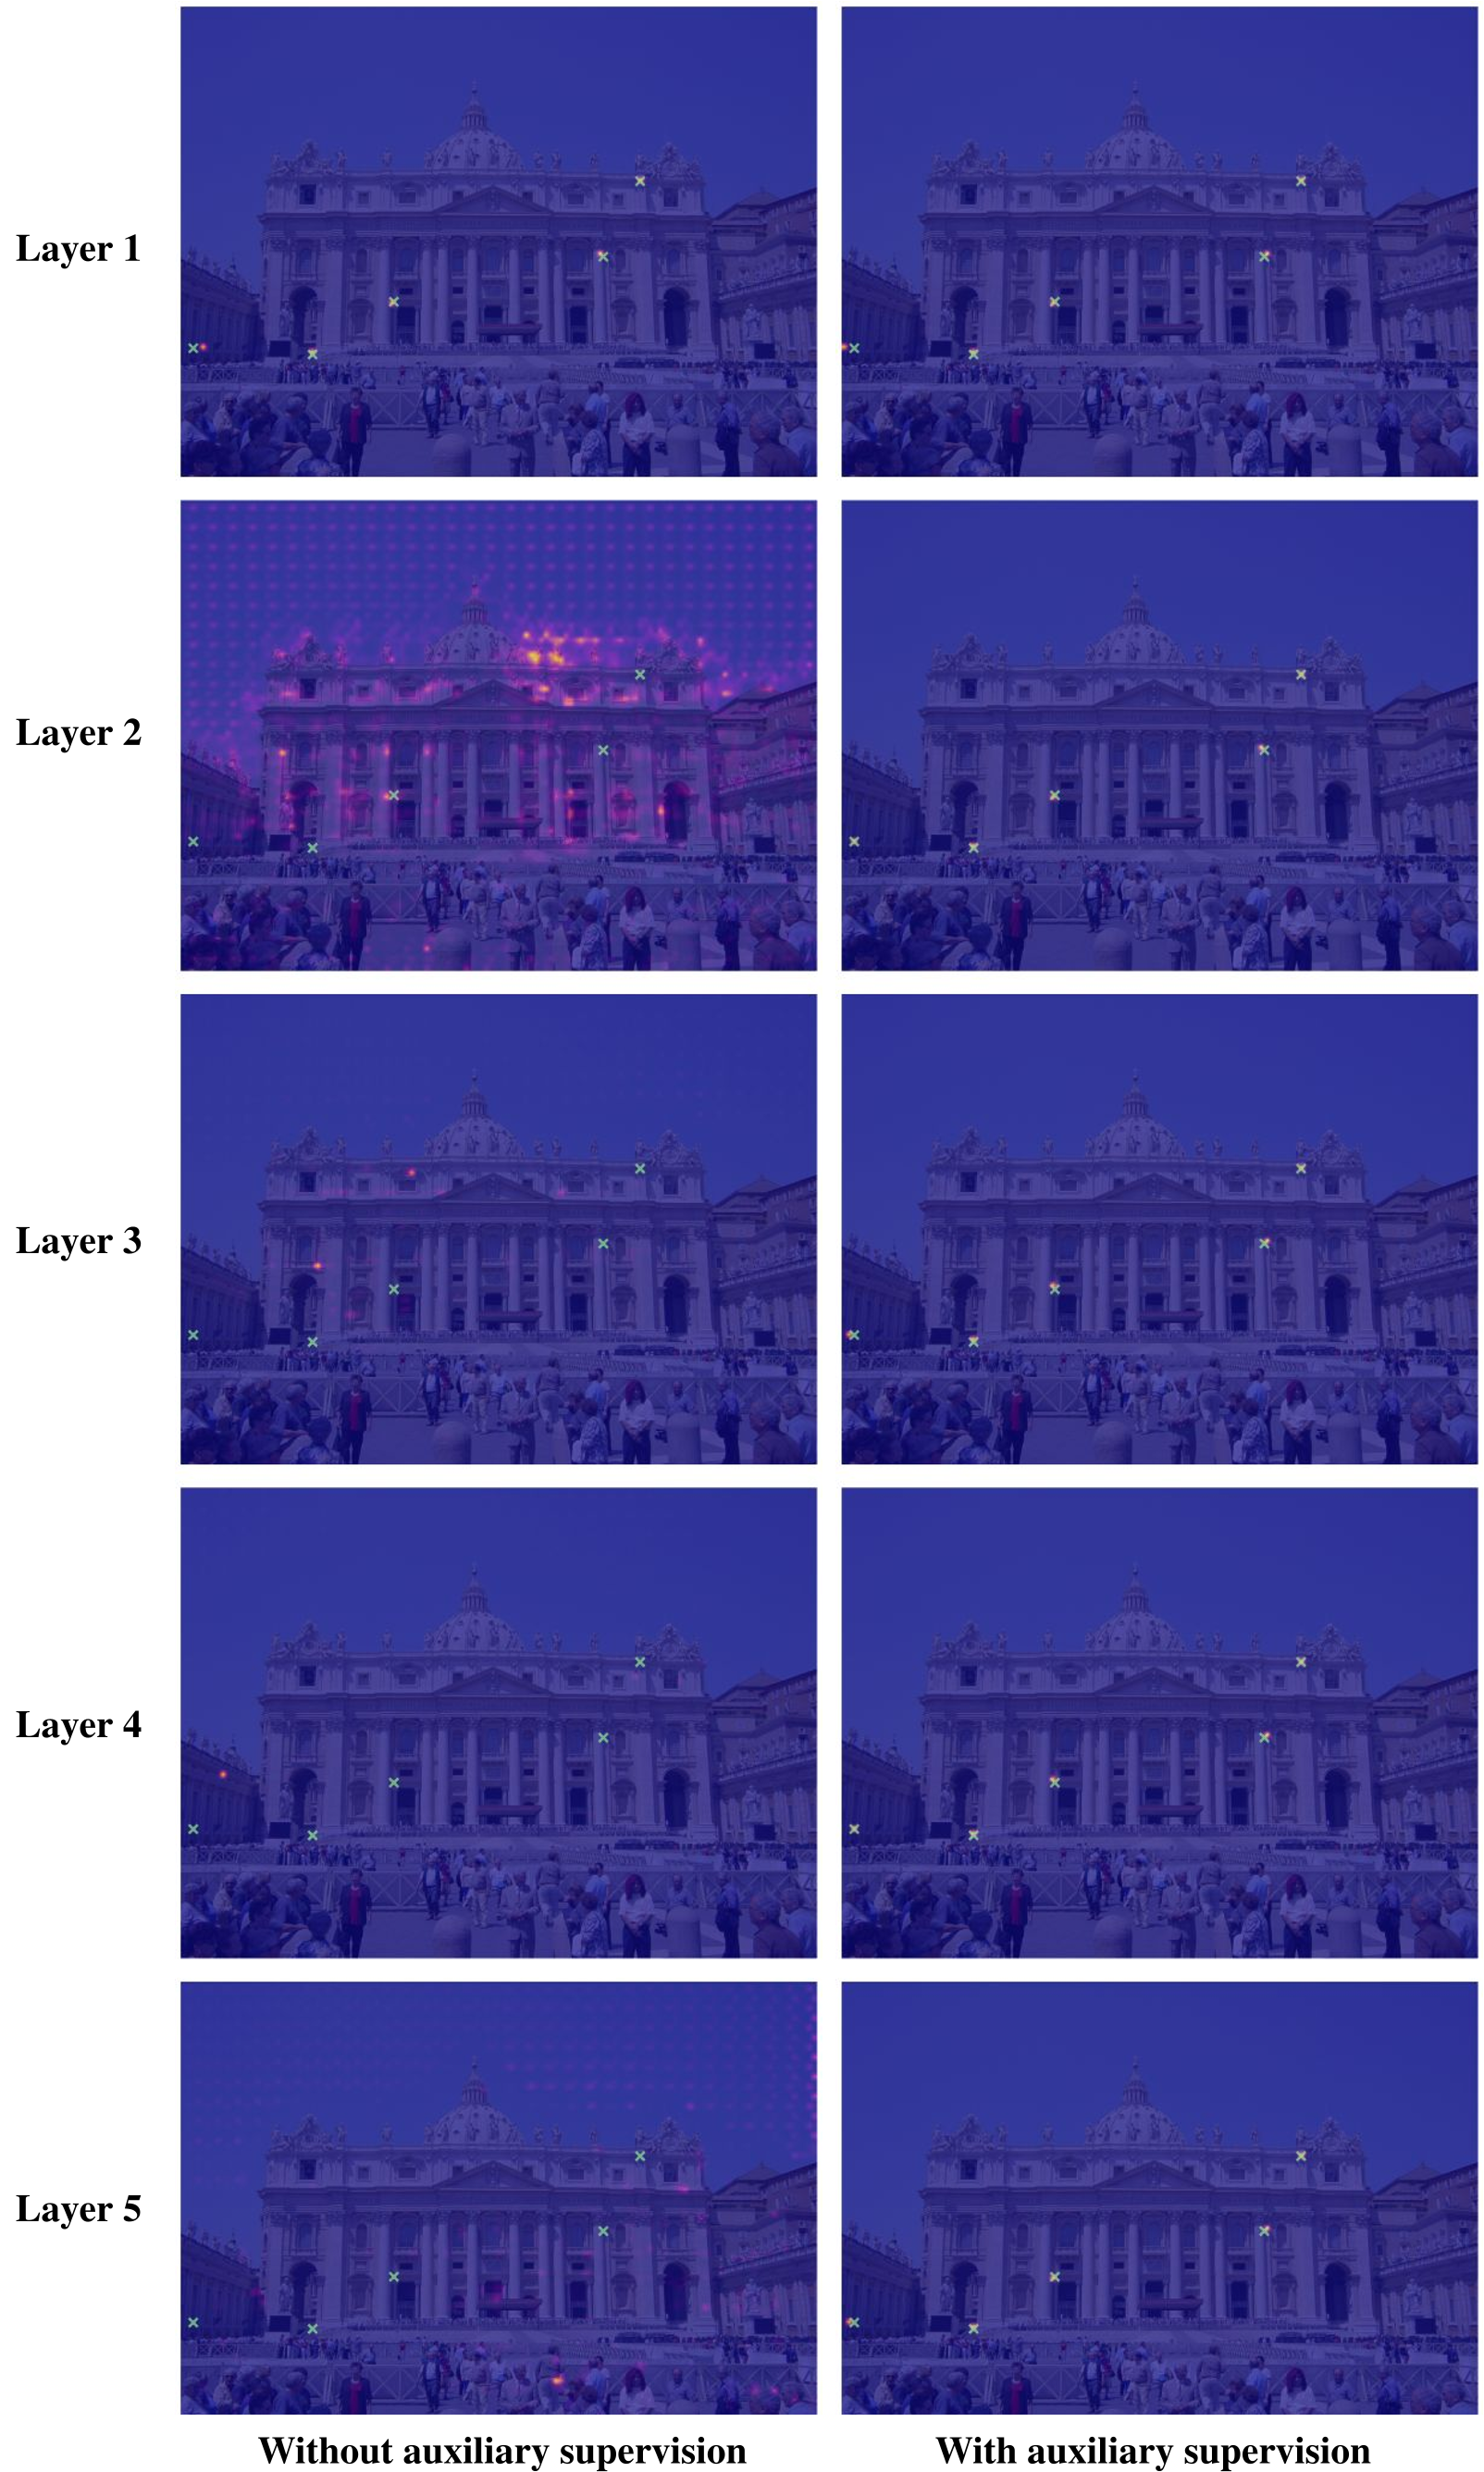 Figure 8: 随着解码器层数增加,注意力热力图逐渐聚焦于真实的匹配目标,这证明了双流迭代的有效性。
深度洞察与总结
联合训练的“阵痛”
尽管 UniCorrn 在跨模态对齐上表现优异,但作者也诚实地指出:目前 joint training 仍然面临挑战。归一化层 (Normalization Layers) 在处理图像和点云不同的统计特性时会产生梯度冲突(GCD 指标显示)。这也是为什么某些 2D 任务在联合训练后反而略微下降。
启示
UniCorrn 的成功揭示了一个趋势:底层的几何规律是通用的,不应被数据格式(像素 vs 点云)所束缚。通过解耦 appearance 和 position,Transformer 能够进化成一个通用的几何对齐引擎。这对于未来需要在复杂场景中同时处理摄像头和激光雷达数据的自动驾驶与机器人领域具有深远意义。