
Skill1:打破孤立优化,让 AI 智能体在技能选择、利用与蒸馏中协同进化
Skill1: Unified Evolution of Skill-Augmented Agents via Reinforcement Learning
本文提出了 Skill1,这是一个统一演化框架,旨在通过强化学习同时优化语言模型智能体(LLM Agents)的技能选择、技能利用和技能蒸馏。在 ALFWorld 和 WebShop 任务中,Skill1 显著超越了现有基线,在 ALFWorld 上达到了 97.5% 的成功率。
TL;DR
在构建具备长期记忆的 LLM Agent 时,如何高效管理“技能库”是一个核心难题。现有的方法往往由于“选、用、存”三个环节的脱节,导致智能体陷入优化瓶颈。本文介绍的 Skill1 框架通过一种巧妙的信号分解机制,利用单一的任务成功奖赏,实现了技能选择(Selection)、利用(Utilization)和蒸馏(Distillation)的统一协同进化。该方法在 ALFWorld 和 WebShop 等复杂任务中刷新了 SOTA 记录,展示了 AI 智能体自我迭代的巨大潜力。
痛点深挖:为什么“碎块化”的优化行不通?
当前的技能增强型智能体通常将技能生命周期拆分为三个独立阶段:
- 技能选择:从库中搜寻相关的策略。
- 技能利用:根据选定的技能执行任务。
- 技能蒸馏:从成功经验中总结新技能并归档。
然而,现有的 SOTA 方法(如 RetroAgent, SkillRL)存在两个关键局限:
- 优化不平衡:通常只针对利用阶段进行强化学习,而选择或蒸馏环节往往依赖冻结的检索器或启发式规则,这导致了“木桶效应”。
- 信号不一致:不同阶段使用不同的奖励来源(如自评得分、匹配分),这在联合训练时会产生方向性的冲突。
方法论详解:一套代码,三种能力,一个目标
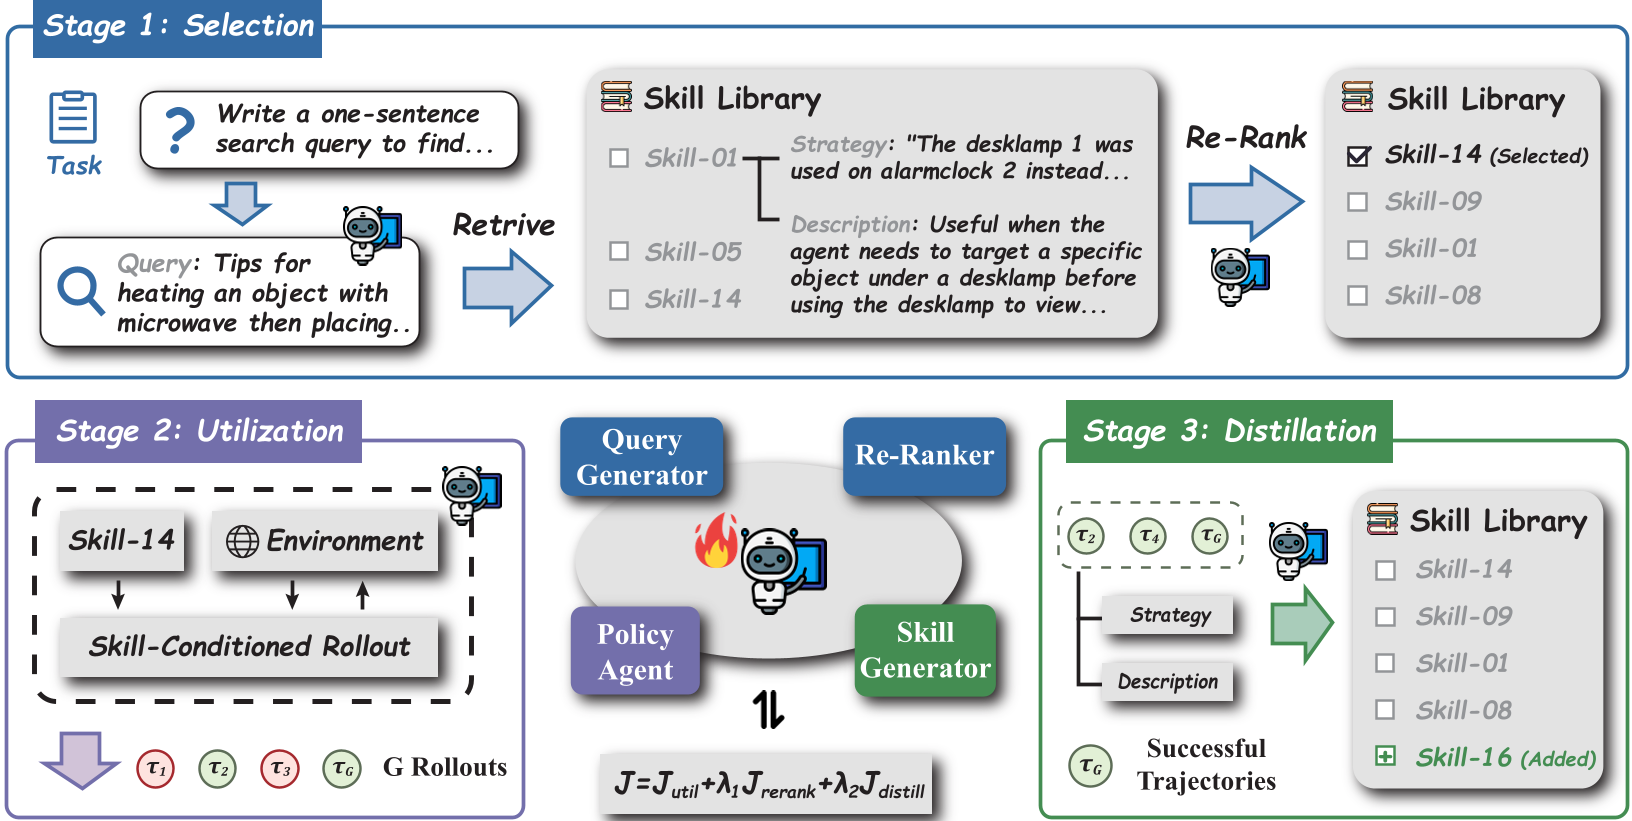
Skill1 的核心直觉在于:技能的成功率背后隐藏着不同的频率特征。作者提出将单一的任务结果信号 进行频谱式分解:
1. 架构解析 (The Unified Policy)
Skill1 不再使用多个模块,而是由同一个 Policy 生成查询(Query)、重排序(Re-rank)、执行动作(Actions)以及最后的总结(Distillation)。
2. 奖励分配:频谱分解的艺术
为了让单一的 (0 或 1)能同时指导三个阶段,Skill1 进行了如下解构:
- 利用奖励 (Utilization Credit):直接使用 。这是高斯过程中的基础信号,指导模型“怎么做”。
- 选择奖励 (Selection Credit):使用低频趋势 (Low-frequency trend)。通过维护技能的指数移动平均得分 ,反映技能的长效价值,指导模型通过生成更好的 Query 和 Rank 来锁定高价值技能。
- 蒸馏奖励 (Distillation Credit):使用高频波动 (High-frequency variation)。定义为当前结果与库中最佳预期(Baseline)的差值 。只有当这次表现超过了库里现有的最高水平,才给予蒸馏动作正向激励。
实验与结果:全线 SOTA 与协同动态
SOTA 对比
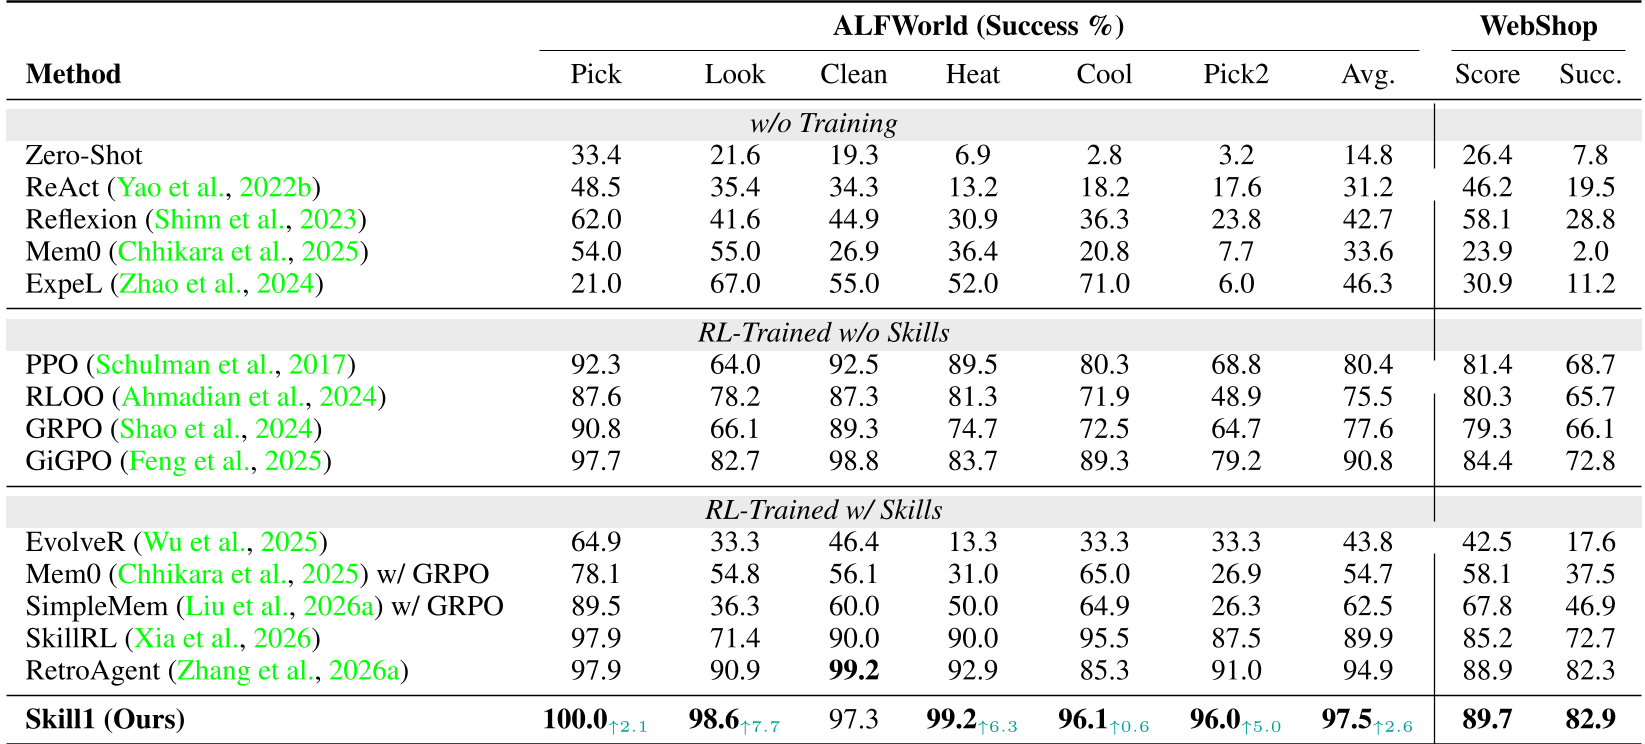
在 ALFWorld 的 6 类任务中,Skill1 在其中 5 类达到了顶尖水平,综合成功率达到 97.5%。特别是在涉及多步规划的 Pick2 任务中,其优势尤为明显,证明了显式技能库对复杂决策的补充作用。
协同进化动态
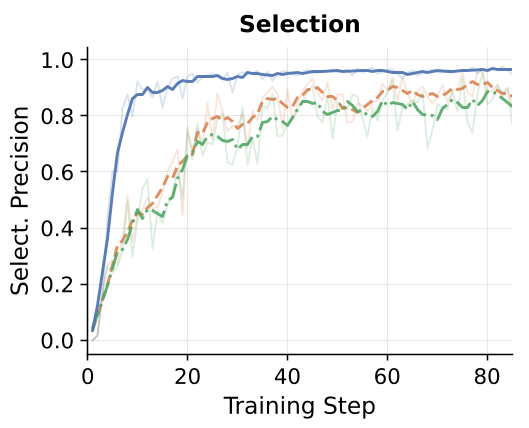
研究最有趣的发现之一是各能力的演化顺序:选择精度最先收敛,随后高质量的技能供应加速了利用和蒸馏的提升。这种“阶梯式”的相互助推是协同进化的直接证据。
深度洞察:计算效率与技能多样性
- 多样性:与传统方法容易陷入“明星技能”陷阱不同,Skill1 的蒸馏奖励(Variation-driven)强迫模型去探索尚未被现有库覆盖的新场景,从而维持了技能库的生态多样性。
- 效率:虽然维护技能库带来了 1.3-1.7 倍的计算开销,但蒸馏过程通过将冗余的长轨迹压缩为简洁的 Strategy,其实在长期运行中保护了模型的上下文窗口,防止了检索过载。
总结与限制
Skill1 证明了**统一演化(Unified Evolution)**是提升智能体自主能力的关键路径。通过将技能的全生命周期纳入端到端的 RL 训练,智能体不再只是机械地执行任务,而是在执行中学习管理自己的“智慧财产”。
局限性:目前 Skill1 主要在文本环境(Text-based)中验证。未来如何扩展到具有高维度视觉观测的具身环境,以及如何分层组织数万规模的超大型技能库,仍是待攻克的科学高峰。
致读者:如果你对具身智能、长上下文管理或 Agent 的 RL 训练感兴趣,Skill1 提供的这种单一信号分解思路非常值得在你的项目中尝试。