
UniSD:摆脱外部教师,LLM 如何通过“自我校验”实现性能飞跃?
UniSD: Towards a Unified Self-Distillation Framework for Large Language Models
本文提出了 UniSD,一个用于大语言模型(LLM)自我蒸馏(Self-Distillation)的统一框架。通过整合多教师一致性、EMA 教师稳定化、对比学习等机制,UniSD 在不依赖外部强大教师模型的前提下,使 Qwen2.5-7B 在六项基准测试中平均提升 5.4%,超越了现有 SOTA 基线。
TL;DR
长期以来,大语言模型(LLM)的微调与蒸馏高度依赖于更强大的“外部教师”(如 GPT-4)。然而,这种依赖带来了高昂的成本、隐私风险以及版权限制。本文介绍的 UniSD 框架彻底打破了这一桎梏,通过多教师一致性(Agreement)、EMA 稳定化和特征对齐等模块,让模型能够在自身的生成结果中挖掘高质量信号。实验表明,UniSD* 方案在六大 benchmark 上实现了显著的 SOTA 提升。
核心痛点:为什么“自学”这么难?
模型自我蒸馏(Self-Distillation, SD)本质上是一个“左脚踩右脚”的逻辑。在 Autoregressive 场景下,这面临两个致命问题:
- 噪声强化(Noise Reinforcement):模型可能会产生看起来很像样但逻辑错误的轨迹。如果盲目学习这些自我生成的错误,会导致严重的性能崩塌。
- 训练不稳(Instability):由于教师信号(模型自身)在训练过程中不断变化,目标函数会发生“漂移”,导致模型难以收敛或过度拟合。
Methodology:UniSD 的三位一体架构
作者认为,有效的自我蒸馏必须控制:用什么信号、匹配什么表示、以及更新多快。
1. 监督可靠性:智慧来源于“内在群众”
UniSD 引入了 Multi-Teacher Agreement。它不是真的找多个模型,而是通过不同的 Context(如检索到的 Few-shot 或特定的 Instruction)产生多个“教师视角”。如果多个视角在一个 Token 上达成共识,该信号就被赋予高权重。
2. 表示对齐:不止于概率分布
传统的蒸馏只看输出概率(Logit)。UniSD 加入了 Feature Matching,强迫学生模型的隐藏状态(Hidden States)与教师对齐,从而在结构化表征层面上保证一致性。
3. 训练稳定性:给学习装上“减震器”
- EMA Teacher:使用模型权重的指数移动平均作为教师目标,避免目标函数剧烈震荡。
- Divergence Clipping:防止某些异常 Token 产生过大的 KL 散度,从而避免梯度爆炸。
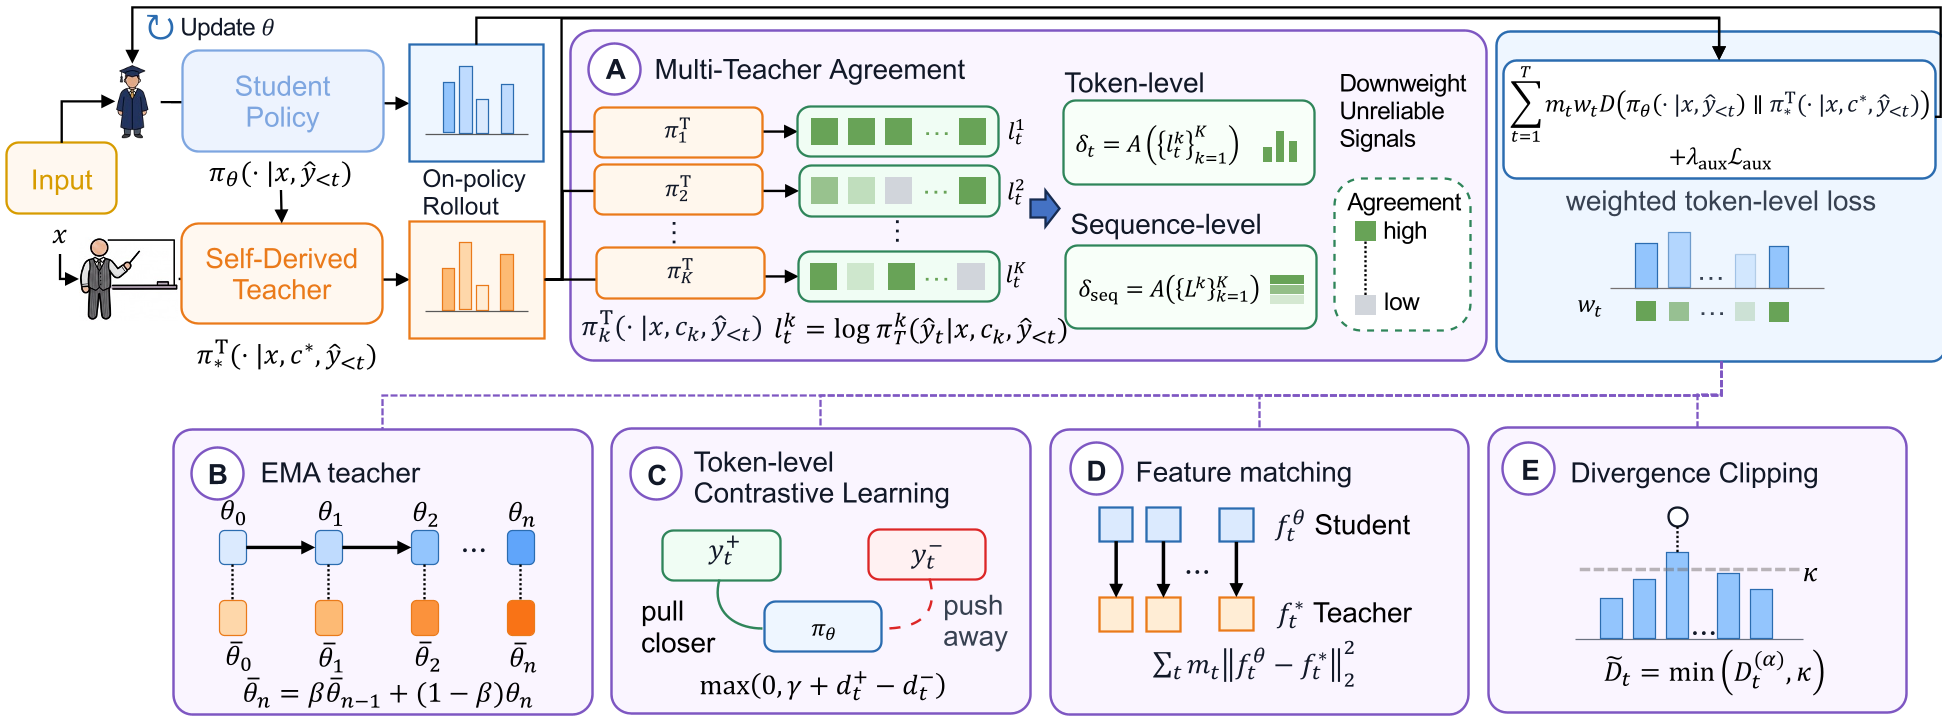 图 1:UniSD 统一框架,整合了一致性权重、EMA、对比学习与特征匹配等多个维度。
实验战绩:全面超越基线
UniSD*(集成版)在 Qwen2.5, Llama-3.1 和 Gemma-3 上进行了广泛测试。以下是核心数据亮点:
- 性能飞跃:在 Qwen2.5-7B 上,相比基座模型在 ScienceQA 提升了 +3.5%,在 ToolAlpaca 提升了 +16.1%。
- 胜过传统 SFT:SFT 虽然能学到格式,但往往会损害模型的通用推理能力。UniSD 通过 On-policy 学习,在保持准确度的同时,其**分发保留率(Distribution Retention)**远高于 SFT。
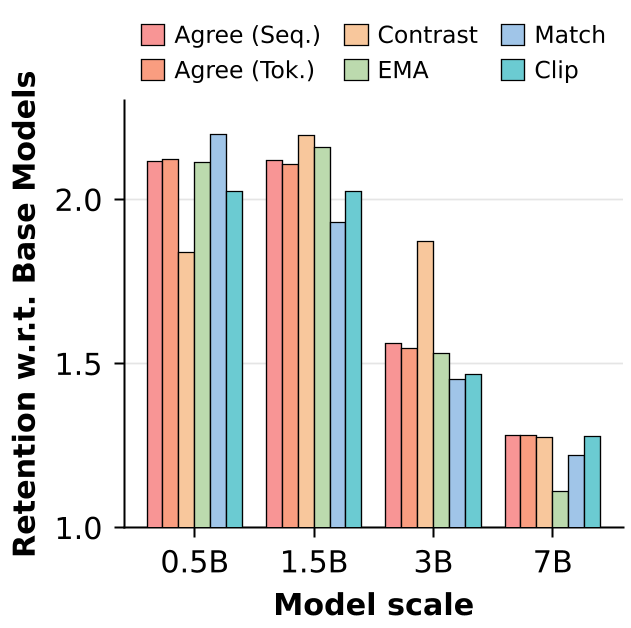 图 2:在不同模型规模(0.5B 到 7B)下,UniSD 均表现出稳定的性能提升,特别是在 OOD(跨领域)任务上表现强劲。*
深度洞察:一致性策略的影响
研究发现,**检索式上下文(Retrieval-based)**在科学推理任务(ScienceQA)中对一致性权重的提升最明显。然而,增加教师视角的数量(K 值)并不总是有效,过多的视角可能会引入冗余或冲突,这启示我们:自我蒸馏的质量在于“精”而非“多”。
总结与局限
UniSD 证明了 LLM 即使没有“明师指路”,也能通过系统的自我博弈和可靠性校验实现自我迭代。
- 价值:显著降低了模型适配新任务的门槛。
- 局限:多教师视角的计算开销(Training Time)显著高于 SFT(如图 5 所示)。如何进一步优化计算效率将是未来的重要课题。
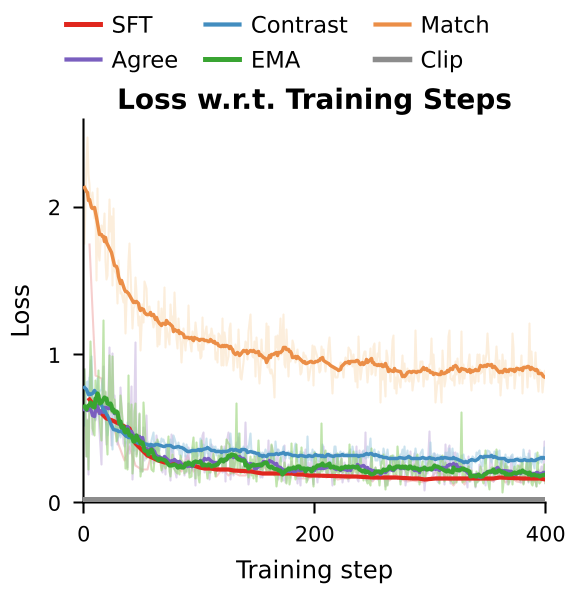 图 3:性能与训练时间的权衡,UniSD 效果最佳但在计算上更沉重。*
Takeaway:LLM 的“内卷”其实是一种有效的自我进化路径。