
UniPool:打破 MoE 层级壁垒,构建亚线性增长的共享专家池
UniPool: A Globally Shared Expert Pool for Mixture-of-Experts
本文提出了 UniPool,一种将 Mixture-of-Experts (MoE) 的专家容量视为全局预算的架构。通过将各层私有的专家集替换为全局共享专家池,配合池级辅助损失和 NormRouter,UniPool 在多种 LLaMA 架构量级下一致超越了传统 MoE 性能基准。
TL;DR
在大型语言模型(LLM)的算力竞赛中,Mixture-of-Experts (MoE) 凭借“常数代价增加参数量”的特性成为绝对主流。然而,UniPool 发现现有的 MoE 同行们都犯了一个“昂贵的错误”:专家必须隶属于某一特定的层。本文提出的 UniPool 架构通过建立全局共享专家池,实现了专家参数与模型深度的解耦。实验表明,UniPool 不仅在性能上 SOTA,更能在仅用 40% 专家参数的情况下,强于全量参数的传统 MoE。
背景定位:层级独占——MoE 架构中的“资源浪费”
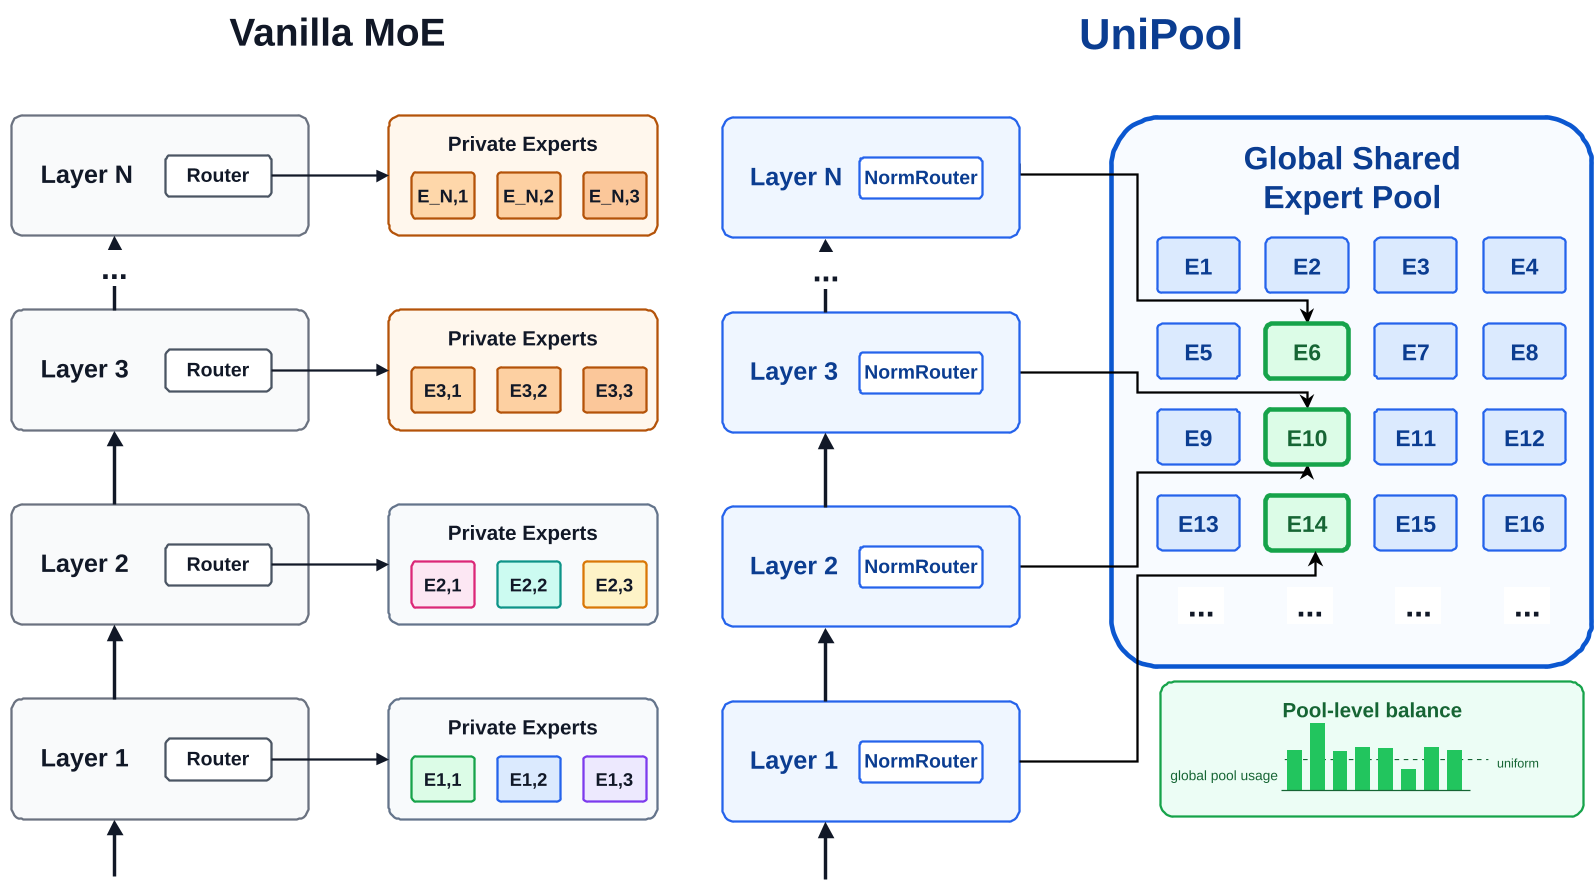
目前的 MoE 模型(如 Mixtral, DeepSeek)都遵循一套僵硬的分配规则:第 N 层拥有的专家,第 N+1 层不能用。 这种设计强行绑定了深度(Depth)与专家规模(Expert Budget)的线性增长关系。但作者通过一个直觉性的探测(Routing Probe)发现:如果随机干扰深层的路由选择,下游准确率仅下降 1.0-1.6 个点。这说明深层专家之间存在严重的功能冗余。
核心方法论:从“私产”到“公海”
UniPool 并不是简单的参数共享,它解决了“共享专家”模式下的两大核心挑战:负载均衡与路由稳定性。
1. 全局专家池 (Global Shared Pool)
UniPool 将 层模型中的所有专家汇聚成一个规模为 的大池子。每一层仍然保留一个独立的路由器 ,但这些路由器现在都从同一个“公海”里挑选最适合当前 token 的专家进行计算。
2. 池级辅助损失 (Pool-level Auxiliary Loss)
传统的辅助损失是逐层计算的(层内平衡)。但在共享架构下,如果强制每一层都要用遍池子里的所有专家,会破坏专家的“层级特化”。 UniPool 创新性地提出了池级损失:它不在乎单层用了谁,只监测整个训练步长中,是否有专家在全局范围内变得“死寂”(Dead Experts)。这允许不同层自发地聚焦于池子中的不同子集。
3. NormRouter:尺度鲁棒的导航仪
在深浅不一的层中,隐藏状态(Hidden States)的尺度差异巨大。作者采用了 NormRouter:
- L2 Normalization:抹平了深浅层的能量差异,让路由只看“方向”而非“模长”。
- ReLU 激活:天然产生稀疏分值,让专家竞争更有序。
实验与结果:参数减半,性能不减
研究人员在 182M 到 978M 的五种规模上进行了严格对比。
性能超越 SOTA
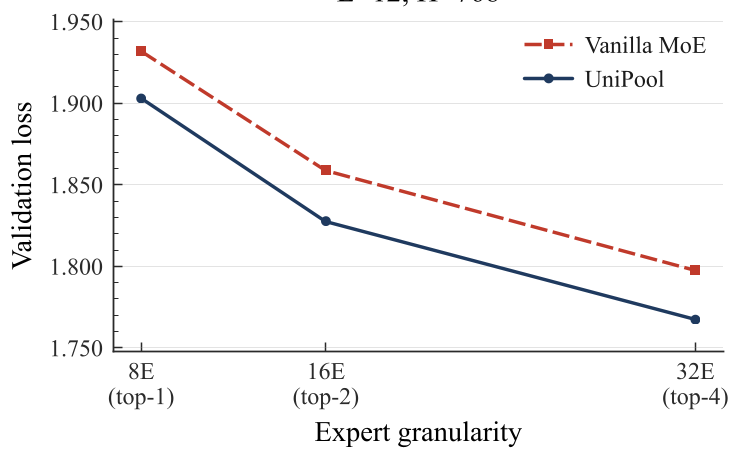
在相同计算量和专家总数下,UniPool 在所有规模上都实现了比 Vanilla MoE 更低的验证集 Loss 和困惑度(Perplexity)。
亚线性增长:容量的奇迹
这是 UniPool 最令人振奋的结论:专家参数不需要随深度同步增长。 实验数据显示,UniPool 在 830M 规模下,仅保留 41.6% 的专家参数量,其表现依然优于 100% 参数量的传统 MoE。这意味着我们可以用更小的内存显存占用,换取更强的模型深度。
深度洞察:为什么 UniPool 有效?
路由敏感度分析揭示了 UniPool 的物理直觉: 在传统 MoE 中,如果你随机化某一层路由,性能几乎不掉,因为层内专家太像了(Redundancy)。但在 UniPool 中,同样的随机化会导致更大幅度的性能暴跌(达 4.1 个点)。 这说明:共享机制强迫专家在全局范围内进行更高维度的分工与特化(Specialization)。UniPool 榨干了专家库中的冗余,让每一次路由选择都变得“至关重要”。
总结与局限性
UniPool 证明了 MoE 的演进方向不应只是“专家越多越好”,而应是“专家动态复用”。
局限性:
- 目前实验主要基于 1B 参数以下的规模,虽然一致性很强,但扩展到 70B+ 规模时的**专家并行(Expert Parallelism)**吞吐性能仍需进一步工程验证。
- 全局池化可能在超大规模集群训练中增加节点间的通信负担,这需要更巧妙的拓扑优化。
UniPool 的代码已开源,这或许是未来大规模长文本、超深层 MoE 架构的一个重要里程碑。