
UniVidX:视频生成大模型的“全能工具箱”,一网打尽 15 种图形学任务
UniVidX: A Unified Multimodal Framework for Versatile Video Generation via Diffusion Priors
本文提出了 UniVidX,这是一个统一的多模态视频生成框架。它将多样化的视频图形任务(如逆渲染、视频抠图、重照明)统一建模为多模态空间内的条件生成问题,在单个模型中实现了涵盖 15 种任务的 SOTA 性能。
TL;DR
UniVidX 是一套将视频模态生成大一统的新范式。它打破了传统“一任务一模型”的限制,通过随机条件掩码 (SCM) 和 解耦门控 LoRA (DGL),在保持基础模型(如 Wan2.1)强大生成能力的同时,实现了视频抠图、深度法向估计、重照明等 15 种任务的统一。最令人惊叹的是,它仅在不到 1000 个视频上微调,就在真实世界场景中展现了降维打击般的泛化效果。
背景定位:从“专才”走向“全才”
在 AI 视频处理领域,我们过去习惯于看到针对特定任务优化的模型:NormalCrafter 专门做视频法向,RVM 专门做视频抠图。这种任务孤岛(Task Isolation)策略存在两个致命伤:
- 输入僵化:如果你只有法向图想生成 RGB 视频,专门做 RGB→Normal 的模型就哑火了。
- 模态打架:当你串联多个模型生成 RGBA 视频时,各层之间的光影和边缘往往无法自然对齐。
UniVidX 的核心直觉是:一个足够强大的视频扩散模型 (VDM) 其实已经“背下了”物理世界的规律。我们不需要重新设计架构,只需要给它换一种“读写方式”,让它可以自由地在文本、RGB、Albedo(反照率)、Normal(法向)等各种信号之间进行条件生成。
核心技术三剑客
1. 随机条件掩码 (SCM):全向生成的“魔法”
SCM 改变了训练逻辑。在推理时,模型不再被告知“输入 A 输出 B”,而是在训练阶段随机把模态 A、B、C 划分为“干净的条件”或“带噪的目标”。
- Text→X:纯文本生成一切。
- X→X:模态转换(如 RGB 视频转法向图)。
- Text & X → X:在文本引导下进行修改。
2. 解耦门控 LoRA (DGL):保护大模型的“智商”
直接在多模态数据上全参数微调会导致大模型“灾难性遗忘”。UniVidX 为每种模态设计了独立的 LoRA 模块(DGL),并且只在某模态需要被“生成”时才激活对应的 LoRA。这保证了模型在处理 Albedo 时不会被 Normal 的数据分布干扰,最大程度回收了 VDM 基础模型的原生先验。
 图 1:UniVidX 的核心架构,展示了 SCM 和 DGL 的工作流程
3. Cross-Modal Self-Attention (CMSA):跨模态同步
不同模态的隐变量(Latents)在 Batch 维度拼接,通过 CMSA 进行交互。它共享了 K 和 V,让生成的法向图能“看到”RGB 视频里的光影变化,从而确保生成的每一层画面在空间上是绝对对齐的。
实验战绩:以一当十
UniVidX 被实例化为两个垂直领域模型:
- UniVid-Intrinsic:处理反照率、辐照度、法线。
- UniVid-Alpha:处理前景、背景、Alpha 通道。
在视频抠图 (Video Matting) 任务中,UniVid-Alpha 在无需额外分割掩码(Auxiliary-Free)的情况下,表现甚至超过了许多需要掩码引导的 SOTA 方法(如 MatAnyone)。
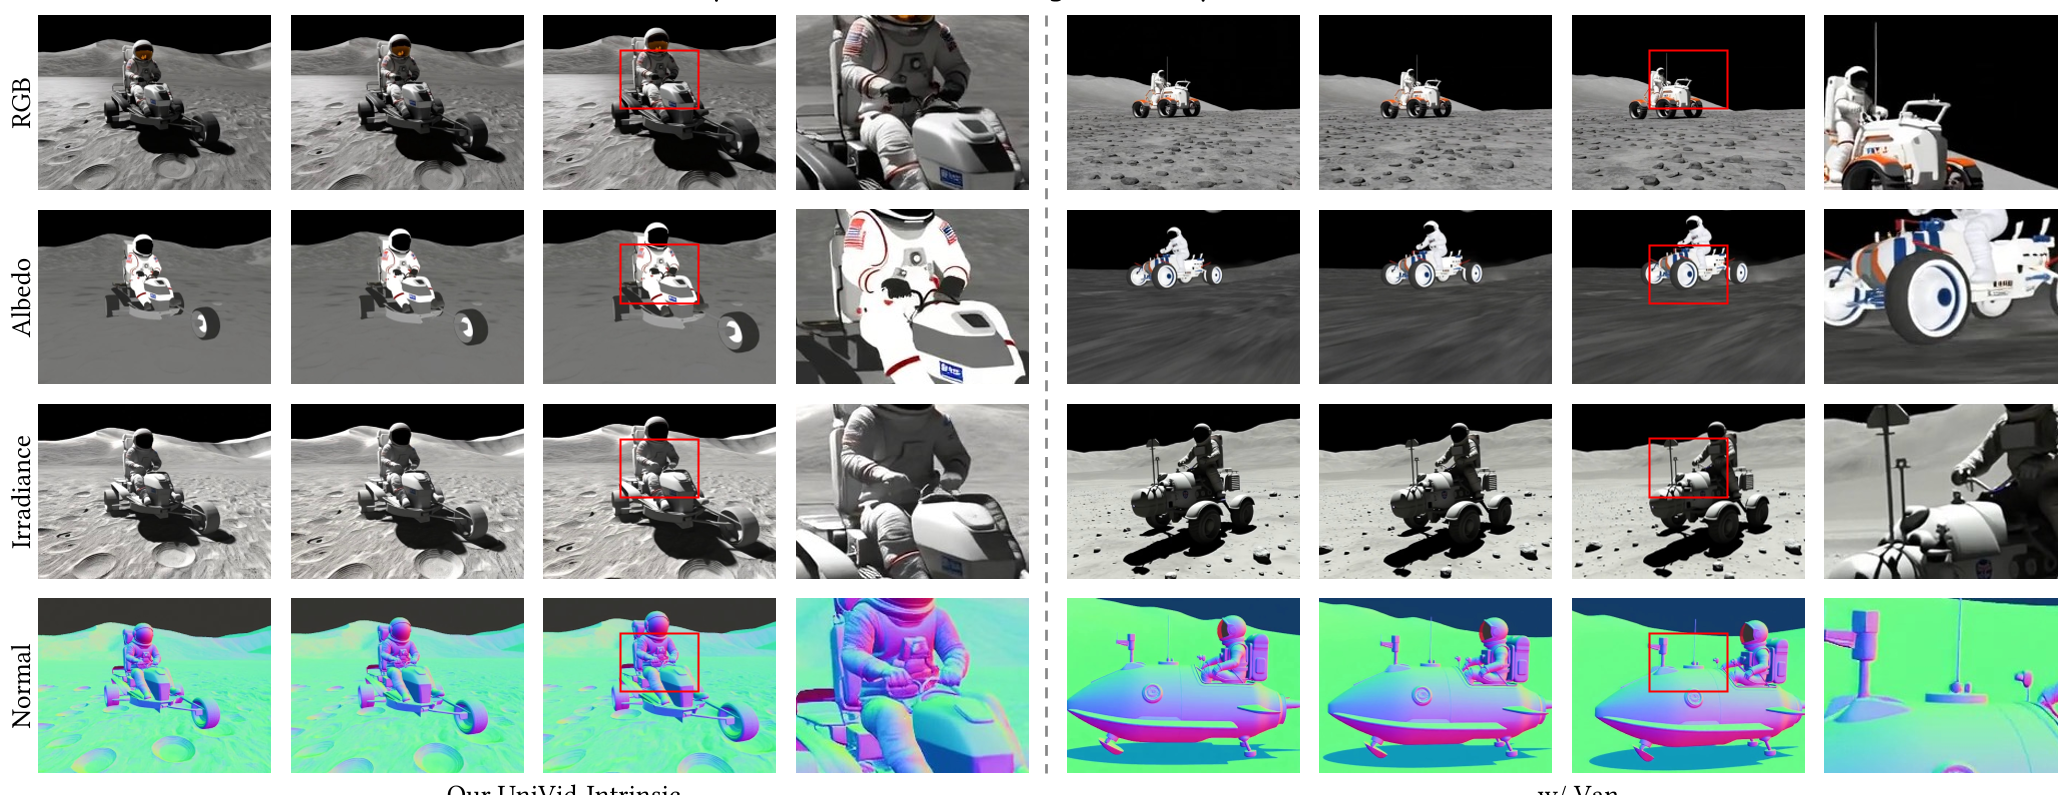 图 2:CMSA 对齐效果对比。左侧为我们的方法,展示了极高的多模态一致性
深度洞察:为什么 UniVidX 如此强悍?
作者在消融实验中揭示了一个关键发现:不能使用通道拼接(Channel Concatenation)。很多模型习惯通过堆叠模态通道来处理多模态,但这样会破坏 VDM 预训练权重的底层结构,导致结构性崩溃。UniVidX 坚持在 Batch 维度扩展,并配合 CMSA,这证明了尊重预训练先验的结构往往比增加模型参数更重要。
未来展望与局限
尽管 UniVidX 表现惊人,但它仍受限于显存消耗。目前通过 14B 参数量的 Wan2.1 骨干网络,只能处理最多 4 个模态并发生成的 480p 短视频。此外,对于透明材质(如玻璃)的 Alpha 通道处理,模型仍受限于训练数据的偏差。
总结 (Takeaway):UniVidX 标志着视频图形学任务进入了“大一统生成”时代。它不再通过硬编码的函数去计算法线或抠图,而是教会生成式 AI 去“想象”物理模态之间的关联。这种方法对于构建未来的通用视频理解与编辑系统具有重要的启发意义。