
Uno-Orchestra:打破编排僵局,让智能体在准确与廉价之间“全都要”
Uno-Orchestra: Parsimonious Agent Routing via Selective Delegation
本文提出了 Uno-Orchestra,一种统一的 LLM 编排策略,旨在通过单一的 Causal-LM 策略联合优化任务分解与模型路由。该方法在 13 项基准测试(涵盖数学、代码、代理工具使用等)中达到了 77.0% 的平均 Pass@1 准确率,比最强的基线工作高出约 16%,同时将单次查询成本降低了一个数量级。
TL;DR
Uno-Orchestra 是一套全新的 LLM 编排范式。它不只是简单的路由,也不只是死板的任务分解,而是一个高度灵活的**选择性委派(Selective Delegation)**系统。通过将“怎么拆任务”和“派给哪个模型做”合并为一个决策过程,它在 13 项主流 benchmark 上将准确率提升了 16%,同时把成本压低到了原来的 1/10。
痛点深挖:为什么现在的智能体系统既贵又笨?
目前的 LLM 多智能体编排主要有两条死胡同:
- 扁平化路由 (Model Routing):比如一个轻量级模型决定把这个 query 发给 GPT-4 还是 Llama。这解决不了大任务需要分步走的问题,容易“毕其功于一役”却惨遭失败。
- 层级化编排 (Hierarchical Orchestration):系统强行把每个任务都拆成子任务。这种做法对简单问题极其浪费钱,而且拆分策略和执行模型的分配往往是脱节的,导致“Planner”和“Worker”之间缺乏默契。
作者的直觉是:一个真正聪明的“指挥家”应该拥有** Abstain(弃权)**的能力——简单任务直接秒杀(Lazy mode),复杂任务才动用手术刀式的分解,并且每一刀切下去时,就已经想好了这一块该交给哪个具体工种(模型+原始动作对)。
核心方法:Uno-Orchestra 统一决策机制
1. 将分解与路由合并为一种语言
Uno-Orchestra 不使用额外的模块,而是让一个 Qwen-7B 级别的模型通过输出特定的 XML 语法来决定一切。在一个 forward pass 中,模型会输出:
<plan>: 任务的有向无环图(DAG)结构。<route>: 为每个子任务指定(model, skill)。这里的skill(原始动作)非常关键,它包含了代码执行、搜索或纯推理。
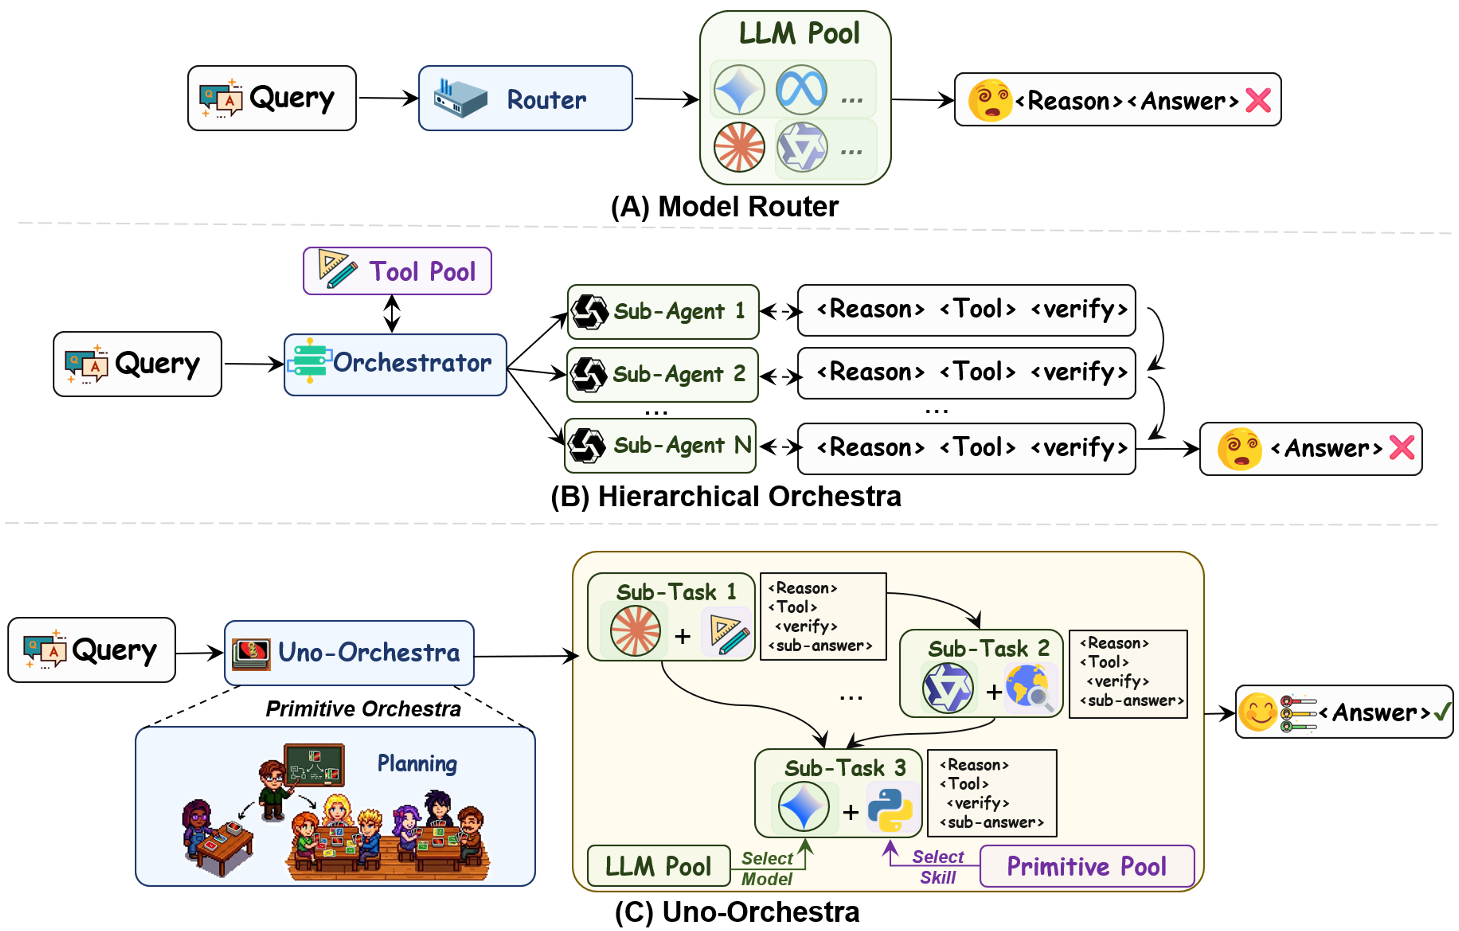 图 1: (A) 传统路由,(B) 层级编排,(C) Uno-Orchestra 统一架构
2. Agentic-GRPO:为每一步棋分配信用
传统的强化学习(如 GRPO)在处理多轮对话时,通常只在最后给一个总分(Pass/Fail)。这对智能体来说太难了:如果第一步路由错了,后面再努力也没用。
作者提出了 Agentic-GRPO。它在总奖励的基础上,引入了:
- 轮次级 return (Turn-level Return): 让模型知道是哪一次 Task Decomposition 或哪一次 Model Selection 导致了最终的成功。
- SHAPE 奖励: 奖励那些语法正确、逻辑闭环的中间步骤。
实验与结果:降维打击的效率
在包括 MATH-500, HumanEval, GAIA 等 13 个领域的综合评测中,Uno-Orchestra 的表现令人惊艳。
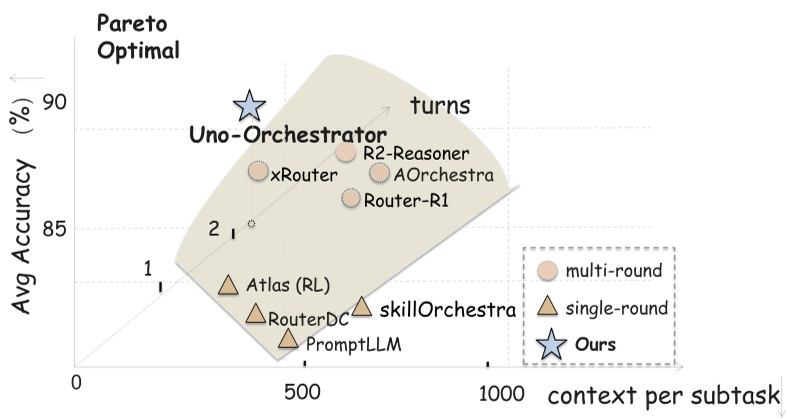 图 2: 准确率 vs. billed cost(账单成本)。Uno-Orchestra (最右上角节点) 实现了极高的准确率与极低的成本平衡。
- 准确率提升:平均 Pass@1 达到 77.0%,远超 AgentOrchestra。
- 成本骤降:每条查询的平均成本仅为 $0.10 左右。这是因为 Uno-Orchestra 能够识别简单任务并使用“Lazy Mode”,跳过昂贵的分解成本。
- 泛化性:实验证明,即使更换掉底层的 Frontier 模型(如去掉 Claude 3.5),Uno-Orchestra 依然能通过优化路由策略保持竞争力。
深度洞察:智能体的“吝啬”是一种美德
Uno-Orchestra 的核心理念是 Parsimonious(吝啬/简约)。
在 Case Study 中可以看到,模型不再盲目堆砌调用次数。例如在数学竞赛题中,如果发现约束条件本身是矛盾的,它会触发 decomp_repair 模式,先质询意图而非盲目计算。这种“审题”的能力是目前大多数编排器所欠缺的。
总结与局限
Uno-Orchestra 成功地将编排问题从一个“流程设计问题”转化为了一个“策略学习问题”。
局限性:
- API 稳定性依赖:由于它依赖外部商业 API 作为 Worker,如果 API 的延迟或性能发生漂移,训练好的路由策略可能需要重新适配。
- 校验器的依赖:RL 的效果高度依赖于 Verifier 的准确性,对于没有客观标准(如创意写作)的任务,其表现尚待验证。
总的来说,Uno-Orchestra 为通向低成本、高可靠的智能体系统指明了一条清晰的道路:让 AI 学会像人类专家一样,在“快速反应”和“深思熟虑”之间自如切换。