
VEFX-Bench:解耦视频编辑评价,谁才是真正的 VFX 调优大师?
VEFX-Bench: A Holistic Benchmark for Generic Video Editing and Visual Effects
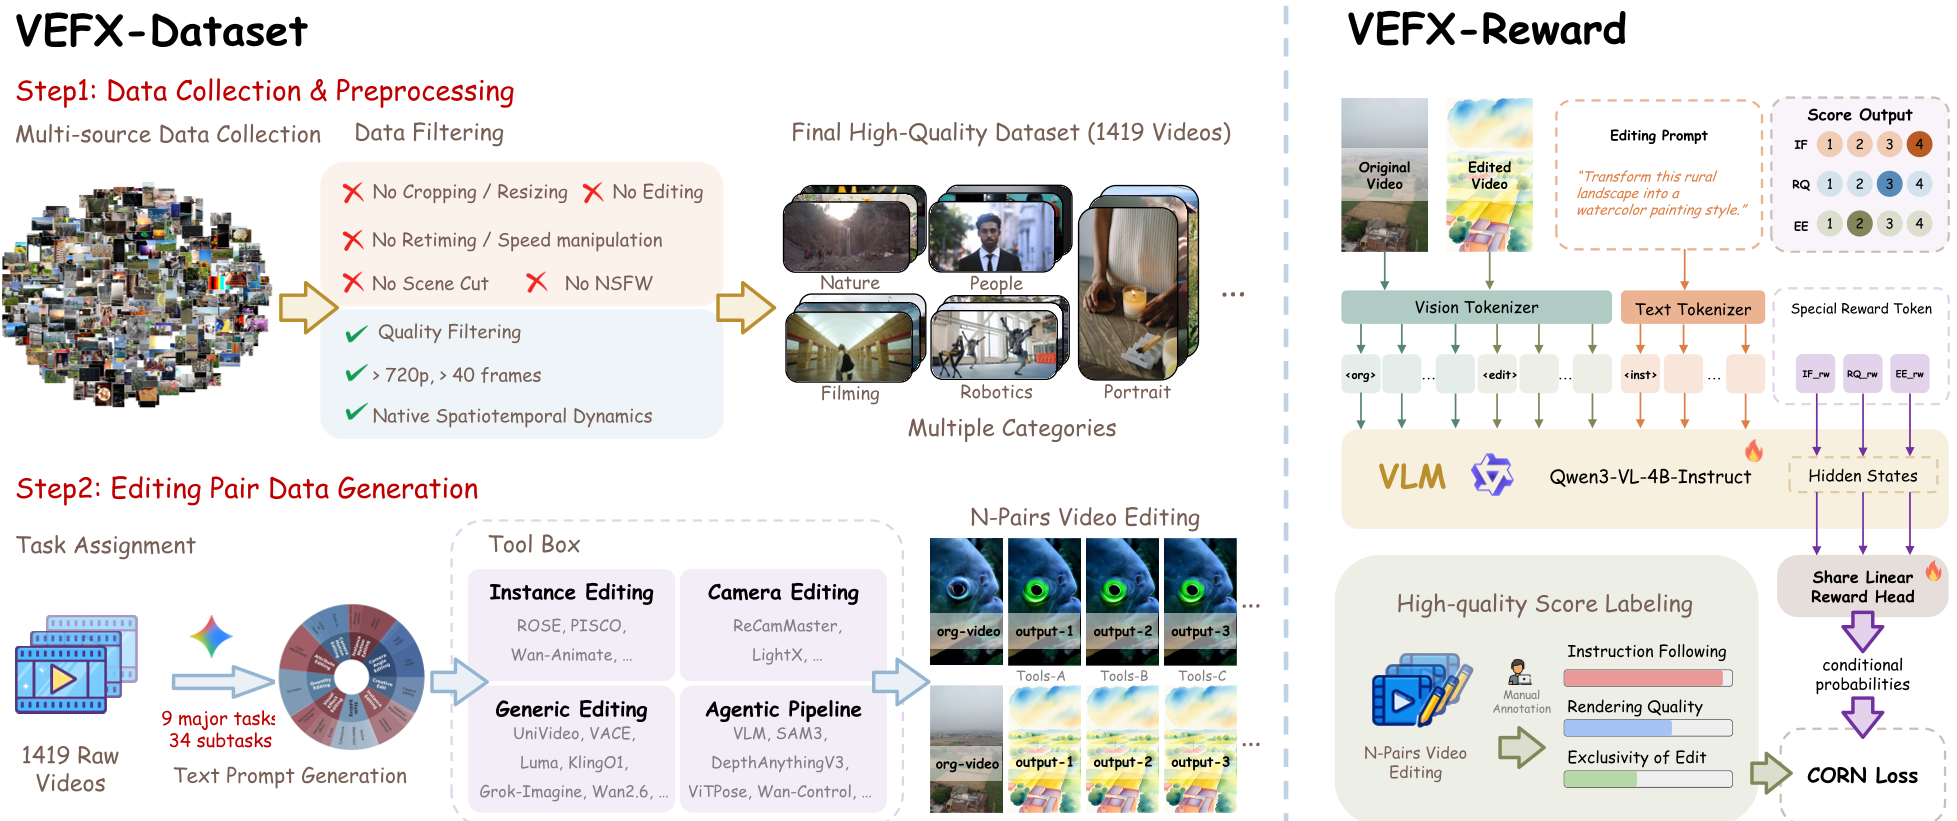
本文推出了 VEFX-Bench,一个针对通用视频编辑与视觉特效(VFX)的深度评测基准。其核心贡献包括:包含 5,049 个精细化人工标注样本的 VEFX-Dataset,专用的多维度奖励模型 VEFX-Reward,以及包含 300 个精讲案例的测试集。
TL;DR
随着 Kling、Luma 和 Runway 等视频生成模型的爆发,视频“重塑”的需求远超“生成”。然而,如何定义一次“成功的编辑”?德克萨斯 A&M 大学等机构的研究者发布了 VEFX-Bench,首次将视频编辑评价拆解为指令遵循 (IF)、渲染质量 (RQ) 和编辑排他性 (EE) 三个维度,并训练了目前最强的人类偏好对齐奖励模型 VEFX-Reward。
核心洞察:评价视频编辑不能只看“好看”
在专业的电影工业或 VFX 工作流中,仅仅生成一段逼真的视频是不够的。现有的 Benchmark(如 VBench)主要关注生成视频的质量,但在编辑场景下,核心矛盾在于:
- 语义鸿沟:模型虽然画得好,但没按我的指令改(IF 失效)。
- 过度编辑 (Over-editing):我只想给人物换件衣服,模型却把背景里的树也变了(EE 失效)。
作者的研究直觉是:必须迫使模型在评价时同时“盯着”源视频和目标视频看,并用专门的逻辑来衡量“改了不该改的地方”所带来的负面反馈。
VEFX-Reward 架构解析
VEFX-Reward 基于 Qwen3-VL 多模态大模型构建。其巧妙之处在于引入了三个特殊的辅助单元:<|IF_reward|>、<|RQ_reward|> 和 <|EE_reward|>。
为什么采用序数回归?
与传统的 L2 回归(预测一个连续值)不同,作者采用了序列阈值判定。模型预测得分是否大于 1、大于 2、大于 3 的概率。这种方法更好地拟合了人类在 1-4 分制下的打分习惯,尤其是在处理“指令完全没遵循(IF=1)”这种极化分布时表现极其稳健。
实验战绩与 SOTA 对比
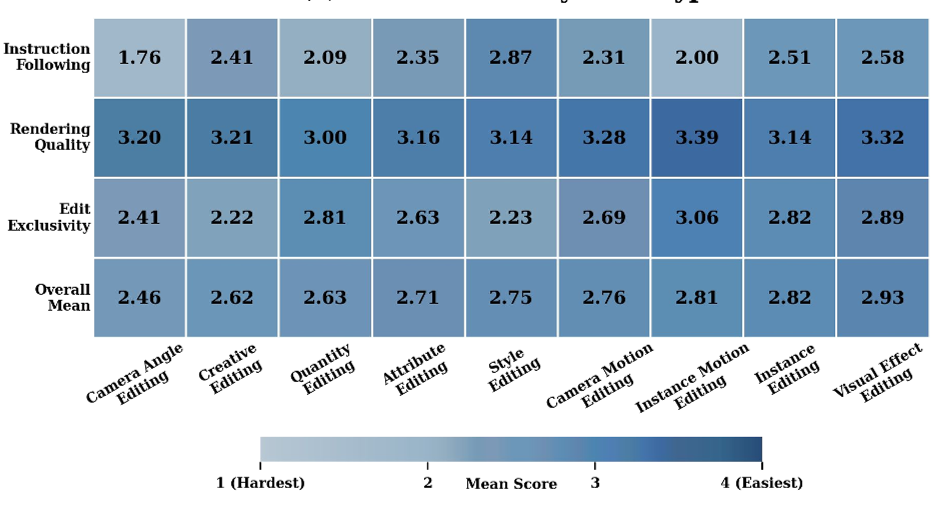
在对目前主流的视频模型(包括 Kling o3, Runway Gen-4.5, Wan 2.6 等)进行“大路测”后,VEFX-Reward 给出了非常残酷的数字:
- 一致性:VEFX-Reward-32B 在 SRCC(斯皮尔曼秩相关系数)上达到 0.780,远超人类偏好模型 EditReward。
- 短板明显:即便最强的 Kling,在 相机角度编辑 (Camera Angle Editing) 上的得分也普遍偏低(IF 仅为 1.76 左右),这反映了当前模型在处理复杂几何变换时的认知力不足。
- 局部性博弈:Style Editing(风格迁移)是最容易刷分的项目,但它往往带来最差的 EE 分数——即模型倾向于全图重绘而非局部修改。
深度思考:未来的研究启示
VEFX-Bench 的发布标志着视频编辑评价从“感性审美”走向“理性工程”。
- 几何一致性是下一关:单纯的扩散模型在像素层面对齐已经很强,但在涉及相机轨迹的 3D 空间编辑上几乎全军覆没。
- RLHF 的新准则:未来的视频编辑模型训练,可以直接将 VEFX-Reward 中的 EE 分数作为惩罚项,以解决模型“爱给自己加戏”的 Over-editing 问题。
总结
VEFX-Bench 不仅仅是一个数据集,它为 AI 辅助创作提供了一把精密的尺子。它告诉我们:好的 AI 剪辑师不仅要会“妙笔生花”,更要懂得“克制”。
更多技术细节可访问项目主页: https://xiangbogaobarry.github.io/VEFX-Bench/