
PV-VAE:从像素重建到世界预测,打造更懂运动的视频 VAE
Video Generation with Predictive Latents
本文提出了 PV-VAE(Predictive Video VAE),一种通过引入“预测性重建”目标来增强视频潜在空间“可扩散性”(Diffusability)的生成模型。该方法在 UCF101 数据集上相比 Wan2.2 VAE 实现了 52% 的收敛加速和 34.42 的 FVD 提升。
TL;DR
传统的视频 VAE 往往陷入“重建越好,生成越难”的怪圈。字节跳动、北大和清华的研究者联合提出 PV-VAE (Predictive Video VAE),通过强迫模型“预测未来”而非仅仅“复现过去”,成功构建了一个具备强大时序先验的潜在空间。该模型在保持高效压缩(16x16 空间,4x 时间)的同时,将视频生成质量(FVD)提升了 34.42 点,并实现了 52% 的训练加速。
痛点深挖:重建 $
eq$ 生成 在 Latent Video Diffusion 时代,VAE 是连接像素世界与潜在空间的桥梁。然而,现有的视频 VAE(如 CogVideoX, Wan2.2)大多遵循“2D 膨胀至 3D”的范式,重点在于减少重构误差。
作者发现一个关键直觉:视频不仅仅是静态帧的堆叠,而是动力学过程的连续演化。 如果 VAE 的潜在空间只学会了存储像素,而没有理解运动规律(Motion Priors),那么后端的 Diffusion 模型就需要花费巨大的计算资源去学习物理规律。
核心逻辑:PV-VAE 的“预测性重建”
为了解决这一问题,PV-VAE 引入了一种简洁而优雅的机制——部分观测,全局预测。
1. 预测性重建架构 (Predictive Reconstruction)
训练过程中,模型会随机丢弃视频后半部分的帧(Maximum Dropping Ratio 可达 100%)。Encoder 只接收前半部分的观测,而 Decoder 必须根据这部分残缺的 Latent 还原出完整的 17 帧视频。
- 物理直觉:这迫使 Encoder 将未来的运动趋势编码进当前的 Latent 中,使 Latent 本身具备了“预测性质”。
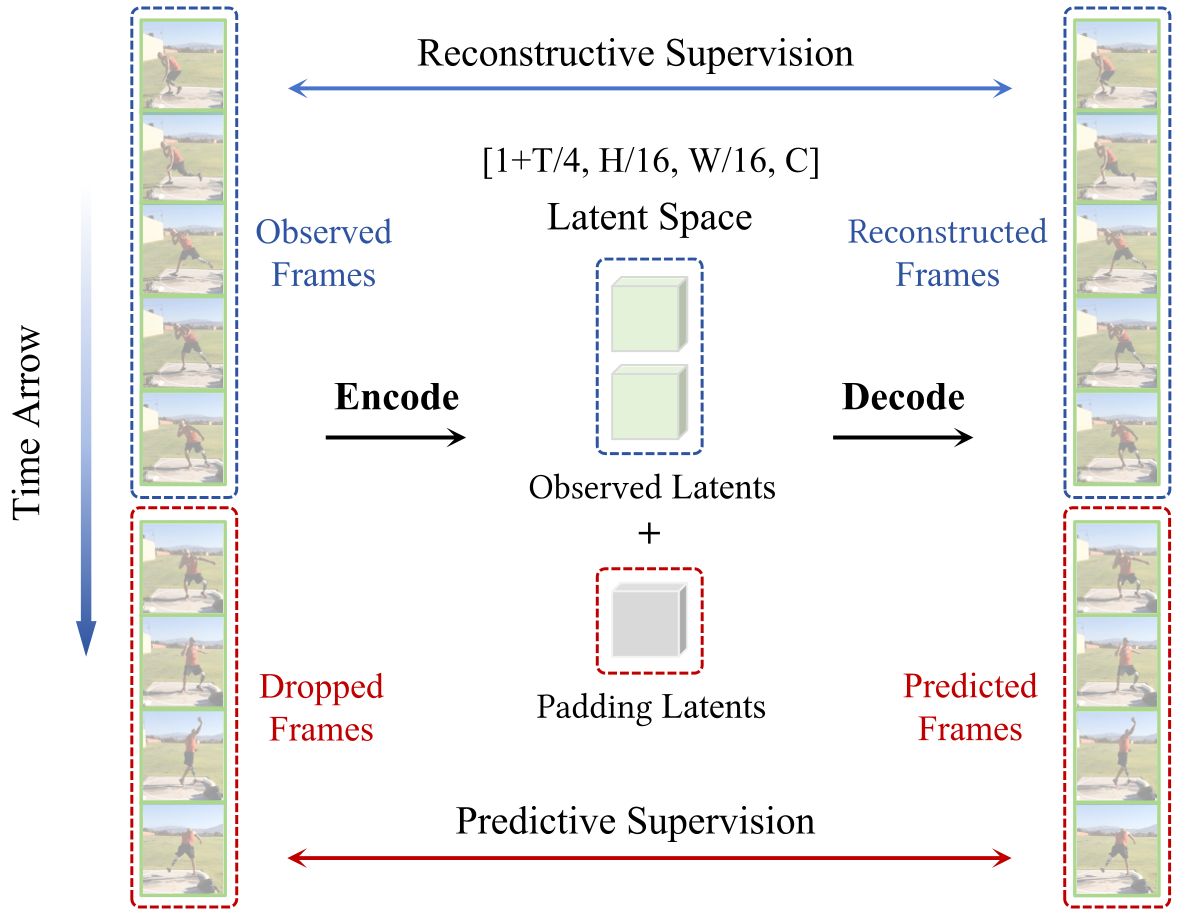 图 1:PV-VAE 总体流程。通过随机掩码未来帧,训练模型同时具备视觉重建与时序理解能力。
2. 运动感知目标 (Motion-aware Objective)
为了防止模型只走“复制粘贴”静态背景的捷径,作者增加了一个约束:模型不仅要重建像素,还要重建相邻帧之间的 像素差值(Temporal Differences)。这确保了模型能够精准过滤背景噪声,聚焦于结构化运动。
实验战绩:全方位的跨越
在 UCF101 类别条件生成任务中,PV-VAE 展现了极强的统治力:
- 生成质量:FVD 达到 146.37,显著优于 SSVAE (168.68) 和 Wan2.2 VAE (180.79)。
- 训练效率:在相同的收敛水平下,训练速度提升 52%,显存占用大幅低于同尺寸模型。
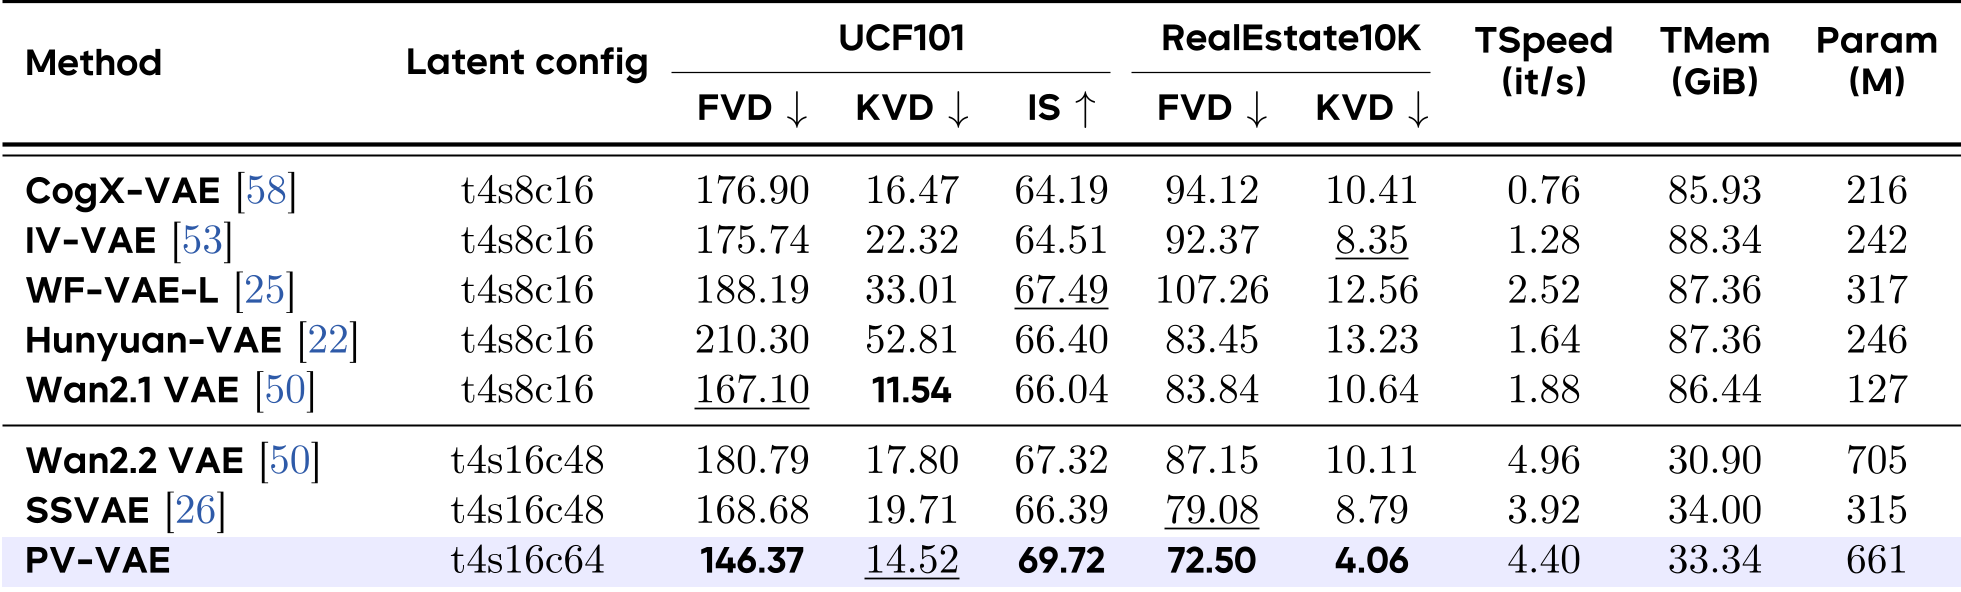 表 1:在 UCF101 和 RealEstate10K 上的生成性能对比,PV-VAE 在 FVD 和效率上均表现卓越。
潜在空间的“超能力”
通过对 Latent 层的可视化分析(PCA),我们能清晰地看到 PV-VAE 对运动区域的敏感度。对应的 Latent 激活区域与光流图(Optical Flow)高度吻合。
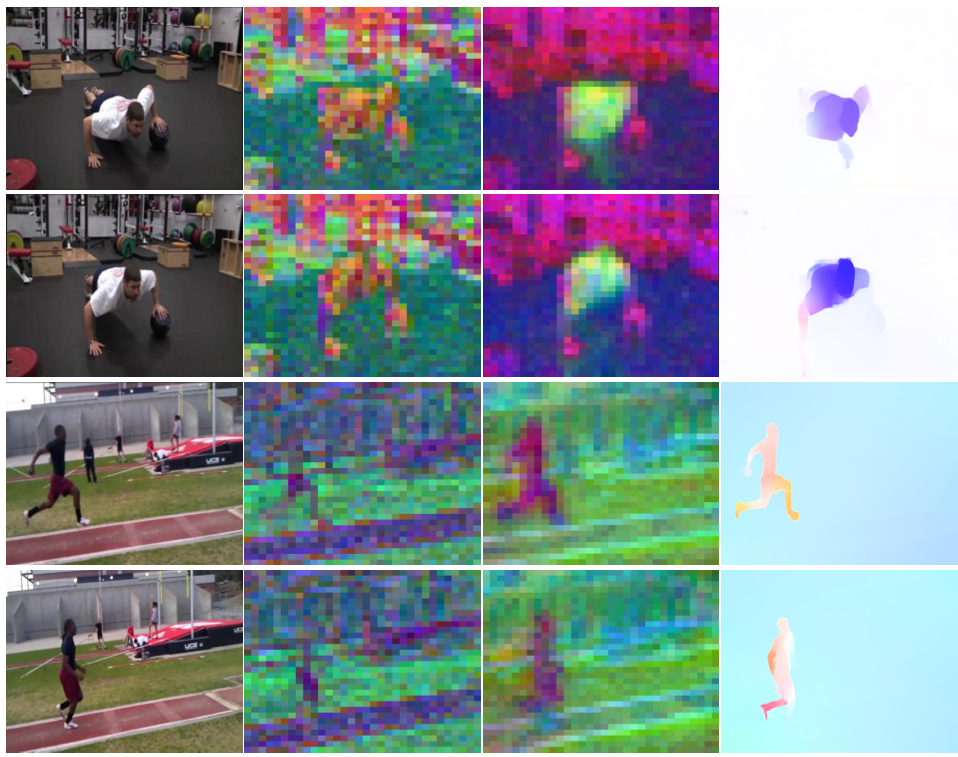 图 2:PCA 可视化显示,PV-VAE 的 Latent 激活模式(第三列)与真实光流(第四列)极其一致,说明其潜在空间已成功捕捉动态显著性。
深度洞察:为什么这很重要?
PV-VAE 的成功证明了,视频 tokenization 不仅仅是数据压缩问题,更是表征学习问题。
- Diffusability 的量化:本文通过预测精度与生成效果的相关性研究,证明了“预测能力强的 Latent 更容易被 Diffusion 模型学习”。
- Transformer VAE 的未来:论文最后讨论了纯 Transformer 架构的 VAE。虽然目前生成效果略逊于卷积架构,但其推理速度提升了 87%,且更利于融合大规模自监督预训练,这可能是下一代视屏生成基础设施的方向。
总结与局限
PV-VAE 通过一个简单的预测目标,实现了视频生成性能的跨越式提升。
- 优势:无需修改原有 Loss 结构,无额外超参数,训练收敛极快。
- 局限:在极端文本密集型(如视频中出现小字)的重建上仍有提升空间。
PV-VAE 的开源无疑为视频生成领域注入了新的思路:不要只教模型“看”,要教它“预判”。
Takeaway: 优秀的潜在空间应该是物理直觉的映射。PV-VAE 的预测机制本质上是在 Latent 层为扩散模型提前“铺好了路”。