
[CVPR 2026] VideoDetective:见微知著,用图扩散算法解锁长视频理解的“上帝视角”
VideoDetective: Clue Hunting via both Extrinsic Query and Intrinsic Relevance for Long Video Understanding
本文提出了 VideoDetective,一个用于长视频理解的推理框架。该方法将视频建模为“视觉-时间亲和图”,通过“假设-验证-细化”循环,利用稀疏观察在图中传播查询相关性信号,实现在有限上下文窗口下精准定位关键视频段,在 VideoMME-long 等基准测试中取得 SOTA 性能。
TL;DR
处理长达一小时的视频,MLLM 必须在“看全”和“看精”之间做权衡。VideoDetective 另辟蹊径,它不强求模型一次性读取全部帧,而是将视频构建成一张时空亲和图(Affinity Graph),通过少量的锚点观察,利用**图扩散(Graph Diffusion)**算法像水滴散开一样预测全片的线索分布。该框架在 VideoMME 上带来了最高 7.5% 的大幅提升,甚至让 20B 规模的开源模型在复杂推理上击败了 GPT-4o。
核心速览:为什么我们定位不到视频线索?
当前长视频理解的痛点在于:
- 上下文太窄:GPU 显存塞不下万级别数量的 Token。
- 局部视角(Locality Bias):现有方法多采用 RAG 或检索模式,这种“一拍两瞪眼”的匹配方式忽略了视频的内在逻辑(例如连续的动作或相似的场景)。如果你只看到了第 10 分钟的一丝线索,传统的检索器可能无法推断出第 12 分钟也极度相关。
VideoDetective 的核心直觉:视频不是离散帧的堆砌,而是具有流形结构(Manifold)的连续体。 通过“窥一斑而知全豹”的图传播,我们可以用极低的采样率找回丢失的线索。
核心机制:假设-验证-细化 (HVR Loop)
VideoDetective 的工作流程像是一个资深的私家侦探:
1. 构建时空亲和图
模型首先将视频切割为语义片段(Nodes),通过以下两个维度建立连接(Edges):
- 视觉亲和力(Visual Affinity):语义相近的片段(即使时间离得远)互相连接。
- 时间亲和力(Temporal Affinity):临近的片段具有天然的逻辑连续性。
2. 三步走推理闭环
- 假设 (Hypothesis):基于问题,先在大致位置投下“侦察兵”(锚点段)。
- 验证 (Verification):对选中的片段进行深度扫描,结合文本识别(OCR)、语音(ASR)和视觉描述(Caption)计算真实的相关性得分。
- 细化 (Refinement):这是最惊艳的一步。利用**流形平滑(Manifold Smoothness)**约束,将确认的相关性分数分发给整个图。如果 A 处有线索,那么图中与 A 关联紧密的 B 处得分也会自动上涨。
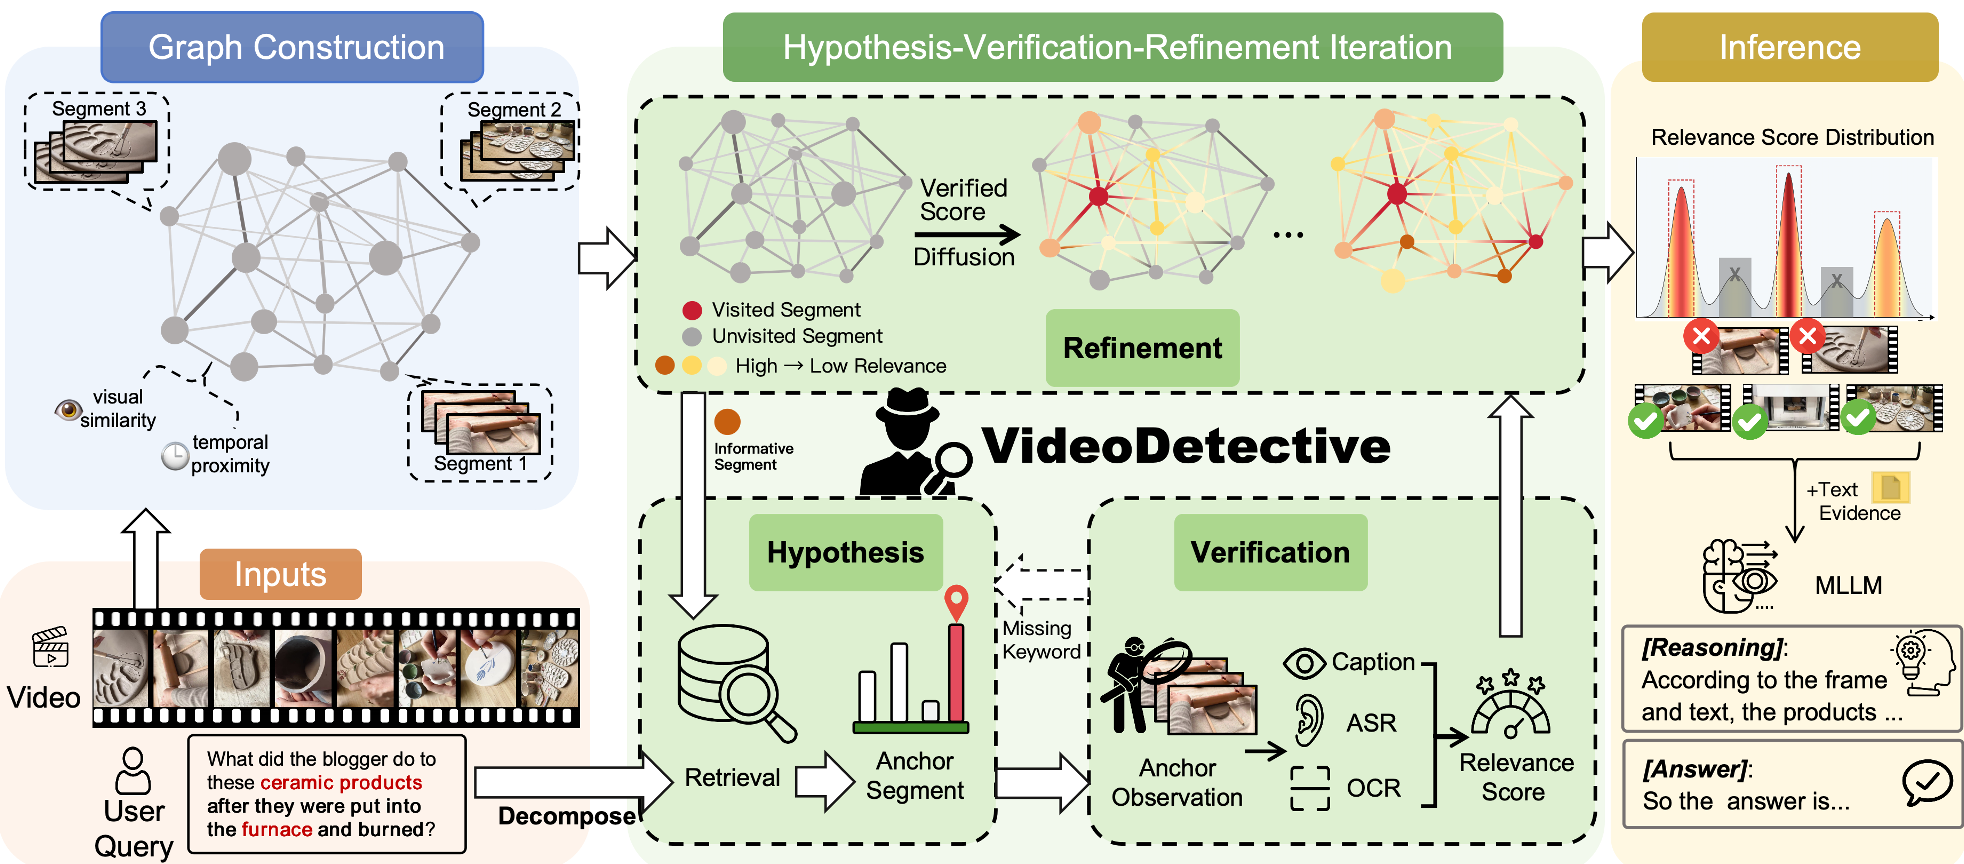 图 1:VideoDetective 整体架构,展示了从图构建到全球信念场(Belief Field)更新的全过程。
实验战绩:开源模型的逆袭
VideoDetective 是一个“即插即用”的插件。实验显示,无论是 InternVL-2.5 还是 Qwen2.5-VL,只要套上这个框架,长视频能力都会迎来暴力增长。
- 性能天花板:在 SeedVL-1.5 (20B) 上,它在 LongVideoBench 达到了 67.9% 的准确率,反超了庞大的 LLaVA-Video-72B 及 GPT-4o。
- Token 效率:如图 3 所示,VideoDetective 在保持 65%+ 准确率的情况下,Token 消耗仅约为 10k,而 GPT-4o 为了达到同等精度需要消耗近 100k 的 Token。
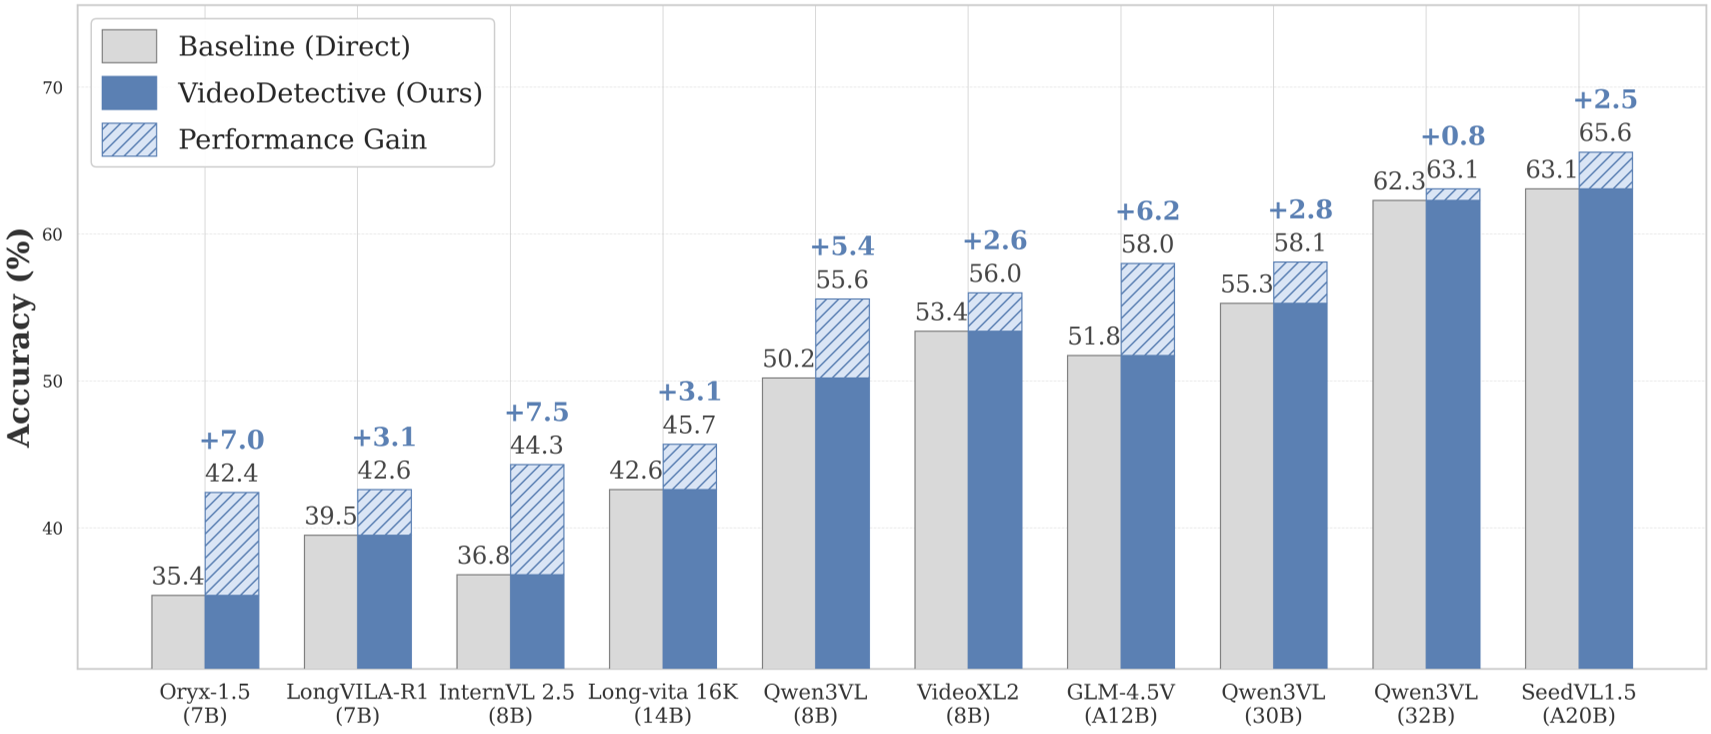 图 2:不同 Backbone 上的性能增益,VideoDetective 展现出极强的普适性。
深度洞察:为什么这种方法有效?
传统的视频处理是“被动”的,模型在输入阶段就被喂入了固定帧。而 VideoDetective 引入了主动推理(Active Inference)。
在消融实验中,作者发现了一个有趣的现象:
- **语义分解(Facet Decomposition)**至关重要:如果直接用原始问题去检索,噪声很大;将问题拆解为多个语义维度(例如:人物 A 做了什么?背景是什么?),能让图传播方向更精准。
- 多源证据的互补性:OCR 和 ASR 在长视频中往往是“定海神针”,能够提供视觉编码器容易忽略的硬信息。
总结与局限
VideoDetective 为长视频理解提供了一种高效、优雅的解法:与其在算力堆砌上死磕,不如用经典的图算法来优化推理逻辑。
局限性:该方法依赖 VLM 自身的“自我反思”能力(即模型需要能判断出“我还需要看更多细节”)。如果基础模型本身连简单的逻辑反馈都做不好,VideoDetective 的迭代链路就会断裂。
未来启示:这一范式预示了未来 MLLM 推理的发展方向——Test-time Scaling(测试时扩缩容)。通过增加推理时的搜索迭代,小模型完全可以补足参数量带来的表征劣势。