
VideoNet:填补大模型在特定领域动作识别中的“进阶”空白
VideoNet: A Large-Scale Dataset for Domain-Specific Action Recognition
本文推出了 VideoNet,一个涵盖 37 个领域、1,000 种动作的大规模特定领域动作识别基准。作者通过自动化流水线收集了 50 万个训练 QA 对,并微调出 Molmo2-4B 模型,在 VideoNet 基准上超越了所有 8B 规模的开源模型(如 Qwen3-VL)。
TL;DR
尽管当前的视觉语言模型(VLM)在各种通用榜单上刷分,但在面对“ triple axel(三周半跳)”和“ triple lutz(勾手三周跳)”这种专业动作时却显得束手无策。本文介绍了 VideoNet,这是一个包含 37 个领域、1000 种专业动作的深度基准测试。研究发现,即使是最强的专有模型(如 Gemini、GPT-5)在面对细粒度动作辩析时也存在巨大挑战,而开源模型更是面临“静态偏见”导致性能低迷。
背景定位:被遗忘的细粒度动作识别
在 VLM 时代,社区过度关注物体识别或简单的时序任务,却忽略了现实世界中具有专业门槛的动作理解。VideoNet 的出现是为了将视觉理解从“感知层”推向“推理层”——它不仅考察模型看到了什么,更考察模型是否理解动作背后的物理逻辑和细微区别。
痛点深挖:为何 VLM 变成了“看图说话”?
通过消融实验,作者揭示了一个残酷的事实:许多所谓具有视频能力的模型,其性能提升主要来自静态背景或物体的识别,而非真正的运动理解(Motion Understanding)。
- 静态偏见 (Static Bias):提供视频的单张中间帧与提供整段视频,许多模型的性能增益微乎其微。
- 视觉上下文学习 (Video ICL) 的崩塌:人类在看到 3 个示例视频后,动作识别率能提升 13.6%,而 VLM 往往会因为冗余的视频上下文而“迷失”,甚至出现性能倒退。
核心方法论:从 Benchmark 到自动数据链
1. 极难的硬负样本 (Hard Negatives) 设计
为了防止模型通过背景“猜题”(例如在篮球场就猜是扣篮),作者使用 LLM 生成了视觉高度相似的动作作为干扰项(如“空中接力扣篮” vs “补篮”),迫使模型必须细查动作细节。
2. 自动化训练流水线
由于聘请各行各业专家标注 50 万条数据成本极高,作者设计了三种自动化策略:
- TranscriptLocalized: 匹配转录文本中出现动作词的时间戳。
- SingleAction: 逻辑推理法,即如果视频标题包含某动作且检测器只发现一段动作片段,则判定该片段为该动作。
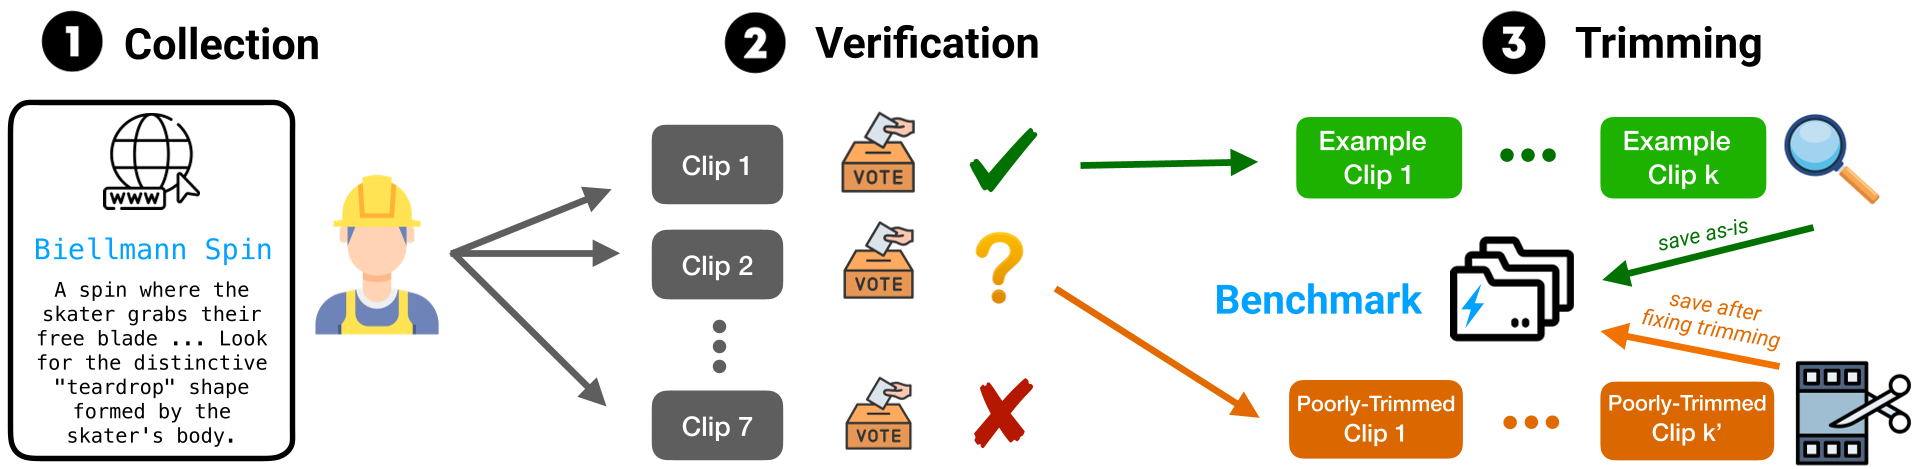 图 1:VideoNet 的基准数据收集流水线,包括视频采集、离群点删除和细粒度修剪。
实验与结果:小模型也能逆袭
实验结果表明,高质量的领域数据对于提升模型能力至关重要。
- 逆袭 8B 选手:仅有 4.4B 参数的 Molmo2 模型在使用本文数据微调(FT)后,在多选题场景下达到 53.5% 的准确率,远超 8B 规模的 Qwen3-VL 和 InternVL3.5。
- 人类 vs 模型:即使是非专家的人类用户,在有 3-shot 示例的情况下也能达到 82.7% 的准确率,而模型依然徘徊在 70% 左右,显示出 VLM 在 Video ICL 上的巨大潜能待挖掘。
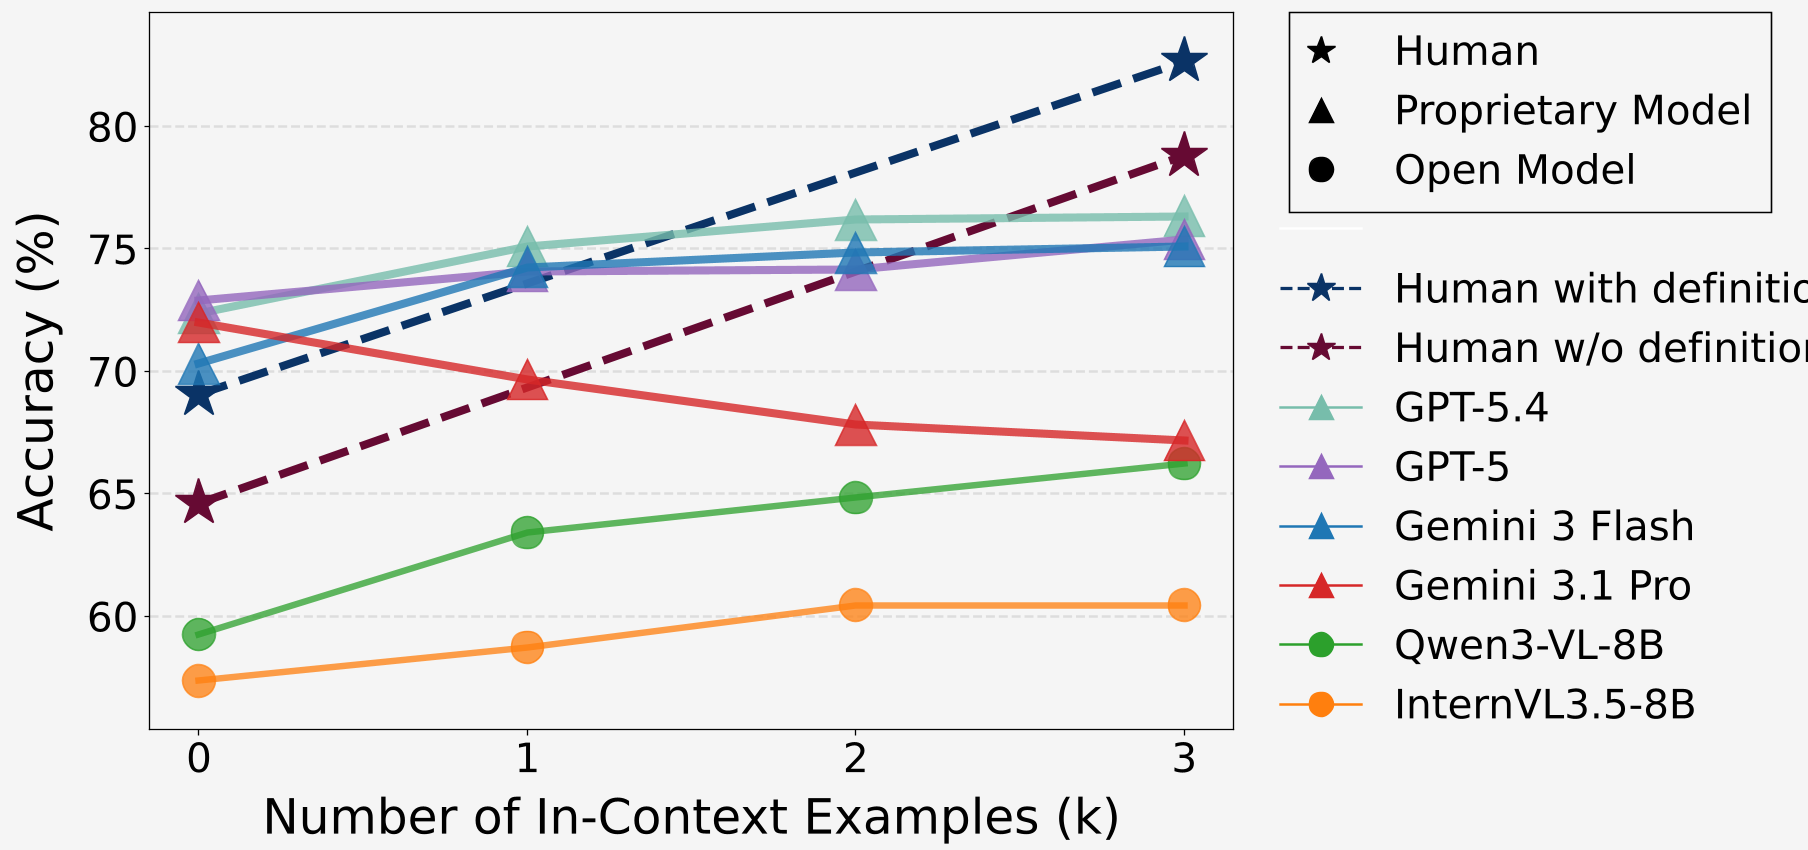 图 2:二进制 Few-shot 准确率对比。可以看出,随着示例增加,人类表现(虚线)稳步上升,而模型(实线)的利用效率极低。
深度洞察与总结
核心贡献 (Takeaway)
- 数据先行:证明了开源模型在特定领域表现不佳并非架构不行,而是训练混合物中极度缺乏细粒度动作数据。
- ICL 困局:揭示了当前 VLM 对视频长上下文的处理依然原始,无法像人类一样精准捕捉跨视频的共有特征。
局限性与未来展望
尽管 VideoNet 提供了多样化的领域,但对于极长序列(超过 5 分钟)的动作识别仍受限于当前 LLM 的 Token 负载。未来的研究应当探索如何让模型更“关注动能(Kinetic)”而非仅仅是“像素”。
VideoNet 为未来的视觉感知引擎提供了一面镜子,提醒我们:真正的自然语言理解,必须根植于对世界运动本质的精确洞察。