
[CVPR 2025] VIKEY:给视频帧打上“页码”,让 VideoLLM 秒懂时序逻辑
ViKey: Enhancing Temporal Understanding in Videos via Visual Prompting
本文提出了 VIKEY,一种旨在提升视频大语言模型(VideoLLMs)时序理解能力的轻量级插件框架。该方法通过在视频帧上叠加数字索引作为“视觉提示(Visual Prompting)”,并配合关键字-帧映射(Keyword-Frame Mapping, KFM)机制,在不增加训练成本的前提下,显著增强了模型在稀疏采样条件下的时序推理性能。
TL;DR
在视频处理中,抽帧(Sampling)是节省计算资源的基操,但也是时序理解的“杀手”。来自延世大学的研究团队近日提出了 VIKEY,通过在视频帧像素上简单叠加序号(Visual Prompting),不仅让模型找回了丢失的时间感,还实现了在 20% 极低采样率下反超全量数据的惊人效果。更重要的是,这是一个 Training-free(无需训练)、Plug-and-play(即插即用) 的轻量级设计。
痛点深挖:消失的时间线
人类观看断断续续的幻灯片也能脑补出故事情节,但 VideoLLMs 却不行。
- 时序断裂:当中间帧被移除,模型接收到的是离散的视觉片段,难以重建连续的因果关系。
- 位置模糊:虽然 Transformer 有 RoPE(旋转位置编码),但在处理长序列时,模型往往分不清第 5 帧和第 50 帧的区别,尤其是在跨模型迁移时。
- 引用无力:当用户问“在踢球之前发生了什么?”,模型很难在脑内建立“动作”到“具体帧索引”的映射。
核心机制:VIKEY 的“两把板斧”
1. 像素级的时序导航:Sequential Visual Prompting
作者的操作简单而暴力:直接在每一帧的像素空间(通常是左下角,因为 bias 研究发现模型更关注下方)印上“frame #0x”。这种做法直接绕过了复杂的内部 Embedding 修改,让模型通过视觉编码器直接“看到”时间。
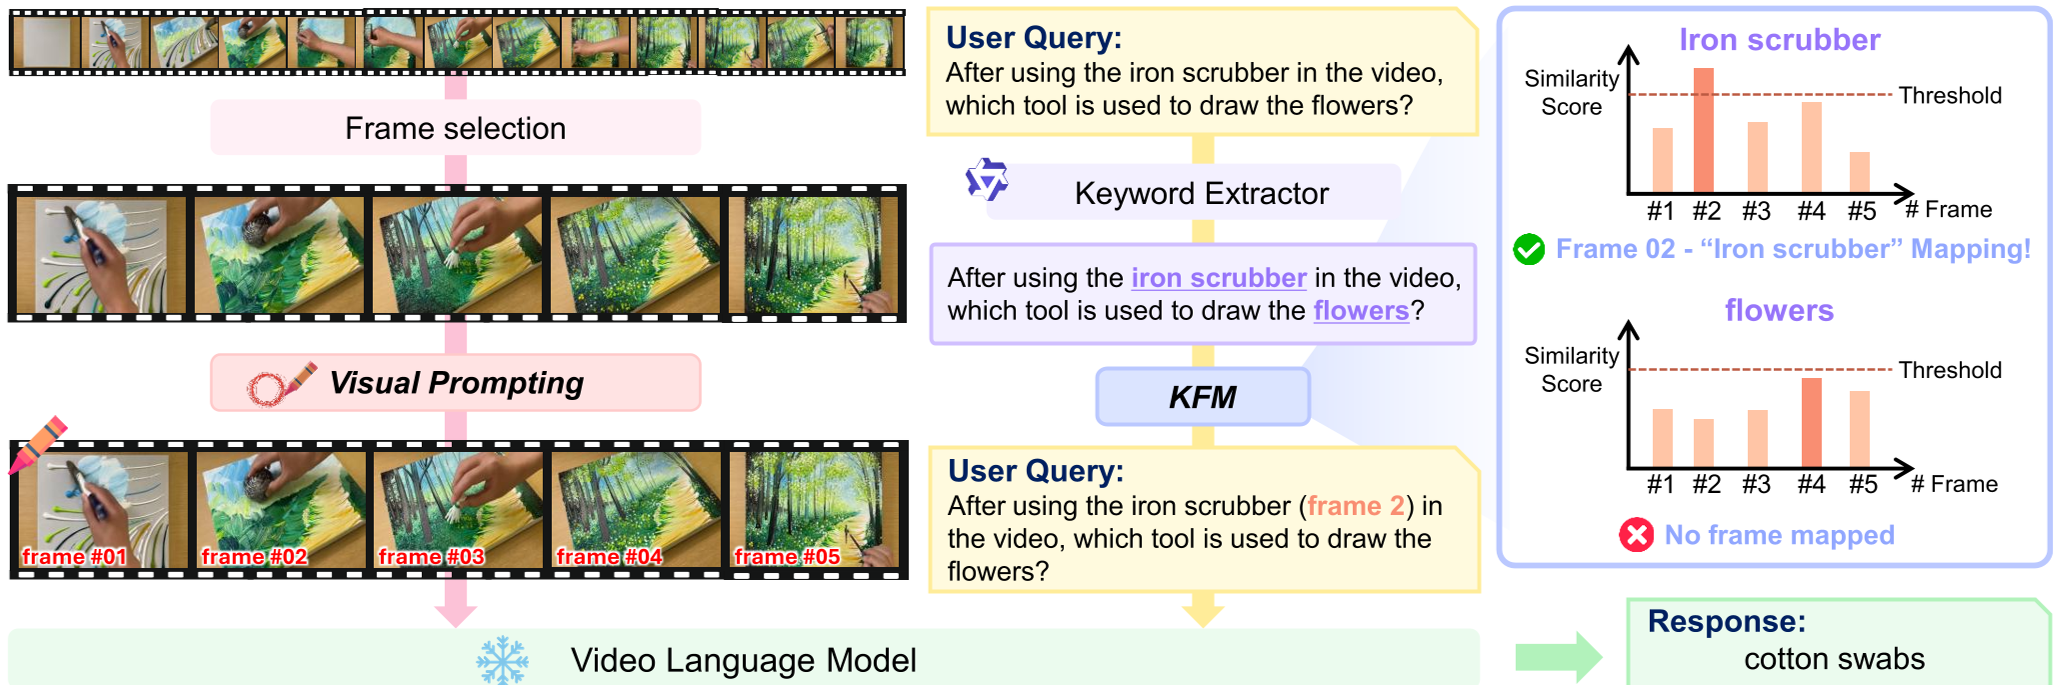 图 1:VIKEY 总体架构,展示了从视觉标注到关键字映射的全流程。
2. 精准打击:Keyword-Frame Mapping (KFM)
为了回答复杂问题,VIKEY 包含了一个基于字典查找逻辑的模块:
- 提取关键字:利用 LLM 提取查询中的关键词(如“打翻杯子”)。
- 跨模态匹配:利用 CLIP 将关键词与所有帧对比,找到最匹配的那一帧。
- 重写 Prompt:在发给模型的最后指令中加入:“请查看第 5 帧中打翻杯子的场景”。
实验与结果:少即是多
实验最震撼的一点在于:稀疏胜过浓密。 在 VideoMME 数据集上,VIKEY 在 20% 采样率下的准确度甚至高于 100% 采样率的 Baseline。这说明,冗余的帧反而会给模型带来噪音,而通过带标注的精简帧,模型能更专注地进行时序推理。
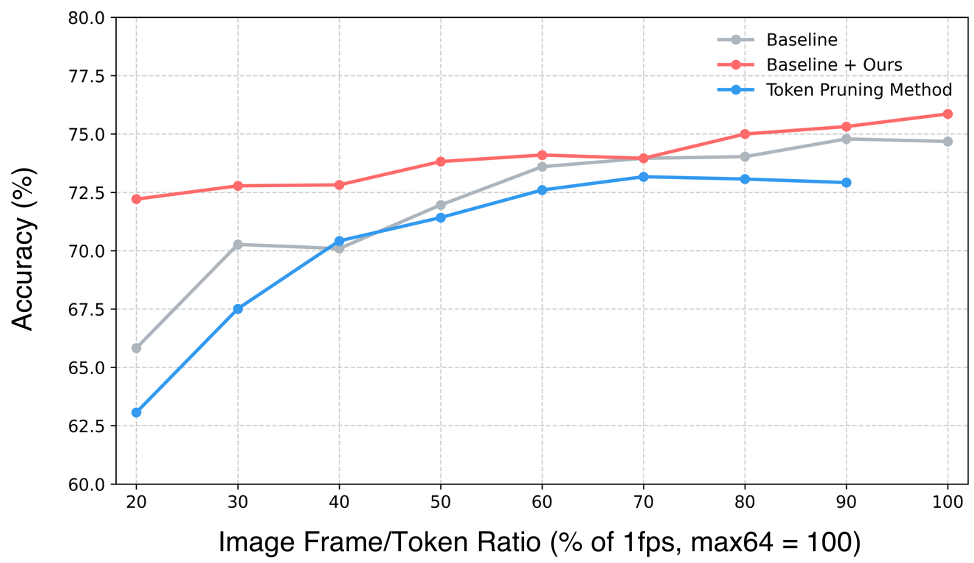 图 2:不同采样率下的性能曲线。VIKEY(蓝色虚线)始终显著高于 Baseline。
深度洞察:为什么有效?
- 注意力偏移:分析发现,加入视觉提示后,文本 Token 对图像 Token 的注意力平均提升了 11.65%。模型不再是“瞎猜”,而是真的在“看”图。
- 字典效应:模型能够像查字典一样,通过 frame number 这个 key,快速定位到对应的场景 value。
总结与讨论
VIKEY 的成功启示我们:在大模型时代,改变输入表征(Input Representation) 往往比 修改模型架构(Architecture Change) 更加高效且优雅。
局限性:
- 遮挡问题:固定的标注位置偶尔会遮挡视频中的关键小物体。
- 相似帧困境:如果视频中有多组极其相似的帧(如静态背景),CLIP 可能会映射到错误的序号。
展望: 未来可以探索基于视觉显著性(Visual Saliency)的动态标注位置,或者引入更强的序列感知相似度算法来解决重复帧问题。总的来说,VIKEY 为目前深陷“长序列计算陷阱”的视频研究者打开了一扇新的窗户。