
VISD:打破视频推理瓶颈,结构化自蒸馏实现 2x 训练加速
VISD: Enhancing Video Reasoning via Structured Self-Distillation
本文提出了 VISD,一种专为视频推理设计的结构化自我蒸馏(Structured Self-Distillation)框架。通过引入视频感知裁判模型(Video-aware Judge)生成多维度结构化反馈,并结合“方向-幅值脱钩”机制,在多个视频推理基准(如 Open-o3-Video, Video-MME-v2)上实现 SOTA,且收敛速度提升近 2 倍。
Executive Summary
在多模态大模型的演进中,**视频推理(Video Reasoning)**始终是一块硬骨头。不同于静态图片,视频理解要求模型在动态演进的视觉流中,实现精确的时间步对齐与空间定位。
最近,来自清华、北大、武大等高校的研究团队提出了 VISD (Video Structured Self-Distillation)。该方法的核心直觉是:并非所有的错误都是平等的。在视频问答中,一个错误的答案可能是因为逻辑推导错了,也可能是因为看错了时间戳或认错了物体。VISD 通过引入一个“视频感知裁判”来产生结构化的诊断反馈,并巧妙地将其转化为 Token 级别的更新权重。实验结果表明,VISD 不仅显著提升了时空对齐的精度,更将训练收敛速度提升了近一倍。
为什么要“结构化”?现有方法的痛点
目前的 VideoLLM 训练主要依赖强化学习(RLVR),通过验证答案的正确性给予奖励。
- 痛点 1:奖励稀疏性。对于长达数百个 Token 的推理轨迹,只有一个标量奖励(如 0 或 1),模型很难知道到底是哪一句话说错了,还是哪个时间区间定位偏了。
- 痛点 2:诊断缺失。现有的自蒸馏方法通常让学生去模拟教师的输出分布,但这是一种“盲目”的跟随,缺乏对视频特有误差(如时空漂移)的针对性修正。
VISD 核心机制:方向与幅值的“二元论”
VISD 的精妙之处在于它处理自蒸馏信号与强化学习信号冲突的方式。
1. 结构化特权信息生成
作者引入了一个功能强大的 Video-aware Judge。它不直接参与推理,而是站在“上帝视角”,对比学生输出、标准答案和隐藏的时空证据(Grounding Evidence),生成包含以下维度的反馈:
- 答案正确性
- 推理连贯性
- 时空对齐质量(是否在错误的时间窗寻找物体)
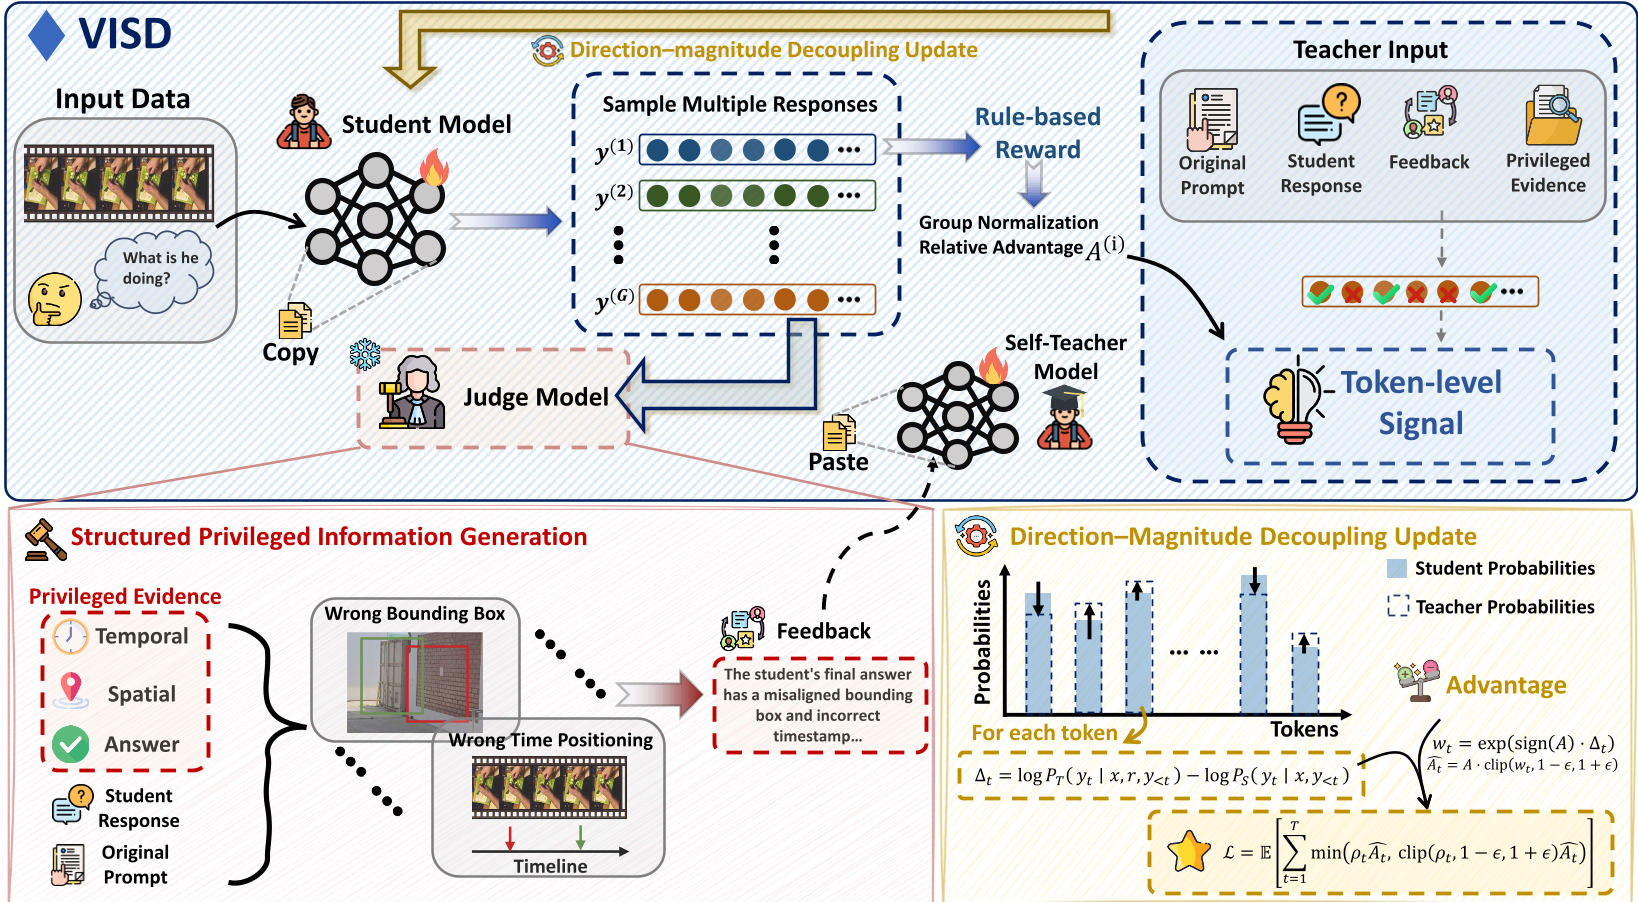 图 1:VISD 框架概览。裁判生成反馈,教师通过反馈进行重放(Replay),指导学生更新。
2. 方向-幅值脱钩 (Direction-Magnitude Decoupling)
为了稳定训练,VISD 提出了一个创新的更新准则:
- 更新方向(Direction):由 Rollout 级别的 Advantage 决定。如果这整条路径是对的,就加强它;如果是错的,就抑制它。这保证了模型始终朝着“完成任务”的大方向优化。
- 更新幅值(Magnitude):由教师-学生分布的差异 决定。如果教师认为某个 Token 是关键的正确步骤,则加大该步的更新权重。
这种设计避免了辅助信号误导模型主攻方向,同时在 Token 级别实现了极度精细的“信用分配”。
实验战果:更准、更快
研究团队在 Open-o3-Video 和 Video-MME-v2 等公认的高难度榜单上测试了 VISD。
1. 精度全面跨越
在 V-STAR 基准测试中,VISD 在“何时(When)”和“何处(Where)”两个时空维度上的表现远超 baseline。相比强基座 Qwen2.5-VL-7B,其 mAM 分数提升了 15.8 个点。
2. 训练效率极度舒适
这是 VISD 最令人印象深刻的数据:它仅需约 1200 步 优化,就能超越那些训练了 2300 步 以上的最强基线模型(如 VisionCoach)。
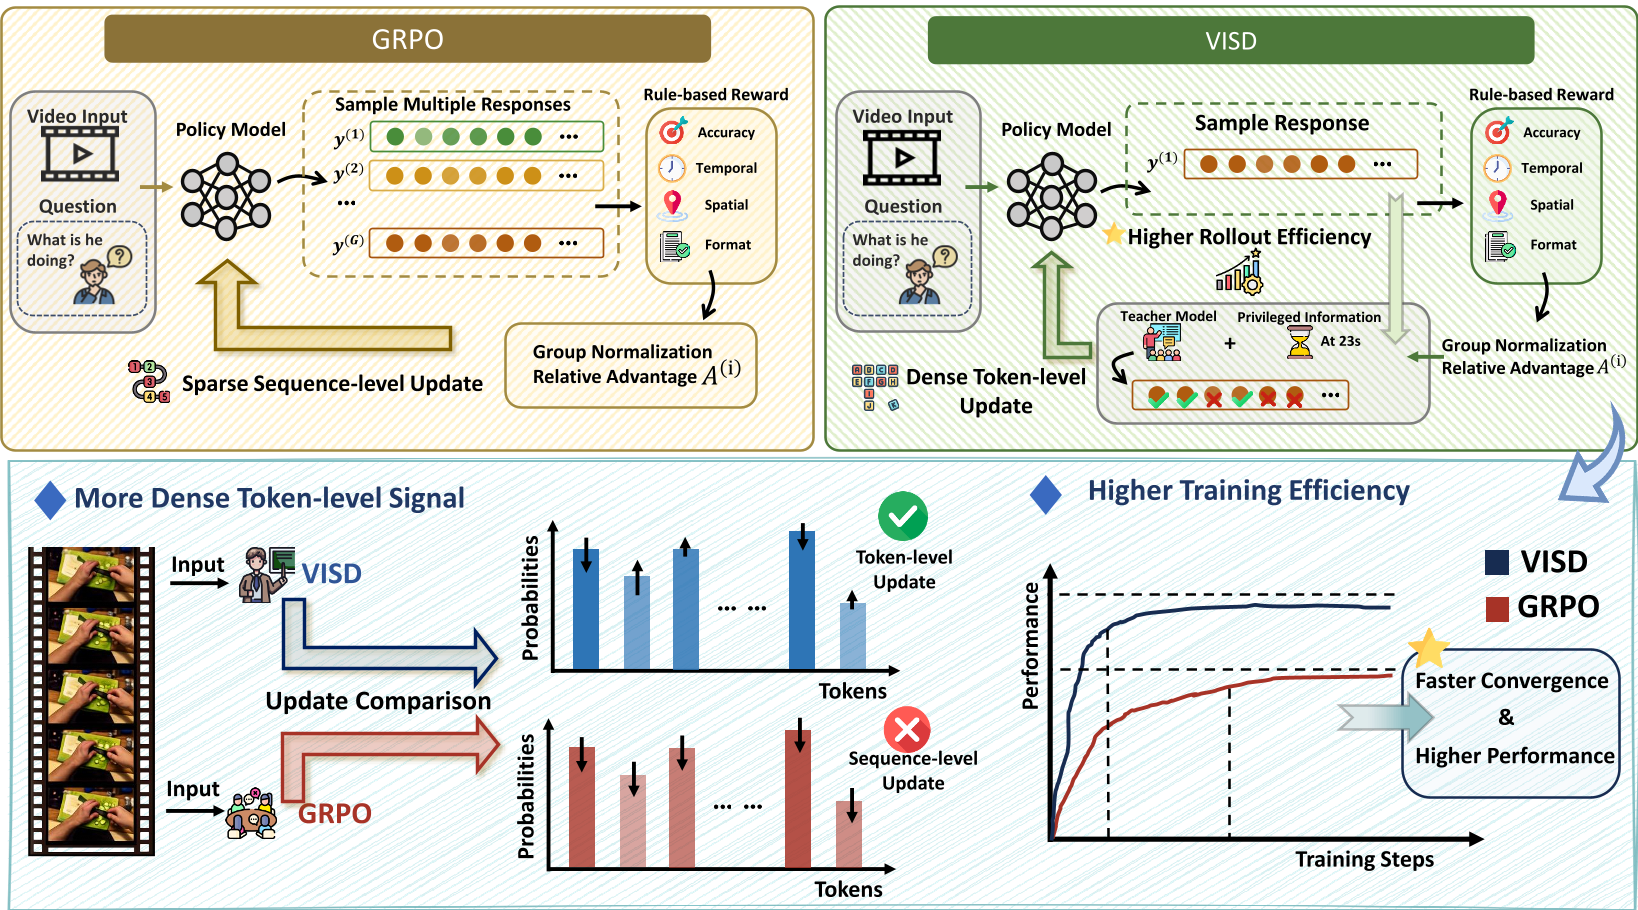 图 2:训练曲线对比。VISD(蓝色曲线)相比传统 GRPO 展现出更陡峭的上升趋势和更高的最终奖励。
深度洞察:为什么 EMA 教师和 Top-K 采样很重要?
在消融实验中,作者揭示了两个关键的技术细节:
- EMA 教师:使用指数移动平均(EMA)更新教师模型,可以过滤掉因学生模型剧烈波动带来的高频噪声,让蒸馏信号更平滑。
- Top-K 局部支持:在计算教师和学生差异时,不只看当前采样的那一个 Token,而是在 Top-K 候选集内进行归一化。这使得教师能提供具有分布意义的指导,而不仅仅是一个单点的纠偏。
总结与启示
VISD 展示了一种多模态训练的新思路:与其让 RL 盲目摸索,不如让专家(Judge)告诉它每一步错在哪里,并把这种诊断转化为权重。
这种结构化反馈机制不仅适用于视频推理,未来也有潜力扩展到复杂的具身智能(Embodied AI)任务或长程代码生成中。对于正在攻克 Open-ended 视频理解的开发者来说,VISD 提供的“方向-幅值脱钩”策略无疑是一件极具参考价值的利器。
局限性
尽管表现出色,但 VISD 依然高度依赖于强大的 Judge 模型(如 GPT-4o 或 GPT-5 等级),如何实现低成本、本地化的 Judge 模型将是未来的关键研究方向。